

Now vibe coding, so learning hammer FE ?
《十个防止 AI 代码泛滥的前端项目护栏》
标签:
#前端 #TypeScript #React #AI编程 #代码质量 #ESLint #测试策略 #CI_CD #代码审查 #工程实践
总结:
本文针对 AI 生成代码速度远超人类审查能力的前端项目,提供了一套实用的十项防护清单。核心思路是通过自动化工具链(类型系统、Linter、变异测试、CI 门禁)在代码合并前拦截机械性错误,而非依赖人工逐行审查。
文章要点:
1. 用 OpenAPI 契约替代手写类型:通过 Hey API 等工具从 OpenAPI 规范直接生成 TypeScript 类型、客户端和 Zod 校验,避免 AI 臆造不存在的 API 字段(如
2. 开启严格 TypeScript 配置:启用
3. 把 Linter 当作行为过滤器:使用 SonarJS、react-you-might-not-need-an-effect、vitest/playwright 插件、jsx-a11y 等 ESLint 插件,自动拦截认知复杂度过高、不必要的 Effect、可访问性违规等问题。
4. 设定架构层边界:使用 eslint-plugin-boundaries 或 dependency-cruiser 强制实施分层架构(如 UI 层不得直接访问 API 层),防止 AI 生成的代码逐渐退化为"GitHub 平均水平"的混乱结构。
5. 将重复出现的错误转化为自定义 Linter 规则:当同一种 bug 第二次出现时,立即编写自定义 ESLint 规则禁止该模式。例如禁止在服务层函数中使用
6. 把规则直接喂给 AI 模型:通过项目规则文件(如
7. 用变异测试验证测试有效性:使用 Stryker 故意破坏代码(翻转运算符、反转条件、交换返回值),检查现有测试是否能捕获这些变异。存活的变异体通常暴露"只测形状不测内容"的无效测试。一个项目约 4,700 个变异体在 6 分钟内完成扫描。
8. 用 Knip 清理死代码:Knip 可以检测未使用的文件、导出和依赖,配合自定义可达性脚本填补其盲区,防止 AI 生成大量"以防万一"却无人调用的冗余代码。
9. 用 jscpd 检测重复代码:AI 倾向于在不同地方生成几乎相同的逻辑,jscpd 能发现这些重复,提示抽象机会或错误的复制粘贴。
10. 将所有检查强制设为 CI 门禁:上述所有工具(类型检查、Lint、测试、变异测试、重复检测)必须作为 CI 的强制通过项,而非可选建议,确保 AI 生成的代码无法绕过质量关卡。
11. 成本与局限:这些护栏会产生噪音(误报)、规则过时和新人上手摩擦等成本,建议按"类型 → Lint → 测试 → CI"的顺序渐进式推行。同时需注意,这些检查只能捕获机械性错误,无法识别糟糕的品味或错误的抽象。
URL:
https://evilmartians.com/chronicles/ten-anti-ai-slop-moves-for-frontend-projects-going-faster-than-humans-can-review
标签:
#前端 #TypeScript #React #AI编程 #代码质量 #ESLint #测试策略 #CI_CD #代码审查 #工程实践
总结:
本文针对 AI 生成代码速度远超人类审查能力的前端项目,提供了一套实用的十项防护清单。核心思路是通过自动化工具链(类型系统、Linter、变异测试、CI 门禁)在代码合并前拦截机械性错误,而非依赖人工逐行审查。
文章要点:
1. 用 OpenAPI 契约替代手写类型:通过 Hey API 等工具从 OpenAPI 规范直接生成 TypeScript 类型、客户端和 Zod 校验,避免 AI 臆造不存在的 API 字段(如
user.fullName),让编译器在构建期就报错。2. 开启严格 TypeScript 配置:启用
noUncheckedIndexedAccess 等严格标志,让数组索引访问返回 T | undefined,迫使代码显式处理边界情况,减少 AI 常见的"想当然"代码。3. 把 Linter 当作行为过滤器:使用 SonarJS、react-you-might-not-need-an-effect、vitest/playwright 插件、jsx-a11y 等 ESLint 插件,自动拦截认知复杂度过高、不必要的 Effect、可访问性违规等问题。
4. 设定架构层边界:使用 eslint-plugin-boundaries 或 dependency-cruiser 强制实施分层架构(如 UI 层不得直接访问 API 层),防止 AI 生成的代码逐渐退化为"GitHub 平均水平"的混乱结构。
5. 将重复出现的错误转化为自定义 Linter 规则:当同一种 bug 第二次出现时,立即编写自定义 ESLint 规则禁止该模式。例如禁止在服务层函数中使用
Math.round 和 toFixed,避免双重取整导致的薪资计算错误。6. 把规则直接喂给 AI 模型:通过项目规则文件(如
.cursor/rules、CLAUDE.md)或技能文件(如 react-doctor),将项目约定、架构决策和禁止模式直接提供给 AI,让模型在生成代码时就遵循规范。7. 用变异测试验证测试有效性:使用 Stryker 故意破坏代码(翻转运算符、反转条件、交换返回值),检查现有测试是否能捕获这些变异。存活的变异体通常暴露"只测形状不测内容"的无效测试。一个项目约 4,700 个变异体在 6 分钟内完成扫描。
8. 用 Knip 清理死代码:Knip 可以检测未使用的文件、导出和依赖,配合自定义可达性脚本填补其盲区,防止 AI 生成大量"以防万一"却无人调用的冗余代码。
9. 用 jscpd 检测重复代码:AI 倾向于在不同地方生成几乎相同的逻辑,jscpd 能发现这些重复,提示抽象机会或错误的复制粘贴。
10. 将所有检查强制设为 CI 门禁:上述所有工具(类型检查、Lint、测试、变异测试、重复检测)必须作为 CI 的强制通过项,而非可选建议,确保 AI 生成的代码无法绕过质量关卡。
11. 成本与局限:这些护栏会产生噪音(误报)、规则过时和新人上手摩擦等成本,建议按"类型 → Lint → 测试 → CI"的顺序渐进式推行。同时需注意,这些检查只能捕获机械性错误,无法识别糟糕的品味或错误的抽象。
URL:
https://evilmartians.com/chronicles/ten-anti-ai-slop-moves-for-frontend-projects-going-faster-than-humans-can-review
《Git Worktrees 入门指南:把分支变成平行工作空间》
标签:#Git #工作流 #AI辅助编程 #开发工具 #分支管理
总结:
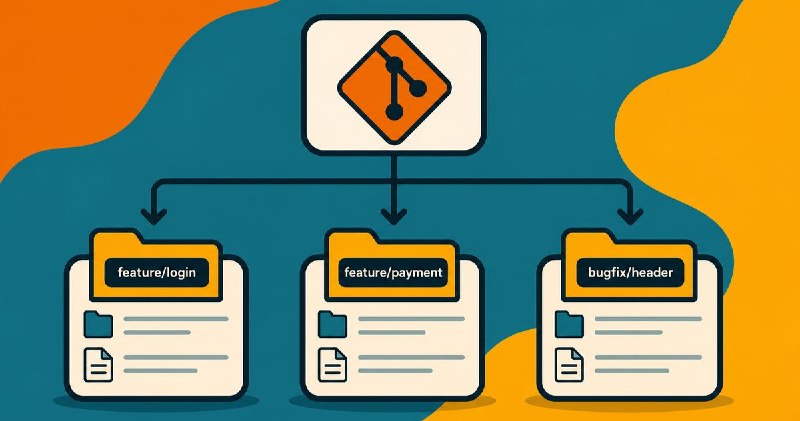
Git worktrees 是一个被低估十年的功能,它将分支检出到独立目录而非项目根目录,让开发者能在同一仓库中并行处理多个任务。文章从基础命令讲起,演示了如何创建、管理和清理 worktree,特别强调了它在 AI 编码代理时代的新价值——多个智能体可在独立工作树中自主工作互不干扰,完成后合并回主仓库,无需将代码推送到云端即可实现并行开发。
文章要点:
1. Worktree 的本质就是"检出到不同目录的分支",它共享完整提交历史,能正常推拉远程,唯一区别是文件物理位置不同
2. 创建命令
3. 目录组织有两种风格:与主仓库平级的直接兄弟目录,或统一放在
4. 合并变更既可以通过常规的 push + PR 流程,也可以在本地用 rebase 后 merge;清理时用
5.
6. 核心价值在于"本地并行":AI 编码工具现在常用 worktrees 让多个代理同时修改代码,既避免了分支切换的上下文丢失,也省去了云端暂存的麻烦
URL:https://humanwhocodes.com/blog/2026/07/introduction-git-worktrees/
标签:#Git #工作流 #AI辅助编程 #开发工具 #分支管理
总结:
Git worktrees 是一个被低估十年的功能,它将分支检出到独立目录而非项目根目录,让开发者能在同一仓库中并行处理多个任务。文章从基础命令讲起,演示了如何创建、管理和清理 worktree,特别强调了它在 AI 编码代理时代的新价值——多个智能体可在独立工作树中自主工作互不干扰,完成后合并回主仓库,无需将代码推送到云端即可实现并行开发。
文章要点:
1. Worktree 的本质就是"检出到不同目录的分支",它共享完整提交历史,能正常推拉远程,唯一区别是文件物理位置不同
2. 创建命令
git worktree add ../project.worktrees/feature-name -b feature/name main 会在指定目录新建分支,但依赖需要重新安装(如 node_modules 不共享),且该分支在 worktree 存在时无法在别处检出3. 目录组织有两种风格:与主仓库平级的直接兄弟目录,或统一放在
.worktrees 共享父目录下;后者更整洁,尤其适合 AI 代理批量创建工作树4. 合并变更既可以通过常规的 push + PR 流程,也可以在本地用 rebase 后 merge;清理时用
git worktree remove 删除目录但保留分支,确认无用后再 git branch -d 删除分支5.
git worktree list 能查看所有工作树状态,配合 git config --global alias.wt worktree 设置别名后,整个工作流(创建、查看、移除)都能用简短的 wt 命令完成6. 核心价值在于"本地并行":AI 编码工具现在常用 worktrees 让多个代理同时修改代码,既避免了分支切换的上下文丢失,也省去了云端暂存的麻烦
URL:https://humanwhocodes.com/blog/2026/07/introduction-git-worktrees/
《现代工程价值观:AI 时代的效率与品味》
标签:#软件工程 #AI编程 #代码审查 #团队管理 #技术栈 #开发者体验 #工程管理
总结:
作者 Christoph Nakazawa(cpojer)分享了他近半年完全依赖 AI 编码代理完成多个项目的实战经验,指出编程已从"手写代码"转向"指挥系统生成代码"。文章提炼了 AI 时代仍至关重要的五大工程价值观:强所有权、品味至上、严格约束与快速反馈、代码库即上下文、掌控技术栈,并强调管理需更技术化。作者用数据证明效率提升 3 倍,认为未来瓶颈不再是写代码,而是判断力与品味。
文章要点:
1. **AI 编码已成常态**:作者过去数月多个项目(Vite+、fate、Codiff、Athena Crisis 等)90%-100% 由 AI 编写,代码质量甚至超越手写,且能在几分钟内完成过去数周的工作
2. **Codex CLI 是最佳搭档**:使用 GPT 5.5 high 配合 Codex CLI,配合"先写失败测试再修复"的策略,能极大提高一次性正确率;多项目并行时建议每个项目独立窗口,利用空间记忆提升效率
3. **强所有权比代码更重要**:AI 放大了"懂行"与"不懂行"的差距,小团队(2-3 人)+ 清晰边界 + 独立仓库比大团队协作更高效,审查应聚焦对齐而非代码细节争论
4. **品味是防"垃圾"泛滥的护城河**:AI 能全天候生成大量平庸代码,工程师的核心价值转向判断"什么值得做",团队应花更多时间思考方向而非盲目堆功能
5. **严格约束 = 速度**:把代码规范、自动化测试、快速验证等"护栏"做得越严,AI 迭代越快(1 分钟 vs 60 分钟的差距);工具必须支持增量检查,避免随代码量增长而变慢
6. **代码库即唯一上下文**:将设计文档、产品行为、决策记录全部沉淀在仓库内,让 AI 和人类都能快速理解;代码越简洁、越易读,AI 修复和迭代越高效
7. **自研技术栈重新划算**:过去依赖第三方库是因为手写代码慢,现在 AI 降低了自研成本,掌控核心依赖能避免被外部框架绑架,获得完全的产品体验控制权
8. **保留选择权(Option Value)**:任何架构改动都应保留未来大幅调整的可能性,AI 虽让重构变快,但把自己逼进死胡同依然难以脱身
9. **管理必须更技术化**:执行成本降低后,管理者不能只做方向把控,必须保持领域 expertise,能亲自改代码、做技术决策,"技术型管理"(Tech Lead Management)将成为主流
10. **效率数据惊人**:近 30 天日均提交 770 次、修改 15k 行代码,是两年前的 3 倍;过去手写巅峰一天 1200 行,现在 AI 辅助可达 10 倍且质量更高
URL:
https://cpojer.net/posts/modern-engineering-values
《OpenHarness:开源智能体基础设施框架》
标签:#AI #Agent #智能体 #开源 #Python #工具调用
总结:
OpenHarness是港大数据智能实验室(HKUDS)推出的轻量级开源智能体基础设施框架,仅用Python实现,代码量比Claude Code轻44倍(1.1万行vs 51万行),提供完整的工具调用、技能加载、记忆管理和多智能体协调功能,让开发者快速构建安全可靠的AI Agent应用。
文章要点:
- 极简架构设计:相比Claude Code的51万行TypeScript代码,OpenHarness仅用1.1万行Python实现,去除了企业级复杂依赖如遥测和OAuth,专注于核心Harness架构
- 五大核心模块:包含Agent循环(支持流式工具调用、并行执行、成本追踪)、工具套件(43种工具覆盖文件/Shell/搜索/Web/MCP)、上下文记忆(CLAUDE.md自动注入、MEMORY.md持久化)、权限治理(多级权限模式、交互式审批)、Swarm多智能体协调(子智能体委派、任务管理)
- 生态兼容性:完全兼容anthropics/skills技能格式和claude-code/plugins插件生态,支持OpenClaw、nanobot、Cursor等CLI工具集成
- 开箱即用:一条命令
文章URL:
https://github.com/HKUDS/OpenHarness
标签:#AI #Agent #智能体 #开源 #Python #工具调用
总结:
OpenHarness是港大数据智能实验室(HKUDS)推出的轻量级开源智能体基础设施框架,仅用Python实现,代码量比Claude Code轻44倍(1.1万行vs 51万行),提供完整的工具调用、技能加载、记忆管理和多智能体协调功能,让开发者快速构建安全可靠的AI Agent应用。
文章要点:
- 极简架构设计:相比Claude Code的51万行TypeScript代码,OpenHarness仅用1.1万行Python实现,去除了企业级复杂依赖如遥测和OAuth,专注于核心Harness架构
- 五大核心模块:包含Agent循环(支持流式工具调用、并行执行、成本追踪)、工具套件(43种工具覆盖文件/Shell/搜索/Web/MCP)、上下文记忆(CLAUDE.md自动注入、MEMORY.md持久化)、权限治理(多级权限模式、交互式审批)、Swarm多智能体协调(子智能体委派、任务管理)
- 生态兼容性:完全兼容anthropics/skills技能格式和claude-code/plugins插件生态,支持OpenClaw、nanobot、Cursor等CLI工具集成
- 开箱即用:一条命令
oh即可启动,内置114个单元测试和6个E2E测试套件,提供稳定可靠的基础能力文章URL:
https://github.com/HKUDS/OpenHarness