

Now vibe coding, so learning hammer FE ?
《把子代理折叠回主循环:Anthropic 谈智能体架构的新取舍》
标签:
#人工智能 #智能体架构 #子代理 #渐进式披露 #单一智能体循环 #评估驱动迁移
总结:
这是 Anthropic 应用 AI 团队于 2026 年 10 月 22 日发布的企业智能体架构指南。核心观点是:随着模型能力增强(从 Opus 4.5 开始),许多企业多智能体系统里的路由、规划器和领域子代理其实在替模型做它已经不再需要的"结构性工作",把这些部分折叠回一个主循环(配合 skills + tools 的渐进式披露),往往在质量、成本和延迟上同时更优——但文章并不否定子代理,而是强调用评估驱动、一次只改一处的迁移方式来决定每个子代理的去留。
文章要点:
1. 多个企业部署的对比显示,"单智能体 + skills"的设计在质量上经常同时胜过"一个大提示词包揽一切"和"子代理架构"两种方案,且单位任务的成本和延迟更低;有客户测得多智能体框架换成单循环后运行速度约快 2 倍。
2. 按团队或问题类型划分子代理,会让架构变成组织架构图的复制品(康威定律),并带来五类典型问题:上下文交接丢细节、子代理泛滥无人负责、各团队往系统提示里加规则造成的"缝合怪提示词"(Frankenprompt)、评估各自为政、以及额外延迟。
3. 单循环能成立靠两点:共享上下文让模型把各步骤结果串联起来,避免"传话游戏"式的层层摘要损耗;渐进式披露(先看到 skills 和 tools 的短描述,用到时才加载全文)消除了过去拆分子代理的主要理由——Anthropic 借此把 Claude Code 高阶模型的系统提示词缩减了 80% 以上。
4. 推荐的单循环形态是:一个模型、一个上下文窗口跑开放式工具循环,harness 里设好回合与成本预算、写入闸门;模型第一回合就在上下文里写计划并随结果修订——写计划的人和执行计划的人是同一个模型,这是与"编排器 + 专家代理"最大的区别。
5. 三类子代理应保留:单一循环因上下文膨胀出现可测量的性能退化时;多个任务需要并行处理、用完即弃的独立上下文时;单个智能体难以选对工具或系统提示中存在相互冲突的指令时。若保留,优先让主循环把它当工具调用,只有需要直接与用户对话时才做完整交接。
6. 迁移路径分三步走:先建一个中央团队维护的端到端评估集(10 条黄金样本即可起步);从使用最多、上下文耦合最强的子代理开始合并;其余逐个折叠成 skills + tools,每次只改一处、用 hillclimb 对比"折叠前后"的表现再决定去留。
7. 配套工具已就绪:Claude API 提供
8. 文章的落脚点是一个原则而非某种架构:持续测量、一次只改一件事、只保留经得起评估检验的部分——模型越强、循环越长,越多的子代理可以被 skills 和 tools 吸收。
URL:https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
标签:
#人工智能 #智能体架构 #子代理 #渐进式披露 #单一智能体循环 #评估驱动迁移
总结:
这是 Anthropic 应用 AI 团队于 2026 年 10 月 22 日发布的企业智能体架构指南。核心观点是:随着模型能力增强(从 Opus 4.5 开始),许多企业多智能体系统里的路由、规划器和领域子代理其实在替模型做它已经不再需要的"结构性工作",把这些部分折叠回一个主循环(配合 skills + tools 的渐进式披露),往往在质量、成本和延迟上同时更优——但文章并不否定子代理,而是强调用评估驱动、一次只改一处的迁移方式来决定每个子代理的去留。
文章要点:
1. 多个企业部署的对比显示,"单智能体 + skills"的设计在质量上经常同时胜过"一个大提示词包揽一切"和"子代理架构"两种方案,且单位任务的成本和延迟更低;有客户测得多智能体框架换成单循环后运行速度约快 2 倍。
2. 按团队或问题类型划分子代理,会让架构变成组织架构图的复制品(康威定律),并带来五类典型问题:上下文交接丢细节、子代理泛滥无人负责、各团队往系统提示里加规则造成的"缝合怪提示词"(Frankenprompt)、评估各自为政、以及额外延迟。
3. 单循环能成立靠两点:共享上下文让模型把各步骤结果串联起来,避免"传话游戏"式的层层摘要损耗;渐进式披露(先看到 skills 和 tools 的短描述,用到时才加载全文)消除了过去拆分子代理的主要理由——Anthropic 借此把 Claude Code 高阶模型的系统提示词缩减了 80% 以上。
4. 推荐的单循环形态是:一个模型、一个上下文窗口跑开放式工具循环,harness 里设好回合与成本预算、写入闸门;模型第一回合就在上下文里写计划并随结果修订——写计划的人和执行计划的人是同一个模型,这是与"编排器 + 专家代理"最大的区别。
5. 三类子代理应保留:单一循环因上下文膨胀出现可测量的性能退化时;多个任务需要并行处理、用完即弃的独立上下文时;单个智能体难以选对工具或系统提示中存在相互冲突的指令时。若保留,优先让主循环把它当工具调用,只有需要直接与用户对话时才做完整交接。
6. 迁移路径分三步走:先建一个中央团队维护的端到端评估集(10 条黄金样本即可起步);从使用最多、上下文耦合最强的子代理开始合并;其余逐个折叠成 skills + tools,每次只改一处、用 hillclimb 对比"折叠前后"的表现再决定去留。
7. 配套工具已就绪:Claude API 提供
build-eval、prompt-audit、hillclimb、cost-optimize 等技能,并随附迁移套件(含可在模拟系统上试跑的演示),GitHub 上还有 Apache-2.0 的参考实现 single-agent-loop-kit。8. 文章的落脚点是一个原则而非某种架构:持续测量、一次只改一件事、只保留经得起评估检验的部分——模型越强、循环越长,越多的子代理可以被 skills 和 tools 吸收。
URL:https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
Puter 团队新项目:把全世界的软件从零重写并开源。Office 三件套、PS 平替 Photo Studio、CAD、Slack 平替 Teamchat、剪映平替 Video Studio……51 款应用一个 monorepo 全装下,每款附在线试用链接,MIT 协议商用随便用。上线 9 天 3,550 星。github.com/HeyPuter/everything
《我用 AI 做设计的六步法(第二篇:复杂功能篇)》
标签:
#AI辅助设计 #工程师设计进阶 #AI_Slop治理 #复杂功能开发 #RefTools
总结:
作者分享了自己用 AI Agent 开发复杂产品功能时、如何避免"AI Slop(AI 生成的设计垃圾)"污染界面的完整流程。核心思路是:在让 Agent 动手之前先充分理解产品和约束,Agent 跑完后必须人工把每个界面状态过一遍,再聚焦打磨关键界面,最后靠团队协作和真实用户反馈收口。
文章要点:
1. 动手前先理解机制:花大量时间在调研规划阶段,搞清 Agent 会接触的产品界面和技术约束,甚至亲手写一遍用户流程,绝不让 Agent 的技术/产品决策带来意外惊喜。
2. 追踪 Agent 的实现轨迹:让 Agent 先把功能粗做出来当"陶土"来塑形,然后通读它产出的所有产物(日志、截图、PR、演示视频),检查实现路线是否有异常偏离。
3. 放大视角看遍所有状态:他要求 Agent 点击功能里每一个界面的每一个状态,输出全状态截图清单和沿途发现的 Bug 清单,先粗扫一遍再标记小问题,这一阶段说得最多的就是"删掉这个"。
4. 聚焦打磨关键界面(Crux Surfaces):把最关键的几个界面拉到 Figma 或 HTML 原型里手工精修,这是 AI 时代里难得的专注打磨细节的乐趣。
5. 走出孤岛、靠团队迭代:一个人用 Agent 能做完过去一个团队的活,但也失去了团队的品味把关;他们靠 Slack 的 #design-adjustments 频道让任何人贴"修改前/后对比图"来提设计改进。
6. 上线、学习、接受意外:复杂功能总有你没想到的交互路径,用户一定会找到它,把产品交到用户手里才是真正的验证。
URL:https://x.com/reactiverobot/status/2115075879923765615
《如何更有野心:给有模型可用的人的教程》
标签:
#人工智能 #个人效率提升 #人机协作 #模型能力边界 #自我效能感 #Altitude_Depth_Range
总结:
作者 Felix Rieseberg(Claude 团队成员)指出,AI 模型能力在各方向增长并不均衡,许多用户还停留在"问首都、改邮件"的浅层用法。他把"更有野心"拆解为 Speed(速度)、Altitude(高度)、Depth(深度)、Range(广度)四种类型,并给出了每种类型的具体操作方法——从"让模型对结果负责"而非"执行单个任务",到"用行业顶尖专家的工具和方法",再到"用跨领域团队思维重写任务",最后还从心理学角度(自我效能感)解释了为什么这种"野心"需要刻意练习。
文章要点:
1. 野心分四种:速度(省时间,已基本普及,无需多讲)、高度(关注目标之上的目标)、深度(像顶尖专家那样做任务)、广度(引入多个领域的视角与方法)。
2. 高度(Altitude)的关键问题是"下一步你想要什么结果":别只让模型填季度报告模板,而是让它分析全部数据找出变化与原因、推演最紧迫的三个决策、甚至设计一套比季度汇报更好的业务监控机制。
3. 深度(Depth)的核心是坚持让模型使用行业顶级专家的工具,而非表面模仿专业术语:用数据库和统计模型替代 Markdown 表格,设定看似不合理的高目标,让模型用原始数据对抗性检验既有假设,甚至构建仿真模型产出"新知识"。
4. 不要自我评判,要用外部裁判:作者在 2026 年 10 月仍坚持模型不能可靠地自我评估,最好用可运行的工具或测试来验证结果。
5. 广度(Range)的技巧之一是把名词换成动词:季度报告不是"一份 PPT",而是"让忙碌的人在 30 分钟内相信因果故事并做出不确定决策",然后再像组建抢劫团队一样,为任务引入分析师、记者、编辑、做空者、法务会计等不同角色真正在"做的事"。
6. 这一切的前提是模型要有电脑可用——能装软件、能访问数据(如 MCP 连接器),而不是只在一个聊天框里空转。
7. 从心理学看,这本质是"自我效能感"问题:人类只敢在自己熟悉的窄领域相信自己能成功;好在这可被"破解"——设定具体的高难度目标(Locke 和 Latham 35 年研究)、看到别人做到后跟上(四分钟一英里、破二马拉松),以及允许自己失败(Linux 当年也只是"爱好")。
URL:https://felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models/
如果你正在用AI构建,收藏这些👇
1. landdding.com — 170+ 视觉技巧
2. modulify.ai/templates — 100+ 免费模板
3. theinternetdesigns.com — 创意网页
4. motionin.design — 动态部分
5. scrolltide.co — 动画网站提示
6. godly.website — 高端网页设计
7. land-book.com — 着陆页灵感
8. cta.gallery — CTA 灵感
9. footer.design — 页脚灵感
10. 60fps.design — 流畅交互
11. backgrounds.supply — 背景
12. inspora.design — 设计灵感
1. devault.design — 39 万+ 真实产品界面、全套 UX 流程,以及 UI 多年来的演变
2. mobbin.com — 移动端和网页应用模式
3. land-book.com — 登陆页面画廊
4. recent.design — 原名 Godly,最“生动”的网页设计画廊
5. pageflows.com — 录制的用户流程
6. reallygoodemails.com — 电子邮件设计库
7. navbar.gallery — 值得复制的每一种导航栏模式
8. footer.design — 页脚,终于有了
9. siteinspire.com — 精选网页设计
10. minimal.gallery — 干净、极简的网站
2. mobbin.com — 移动端和网页应用模式
3. land-book.com — 登陆页面画廊
4. recent.design — 原名 Godly,最“生动”的网页设计画廊
5. pageflows.com — 录制的用户流程
6. reallygoodemails.com — 电子邮件设计库
7. navbar.gallery — 值得复制的每一种导航栏模式
8. footer.design — 页脚,终于有了
9. siteinspire.com — 精选网页设计
10. minimal.gallery — 干净、极简的网站
* inspora.design — 每日设计灵感
* land-book.com — 落地页灵感
* Backgrounds.supply — 自定义背景素材
* mobbin.com — App UI 界面灵感
* obsidianui.dev — 动效 React 组件
* reelfolio.io — 动效 Showcase / Showreel
* bencho.dev — 交互式 UI 组件
* minimal.gallery — 极简风格网站设计
* refero.design — 真实上线产品 UI
* land-book.com — 落地页灵感
* Backgrounds.supply — 自定义背景素材
* mobbin.com — App UI 界面灵感
* obsidianui.dev — 动效 React 组件
* reelfolio.io — 动效 Showcase / Showreel
* bencho.dev — 交互式 UI 组件
* minimal.gallery — 极简风格网站设计
* refero.design — 真实上线产品 UI
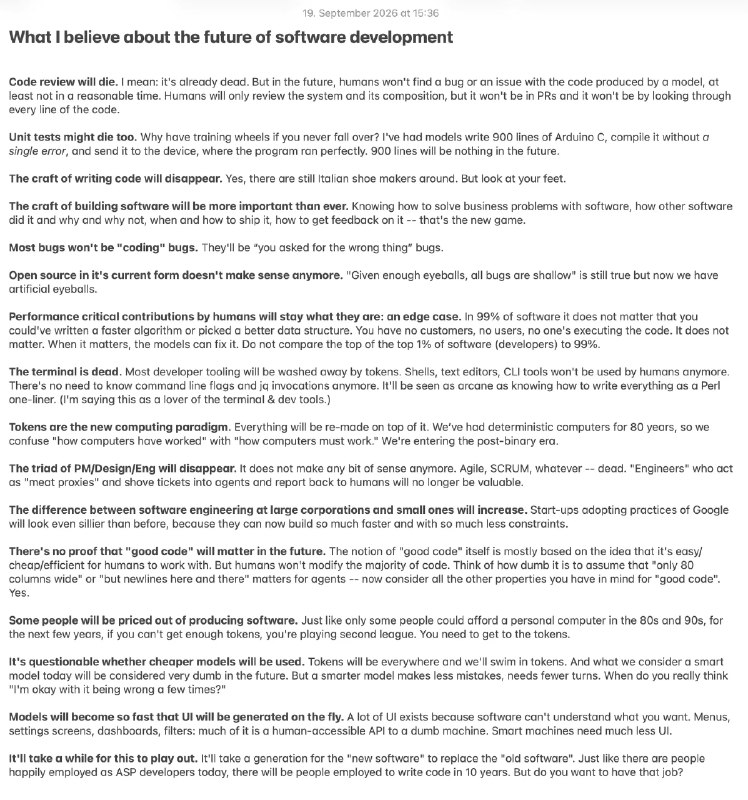
《Thorsten Ball:我对软件开发未来的16条判断》
标签:
#软件工程 #AI编程 #代码审查 #单元测试 #终端工具 #Token计算范式 #开源生态 #软件开发未来 #ThorstenBall
总结:
2026年9月19日,知名开发者、《Writing An Interpreter In Go》作者、现供职于 Sourcegraph/Amp 的 Thorsten Ball 在 X 发布长文,抛出 16 条关于软件开发未来的判断。核心观点是:当 AI 写代码的可靠性足够高时,为人类防错而设计的整套工程实践(代码审查、单元测试、终端、命令行工具)都会逐渐失去必要性,工程师的价值将从"写代码的手艺"迁移到"理解业务、判断取舍、拿到反馈"上,而这一切需要一代人的时间完成。
文章要点:
1. 代码审查已死——人类不会再逐行 review 模型产出的代码,只会审查"系统与其组合方式"。
2. 单元测试可能会消失——他让模型写 900 行 Arduino C 代码零错误一次通过,"摔不了跤就不需要护膝"。
3. 写代码这门手艺会消失,但"造软件"(解决业务问题、判断何时上线、获取反馈)会比以往更重要。
4. 大多数 bug 将不再是代码 bug,而是"你需求提错了"的 bug。
5. 终端已死——Shell、编辑器、CLI 工具会被 token 冲刷,命令行知识将像 Perl 一行流一样变成"古老技艺"。
6. Token 是新的计算范式,我们正在进入"后二进制时代",一切都会在它之上被重构。
7. PM/设计/工程的铁三角和 Agile、Scrum 都会瓦解,只做"人肉代理"的工程师将不再有价值。
8. 大小公司的工程差距会拉大——小团队比学大厂做法的初创公司跑得更快。
9. "好代码"的标准(人类易读易维护)建立在人类要改代码的前提上,这个前提正在崩塌。
10. 现有形式的开源不再合理——"众眼监虫"依然成立,但现在有了"人工眼睛"。
11. 拿不到足够 token 的人会被排除在软件生产之外,token 是新的生产力门槛。
12. 便宜模型未必有人用——更聪明的模型犯错少、轮次少,你未必愿意忍受它多错几次。
13. 模型快到一定程度后,UI 会被实时生成,菜单、设置页、仪表盘这些"面向人类的 API"会大幅减少。
14. 这场变革不会一夜发生——新旧范式更替需要一代人的时间,但反问是:"10年后还有写代码的工作,可你想要那份工作吗?"
URL:https://x.com/thorstenball/status/2101305394190557466
《Gr8r Studio:一款平静、结构化的项目管理工作台》
标签:
#开源项目管理 #Web前端开发 #任务看板 #纯ES模块 #Vite构建
总结:
Gr8r Studio 是一个开源的项目管理应用,提供首页仪表盘、收件箱、我的任务和多视图项目管理(看板/列表/表格/日历/时间线/文件),以及成员、团队、动态和设置等完整功能;它完全用原生 JavaScript ES 模块和 CSS 构建,无任何 UI 框架和运行时依赖,仅由 Vite 打包。
文章要点:
1. 功能齐全:包含仪表盘、收件箱、我的任务,以及看板、列表、表格、日历、时间线、文件六种项目视图。
2. 零框架零依赖:纯 JS ES 模块 + CSS 实现,不引入任何 UI 框架或运行时依赖。
3. 结构清晰:src 目录按 styles、core(状态与主题)、ui、shell(路由与布局)、views、overlays、features、actions 分层组织。
4. 工程化完善:内置 ESLint + Prettier 校验,CI 在每次推送和 PR 时跑 lint、格式检查和生产构建。
5. 可直接预览:仓库附带演示数据(data/seed.js)和 README 截图,vercel.json 配置了一键构建部署到 Vercel。
6. 上手门槛低:仅需 Node.js 18+(.nvmrc 固定 22),适合作为学习现代前端工程化的参考项目。
URL:https://github.com/gr8rstudio/gr8r-studio
《用 React Suspense 面板调试 Suspense》
标签:
#前端开发 #React
#React_Developer_Tools #Suspense面板 #加载调试 #骨架屏 #布局抖动
总结:
本文演示了如何用 React Developer Tools 8.0 新增的 Suspense 面板,排查一个仪表盘页面中"销售统计卡延迟约 2 秒才出现"和"内容到达时快速操作区被顶下去"两个问题。通过时间轴回放、Inspect Suspense Nodes、Suspended by 和强制回退功能,作者定位到负责延迟的边界和 Promise,并把骨架屏改成与真实内容形状、尺寸一致,从而消除了布局抖动。
文章要点:
1. Suspense 面板在 React Developer Tools 8.0 中默认启用,配合 React 19.2+ 的开发模式构建能显示最完整的信息。
2. 面板分为四个区域:工具栏(Inspect Suspense Nodes 可直接从页面点选边界)、Minimap(页面边界的可视化地图,颜色区分渲染环境)、时间轴(每步对应一次初始绘制或边界揭示,可回放页面状态)、检查器(查看 Suspended by、props 和渲染来源)。
3. 通过逐步回放时间轴,发现布局抖动发生在统计卡片揭示的那一刻,因为卡片比灰色占位块高,把上方的 QuickActions 顶了下去——嵌套边界只控制揭示顺序,并不为内容预留空间。
4. 用 Inspect Suspense Nodes 从页面内容反查所属边界,比在大页面里挨个找 Minimap 区域更快;找不到时记得关闭 Unique Suspenders 过滤器。
5. Suspended by 显示边界等待的对象、耗时和解析结果,能把排查范围缩小到数据、代码或资源,但无法解释为什么会慢。
6. 检查器里的"暂停所选组件"按钮可以随时把边界强制切回 fallback,方便把骨架屏和真实内容并排对比,无需改代码或限速网络。
7. 修复方法:让骨架屏复刻真实布局——直接渲染四张真实卡片和标签,只把查询得到的数值换成等高的占位行;重放时间轴后快速操作区不再移动。
URL:https://certificates.dev/blog/debugging-suspense-with-the-react-suspense-panel
《React 编译器到底做了什么》
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
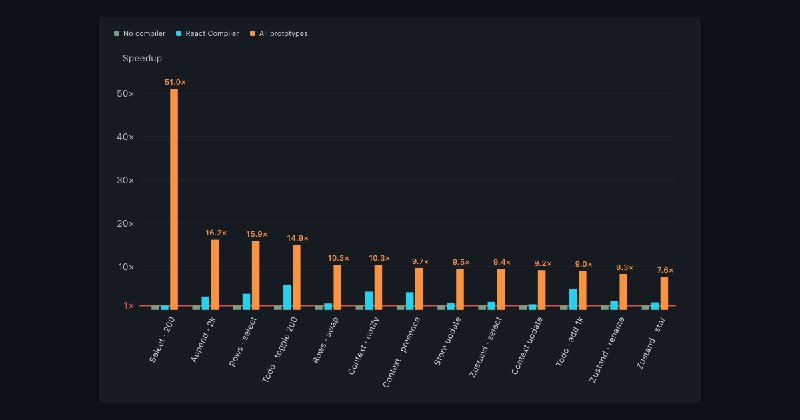
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
_c() 缓存槽位中,首次渲染写入缓存,后续渲染直接复用,本质上相当于给所有内容自动套上了 memo。2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
props.method() 拆成属性加载 + 普通调用),有的推断信息,有的做变换优化。4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
=== 判断挪进 selector 内部这一小改动就能带来数倍提升,编译器完全可以自动完成这类分析(200 次选择从 311.5 ms 降到 48.9 ms)。8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
《我实测了11个HTTP弹性库的21个场景,结果如何?》
标签:
#软件开发 #HttpResilience_对比测试_Retry_CircuitBreaker_Hedging_取消与超时正确性
总结:
作者在开发自己的 fetch 弹性封装库 ffetch 时发现了大量隐藏的正确性问题,于是搭建了一套覆盖 21 个场景的测试矩阵,对 11 个流行的 HTTP 弹性库(包括自己 ffetch 5.7.1)进行横向对比。结果显示:基础的"重试"行为在所有库中都表现良好,但 25 个失败几乎全部集中在组合场景——取消发生在退避等待中、超时与重试叠加、队列中的请求被取消、熔断器半开状态下迟到响应等。作者也坦承测试套件源自自己修过的 bug,存在确认偏差,且部分判定标准(如取消后必须立即停止派发)严于官方文档。矩阵每周自动重建并公开于 fetchkit.org/http-resilience。
文章要点:
1. 测试方法很扎实:21 个场景覆盖重试、超时、熔断、舱壁、对冲、请求去重,用脚本化 fetch + Vitest 假定时器精确控制中止时刻,jitter 固定 random=0.5,并附 2 个真实 node:http 集成场景。
2. 全部 11 个库都通关的"共同强项"是基础重试类场景:重试恢复、重试耗尽、零重试、真实 HTTP 重试、请求体字节级回放,共 55/147 个实现单元。
3. 失败高度聚类于"组合场景":典型如"重试 + 退避中取消",fetch-retry、ofetch、wretch、resilient-fetch-client、fetch-resilience、@resili/fetch 六库会延迟结算甚至取消后继续派发请求;fetch-retry 的源码问题暴露——退避用的是裸
4. 舱壁队列几乎全军覆没:五家有队列的库中四家在"排队请求被取消"场景全挂——取消的调用方仍占着坑位不放,替换请求被拒,个别还照样派发了已取消的请求,ffetch 是唯一通过者。
5. 重试 + 整体超时、Retry-After + 取消、hooks 抛错等场景暴露多家库"超时只罩单次尝试不罩重试循环"、回调拒绝后调用方永久挂起等问题,wretch 甚至会变成一个永远 await 的悬空 Promise。
6. 对冲(hedging)是最不成熟的表面:仅三个库提供带可配置启动延迟的对冲;flowshield 在所有超时设置下都失败,超时后仍启动对冲分支且分支不收手,等于白发给服务器一个没人等的请求。
7. 熔断器组合场景里作者自己的 ffetch 也栽了:半开状态下迟到成功响应会错误清除新开启状态(缺代次计数器);fetch-smartly 和 ts-retry-circuit 更严重,新冷却期被误清导致下一个请求吃掉本应给健康调用方的恢复响应。
8. 作者最后强调方法论局限:无性能基准、无 API 设计评价,场景源于自己修过的 bug 存在确认偏差;建议读者不要只看"功能有没有",而要按自己应用的真实组合方式去测。
URL:
https://blog.gaborkoos.com/posts/2026-10-04-I-Tested-11-Http-Resilience-Libraries/
标签:
#软件开发 #HttpResilience_对比测试_Retry_CircuitBreaker_Hedging_取消与超时正确性
总结:
作者在开发自己的 fetch 弹性封装库 ffetch 时发现了大量隐藏的正确性问题,于是搭建了一套覆盖 21 个场景的测试矩阵,对 11 个流行的 HTTP 弹性库(包括自己 ffetch 5.7.1)进行横向对比。结果显示:基础的"重试"行为在所有库中都表现良好,但 25 个失败几乎全部集中在组合场景——取消发生在退避等待中、超时与重试叠加、队列中的请求被取消、熔断器半开状态下迟到响应等。作者也坦承测试套件源自自己修过的 bug,存在确认偏差,且部分判定标准(如取消后必须立即停止派发)严于官方文档。矩阵每周自动重建并公开于 fetchkit.org/http-resilience。
文章要点:
1. 测试方法很扎实:21 个场景覆盖重试、超时、熔断、舱壁、对冲、请求去重,用脚本化 fetch + Vitest 假定时器精确控制中止时刻,jitter 固定 random=0.5,并附 2 个真实 node:http 集成场景。
2. 全部 11 个库都通关的"共同强项"是基础重试类场景:重试恢复、重试耗尽、零重试、真实 HTTP 重试、请求体字节级回放,共 55/147 个实现单元。
3. 失败高度聚类于"组合场景":典型如"重试 + 退避中取消",fetch-retry、ofetch、wretch、resilient-fetch-client、fetch-resilience、@resili/fetch 六库会延迟结算甚至取消后继续派发请求;fetch-retry 的源码问题暴露——退避用的是裸
setTimeout,从不读 init.signal。4. 舱壁队列几乎全军覆没:五家有队列的库中四家在"排队请求被取消"场景全挂——取消的调用方仍占着坑位不放,替换请求被拒,个别还照样派发了已取消的请求,ffetch 是唯一通过者。
5. 重试 + 整体超时、Retry-After + 取消、hooks 抛错等场景暴露多家库"超时只罩单次尝试不罩重试循环"、回调拒绝后调用方永久挂起等问题,wretch 甚至会变成一个永远 await 的悬空 Promise。
6. 对冲(hedging)是最不成熟的表面:仅三个库提供带可配置启动延迟的对冲;flowshield 在所有超时设置下都失败,超时后仍启动对冲分支且分支不收手,等于白发给服务器一个没人等的请求。
7. 熔断器组合场景里作者自己的 ffetch 也栽了:半开状态下迟到成功响应会错误清除新开启状态(缺代次计数器);fetch-smartly 和 ts-retry-circuit 更严重,新冷却期被误清导致下一个请求吃掉本应给健康调用方的恢复响应。
8. 作者最后强调方法论局限:无性能基准、无 API 设计评价,场景源于自己修过的 bug 存在确认偏差;建议读者不要只看"功能有没有",而要按自己应用的真实组合方式去测。
URL:
https://blog.gaborkoos.com/posts/2026-10-04-I-Tested-11-Http-Resilience-Libraries/
《OpenRig:把 Claude Code 和 Codex 编成一支可恢复的多智能体团队》
标签:
#AI_Agent编排 #多智能体协作 #ClaudeCode #Codex #Tmux #终端UI #任务队列 #快照恢复 #MCP工具 #开源工具
总结:
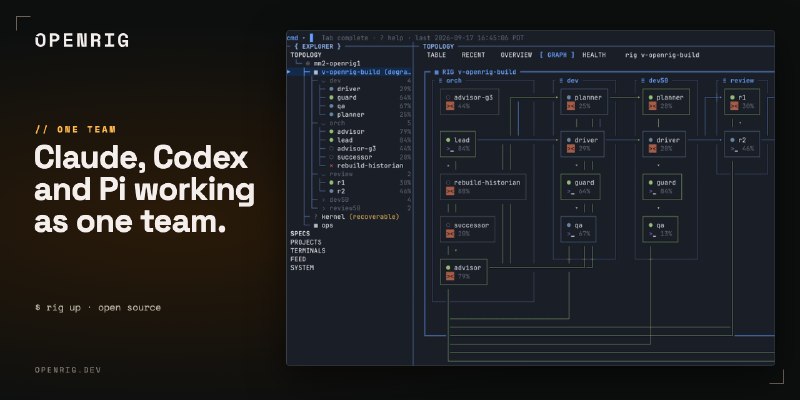
OpenRig 是一个自托管的多智能体 harness:它不替代 Claude Code 或 Codex,而是把多个 Agent 会话组织成“有结构、可命名、可恢复”的团队。你用 YAML(RigSpec)定义团队拓扑,用一条命令启动整队,并通过 TUI/CLI/MCP 观察状态、发消息、跟踪任务和做快照恢复,避免终端窗口越开越散。
文章要点:
1. 核心解决“终端蔓延”:把一堆各自为政的 Claude Code/Codex 会话,变成有角色、有地址、有协作关系的团队。
2. 团队用 YAML 声明式定义:RigSpec 里包含 pods、成员、edges、continuity policies 和 culture 文件,便于版本化与复用。
3. 一键启动与拓扑可视化:
4. 支持“收养”已有会话:
5. 状态可保存也能回滚:
6. 跨 Agent 沟通有统一入口:
7. 提供 Agent 可用的 MCP 工具:Agent 能自管理拓扑(如
8. 权限与安全边界清晰:默认非 YOLO;可配置 typing guard、权限模式、workspace trust、hooks 与活动上报(不包含 prompt 文本和工具参数)。
9. 附带 starter rigs 与示例:如 first-project、product-team、conveyor、adversarial-review、research-team、secrets-manager(HashiCorp Vault 由专门 Agent 管理)。
10. 运行要求明确:需要 Node.js 22/24、tmux,支持 macOS/Linux;可选 herdr/cmux 做终端工作区,Docker 用于服务化 rigs。
URL:
https://github.com/mvschwarz/openrig
标签:
#AI_Agent编排 #多智能体协作 #ClaudeCode #Codex #Tmux #终端UI #任务队列 #快照恢复 #MCP工具 #开源工具
总结:
OpenRig 是一个自托管的多智能体 harness:它不替代 Claude Code 或 Codex,而是把多个 Agent 会话组织成“有结构、可命名、可恢复”的团队。你用 YAML(RigSpec)定义团队拓扑,用一条命令启动整队,并通过 TUI/CLI/MCP 观察状态、发消息、跟踪任务和做快照恢复,避免终端窗口越开越散。
文章要点:
1. 核心解决“终端蔓延”:把一堆各自为政的 Claude Code/Codex 会话,变成有角色、有地址、有协作关系的团队。
2. 团队用 YAML 声明式定义:RigSpec 里包含 pods、成员、edges、continuity policies 和 culture 文件,便于版本化与复用。
3. 一键启动与拓扑可视化:
rig up 会拉起 tmux 会话、harness、启动文件和 readiness 检查;TUI 提供表格/图视图查看 rigs、pods、seats。4. 支持“收养”已有会话:
rig discover 识别现有 tmux 中的 Claude Code/Codex 会话,rig adopt 将其纳入管理。5. 状态可保存也能回滚:
rig down --snapshot 保存拓扑,rig up <name> 按名字恢复,重启后不再丢上下文。6. 跨 Agent 沟通有统一入口:
rig send、rig broadcast、rig chatroom 让协作不再靠人肉切窗口。7. 提供 Agent 可用的 MCP 工具:Agent 能自管理拓扑(如
rig_up、rig_ps、rig_send 等),更适合“由 Agent 驱动”的工作流。8. 权限与安全边界清晰:默认非 YOLO;可配置 typing guard、权限模式、workspace trust、hooks 与活动上报(不包含 prompt 文本和工具参数)。
9. 附带 starter rigs 与示例:如 first-project、product-team、conveyor、adversarial-review、research-team、secrets-manager(HashiCorp Vault 由专门 Agent 管理)。
10. 运行要求明确:需要 Node.js 22/24、tmux,支持 macOS/Linux;可选 herdr/cmux 做终端工作区,Docker 用于服务化 rigs。
URL:
https://github.com/mvschwarz/openrig
《Paperclip:用开源“公司”编排 AI 智能体团队》
标签:
#AI_Agent编排 #Agentic任务管理 #组织治理与成本控制 #多智能体协作 #开源自托管 #Nodejs与React #OrgChart #Heartbeat调度 #预算管控 #多组织隔离
总结:
Paperclip 是一个开源的自托管应用,用“经营公司”的方式管理 AI 智能体团队:它把目标、组织架构、任务、预算、审批、审计和运行环境整合进一个控制台。你可以接入 Claude Code、Codex、Cursor、OpenClaw 等任意 Agent,让它们像员工一样有角色、汇报线、预算与心跳调度,并在一个看板里追踪进度与成本。
文章要点:
1. 核心定位是“管公司,不是管聊天”:Paperclip 不造 Agent、不做拖拽式工作流,而是把多个 Agent 编排成有目标、有层级、有治理的组织。
2. 使用路径很直接:先定义商业目标,再“招聘”不同职能的 Agent(CEO/CTO/工程/设计/营销等),最后审批策略、设置预算并启动运行。
3. 四大支柱覆盖日常到平台层:Agentic 任务管理、Agent 组织架构、Agent 员工培训、Agentic OS(运行基础设施)。
4. 任务系统强调可审计与防冲突:任务带公司/项目/目标链路,支持原子领取、执行锁、阻塞依赖、评论、附件与产出物。
5. Heartbeat 让 Agent 按计划醒来干活:支持定时唤醒、事件触发、上下文续接、结构化日志与自动恢复,减少人工盯梢。
6. 成本控制是硬约束:按公司/Agent/项目/目标/模型等维度追踪 token 与费用,预算到线会告警并硬停止,避免“跑飞”。
7. 治理与回滚机制完整:审批流、执行策略、决策记录、暂停/终止 Agent、配置版本化与审计日志都在系统内完成。
8. 支持多组织隔离与可移植性:一套部署可跑多家“公司”,数据完全隔离;还能导出/导入组织配置并做密钥清理。
9. 运行环境面向真实开发流程:支持项目工作区、隔离执行工作区(如 git worktree)、开发服务/预览链接、密钥注入与技能加载。
10. 它不是聊天机器人、不是 Agent 框架、不是代码评审工具,而是面向“多 Agent 团队”的编排控制平面。
URL:
https://github.com/paperclipai/paperclip
《在 GitHub Copilot 应用中流畅渲染超大 Pull Request》
标签:
#软件工程 #前端性能优化 #PullRequest #虚拟化渲染 #React #测量调度 #滚动锚定 #性能监控
总结:
文章介绍了 GitHub Copilot 应用如何重构 Pull Request 视图,使其能够流畅处理包含 2,200 个文件、超过 100 万行代码变更和 400 多条内联评论的超大型 PR。核心挑战在于评论高度的动态性——与代码行不同,评论高度取决于 Markdown 换行、可展开区块、回复框和图片加载等渲染时才能确定的因素。团队通过分离确定性与动态几何、实现智能测量调度器、采用滚动锚定技术,并建立自动化测量循环来解决这一问题,最终实现了百万行 diff 的流畅浏览体验。
文章要点:
1. 代码与评论的几何分离:代码行高度固定且可预先计算,而评论高度动态变化。团队将文档高度分为确定性代码高度(精确前缀和)和动态块高度(估算后测量),两者独立管理,避免评论调整时重建整个代码几何。
2. 智能测量调度器:放弃每块一个 ResizeObserver 的方案(会触发反馈循环),改为单一的空闲和滚动门控测量通道。仅在视口附近约 2400px 范围内进行测量,屏幕上的块优先批量读取,离屏块最多做一次有限渲染,超过视口高度的块跳过测量。
3. 滚动锚定技术:当测量高度与估算不符时,通过身份而非像素来校正——记录用户锚定的行或块,应用高度增量后,将同一锚点解析到新像素位置并滚动,确保用户视线不跳动。区分用户滚动与程序滚动,避免侧边栏切换等操作误触发保护机制。
4. 数据管道优化:流式传输结构优先于内容,文件树和元数据在文档加载时即可渲染;语法高亮在主线程外运行,行先以纯文本显示;释放文档时保留最近几个 diff 的缓存,平衡内存与返回时的加载速度。
5. 自动化测量循环:建立"变更→测量→改进"的无人值守循环,包括无头探针车道(声明式流程 + 生产环境插桩)和自动驾驶仪(驱动真实桌面应用),通过健康信号(如无未填充间隙、评论块非空)自动检测问题,实现机械式调试而非人工复现。
URL:
https://github.blog/engineering/user-experience/rendering-huge-pull-requests-in-the-github-copilot-app/
《高级工程师死亡螺旋》
标签:
#职业发展 #工程师文化 #工作方法 #心理健康
总结:
文章要点:
1. "高级工程师死亡螺旋"是作者观察到的常见失败模式:工程师在新工作、晋升或大项目开始时,试图"扮演"比自己更资深的角色,设计过于雄心勃勃的方案。
2. 螺旋的典型表现是:工程师消失数周,在站会上给出"积极更新"但实际上没有产出,然后开始告诉自己"需要更努力工作来弥补",最终失眠、抑郁、人际关系受损,导致倦怠、被PIP、辞职等最坏结果。
3. 远程工作和AI编码工具的普及加剧了这一问题:工程师更加孤立,缺乏传统的工作结构和同事间的日常交流,使得"没人知道你在做什么"的情况更容易发生。
4. 破解螺旋的反直觉方法是"降低一级":不要试图表现得比实际级别更高,而是成为最好的队友——做bug修复、帮别人处理繁琐工作、做组织性事务,通过帮助他人来重建动力。
5. 关键 mindset 转变是从"结果导向"转向"动力导向":建立日常 routine,通过每天一点点的工作积累动力,修复与同事的关系,最终获得"耐力"。
6. 核心洞察是:大项目不是靠大努力完成的,而是靠缓慢、稳定、增量的工作——每天、每小时地做,直到成为肌肉记忆。
7. 最终目标是建立可靠性声誉:通过减轻队友和经理的负担来建立信任,然后自然会获得更大的工作机会——因为"你处在建立声誉的生意中,软件只是下游产品"。
8. 作者强调雇主雇佣的是"现在的你",而不是"六个月后你认为你会成为的那个人",因此不需要通过过度努力来证明自己。
URL:
https://sunilpai.dev/posts/the-senior-engineer-death-spiral/
《Notion如何用CRDT解决并发编辑冲突》
标签:
#分布式系统 #协同编辑 #CRDT算法 #数据一致性
总结:
文章要点:
1. Notion在2025年重新设计了底层文本编辑系统,从"最后写入获胜"(LWW)模式转向基于CRDT的并发编辑方案,解决了多人同时编辑同一区块时的数据丢失问题。
2. CRDT(无冲突复制数据类型)允许多个客户端保留本地数据副本,并以确定性方式合并同时发生的更改,确保不会丢失任何人的修改。
3. Notion使用的CRDT基于经典的RGA(可复制增长数组)序列CRDT,这是一个树形数据结构,每个字符都有唯一且稳定的ID,插入和删除操作都引用这些ID。
4. 删除操作采用"墓碑"机制——标记项目为已删除但保留在树中,因为可能有在途或离线操作依赖于已删除字符的ID。
5. 为提升存储效率,Notion将连续字符分组,为整组字符分配一个ID并存储运行长度,而不是为每个字符单独分配ID。
6. 支持富文本格式需要解决注释冲突,Notion引入了基于Peritext算法的操作,支持可扩展和不可扩展的注释类型(如粗体vs超链接)。
7. Notion的区块模型带来了独特挑战:当用户按下回车键分割区块时,需要处理文本在区块间移动时的并发编辑问题。
8. 为解决这一问题,Notion引入了"文本切片"概念——每个区块的文本项属于一个文本切片,分割区块时切片也会相应分割并移动到新区块。
9. 每个文本项ID由会话ID和Lamport时钟组成,确保ID的唯一性;指向同一原点的项目按逻辑时间戳排序,会话ID作为平局决胜因素。
URL:
https://www.notion.com/blog/how-notion-handles-concurrent-editing-with-crdts
《我们现在都是产品工程师了》
标签:
#软件开发 #AI与编程 #职业转型 #产品工程 #就业市场
总结:
文章要点:
1. 作者提出了两个核心假设:AI智能体将吞噬整个软件开发生命周期,以及软件需求没有上限。基于这两个假设,他对未来10年软件行业进行了预测。
2. 软件开发成本正在发生结构性变化:编写代码的成本已经崩溃,代码审查和维护即将被自动化,运维和扩展将是下一个被攻克的领域。
3. 未来软件开发的剩余核心工作是:发现人们真正想要什么、精确定义"好"的标准、让产品变得令人愉悦。这些成本无法规模化转移,将成为新的职业重心。
4. 初级程序员岗位正在消失:22-25岁AI暴露岗位就业率比预期低19%,科技巨头入门级招聘自2019年下降65%,因为智能体已经能够完成初级开发者的工作。
5. 代码审查和维护即将被自动化:前沿模型在真实代码库修复bug的基准测试上,两年内从50%提升到95%,更难的测试上达到59%。
6. 产品工程师(Product Engineer)成为新职业形态:Palantir创造的"前线部署工程师"岗位在2025年增长800%,平均薪资约24万美元,职责是理解客户需求并定义"好"的标准。
7. 培训体系存在巨大缺口:市场急需具备上下文理解和品味的人才,但目前每年只有约50人通过Google APM等项目接受正式培训,而传统的初级开发者培养管道已经断裂。
8. 编程作为一门手艺正在消亡:许多程序员热爱的是编程本身,但未来的工作将主要是与客户沟通、提取需求,这对很多人来说是一个巨大的转变。
9. 未来10年将充满动荡:初级岗位消失、新岗位培训体系尚未建立、许多热爱编程的人需要适应新角色。但10年后,行业将发展为更大规模、薪资相当、以产品工程为主形态的职业。
10. 软件需求实际上是无限的:当前许多软件糟糕不是因为没人会做好,而是因为需求方付不起高价。当开发成本趋近于零时,这些需求将被释放。
URL:
https://seldo.com/posts/we-are-all-product-engineers-now/
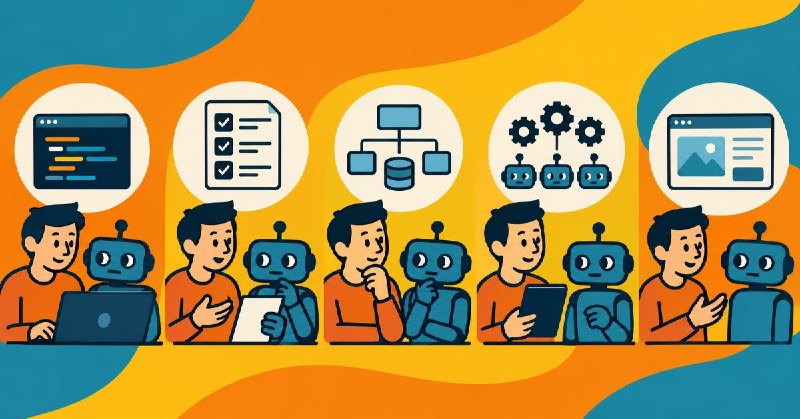
《与 AI 协作的五种软件工程角色》
标签:
#编程 #AI协作 #软件工程 #人机协作 #开发者角色 #技术管理 #AI编程 #团队协作
总结:
这篇文章由资深软件工程师 Nicholas C. Zakas 撰写,系统性地梳理了 AI 编程时代下人类开发者与 AI 协作的五种角色模式。作者将传统软件工程中的协作关系映射到人机协作场景中,为开发者提供了从深度参与到完全托管的完整光谱,帮助团队根据信任程度、风险等级和技术背景选择最合适的协作方式。
文章要点:
1. **观察者(Observer)模式**:这是最基础的人机协作方式,开发者像结对编程中的观察员一样实时监控 AI 写代码。虽然能确保代码质量,但会面临严重的"审查疲劳"——AI 生成代码的速度远超人类阅读速度,导致效率瓶颈。
2. **技术负责人(Tech Lead)模式**:开发者负责编写技术规格说明书,设定自动化检查(代码格式化、Lint、测试覆盖率),然后让 AI 并行执行多个工作流。这种模式能成倍提升生产力,但核心挑战在于需要大量自动化投资来减轻人工审查负担。
3. **架构师(Architect)模式**:开发者只关注高层系统设计、组件接口和基础设施选型,不再审查具体代码实现。风险在于过度脱离代码细节——当系统出问题时可能缺乏底层知识来诊断和修复,因此需要定期抽查生成的代码和测试。
4. **工程经理(Engineering Manager)模式**:开发者专注于搭建"软件工厂"流程,定义从 PRD 到技术规格再到实现计划的完整生产流水线,将任务分配给不同 AI 代理并设定验收标准。挑战在于流程失败时,过度依赖流程重构可能不如直接介入解决问题高效。
5. **产品经理(Product Manager)模式**:开发者完全脱离技术实现,只关注用户体验和产品功能。虽然能完成产品级工作,但最大风险是技术债务——当 AI 造成问题时,往往只能贴创可贴式的临时修复而非根治,导致系统长期依赖外部维护。
6. **动态选择策略**:没有绝对最优的角色,关键在于根据任务风险、对 AI 的信任度和技术上下文灵活切换。探索陌生代码库时当观察者,协调多任务时当技术负责人,追求用户体验时当产品经理。随着对 AI 能力信心的增强,可以沿光谱向更轻量的角色移动,但始终要对最终结果负责。
URL:
https://humanwhocodes.com/blog/2026/09/five-roles-working-ai/
《框架还重要吗?》
标签:
#编程 #Web开发 #AI编程 #前端框架 #React #软件工程 #技术趋势 #VibeCoding
总结:
这是一篇探讨在 AI 编程时代 Web 框架是否仍然重要的深度分析文章。作者 Brooks Lybrand 作为拥有三年开源框架开发经验的前端工程师,针对"模型已经足够好,框架选择不再重要"的流行观点进行了系统性反驳,论证了框架在提供抽象、结构和约束方面的核心价值,并呼吁行业继续创新和构建新框架。
文章要点:
1. **对"React 已赢"论的质疑**:作者指出当前流行观点认为由于 LLM 训练数据中 React 代码最多,模型最熟悉 React,因此无需尝试其他框架。但他认为这种逻辑存在矛盾——如果框架真的不重要,那连 React 都不需要,直接用 Web Components 或让 AI 生成原生代码即可。
2. **框架的本质价值**:作者将框架的价值精炼为三点:**提供抽象(Abstractions)、结构(Structure)和约束(Constraints)**。这些价值不仅适用于人类开发者,对 AI 编程同样关键——良好的抽象能避免 AI 重复造轮子或创建混乱的临时方案;清晰的结构帮助 AI 生成可维护的代码;明确的约束(如类型检查、测试)能防止 AI 在迭代中破坏系统。
3. **AI 时代框架的隐性存在**:引用 React 核心团队成员 Ricky Hanlon 的观点"你要么使用框架,要么构建框架",作者强调即使不显式选择框架,AI 在生成代码时也会隐式地创建框架。与其让 AI 生成一个缺乏维护、充满临时补丁的"隐性框架",不如使用经过实战检验、文档完善的开源框架。
4. **开发者体验(DX)的重构**:通过分析 HMR(热模块替换)、TypeScript 和
5. **框架战争的终结与新机遇**:作者认为 2013-2024 年的"框架战争"已经结束,人们不再渴望为框架争论,但这不意味着框架不再重要。他指出当前框架领域仍存在明显不足,特别是缺乏真正全栈、基于 Web 标准、易于 AI 协作且代码可理解的 JavaScript 框架。
6. **对未来的呼吁**:尽管承认 AI 正在重塑软件开发,且没人知道其长期影响,作者仍坚持认为认为"所有问题都已解决"是一种颓废的态度。他呼吁继续构建新框架,探索更好的抽象和模式,而不是停留在"现有框架足够好"的舒适区。
URL:
https://brookslybrand.com/posts/do-frameworks-matter-anymore/
> 个人觉得有点片面化,remix 脱离 react 转而用 preact 自创轮子
标签:
#编程 #Web开发 #AI编程 #前端框架 #React #软件工程 #技术趋势 #VibeCoding
总结:
这是一篇探讨在 AI 编程时代 Web 框架是否仍然重要的深度分析文章。作者 Brooks Lybrand 作为拥有三年开源框架开发经验的前端工程师,针对"模型已经足够好,框架选择不再重要"的流行观点进行了系统性反驳,论证了框架在提供抽象、结构和约束方面的核心价值,并呼吁行业继续创新和构建新框架。
文章要点:
1. **对"React 已赢"论的质疑**:作者指出当前流行观点认为由于 LLM 训练数据中 React 代码最多,模型最熟悉 React,因此无需尝试其他框架。但他认为这种逻辑存在矛盾——如果框架真的不重要,那连 React 都不需要,直接用 Web Components 或让 AI 生成原生代码即可。
2. **框架的本质价值**:作者将框架的价值精炼为三点:**提供抽象(Abstractions)、结构(Structure)和约束(Constraints)**。这些价值不仅适用于人类开发者,对 AI 编程同样关键——良好的抽象能避免 AI 重复造轮子或创建混乱的临时方案;清晰的结构帮助 AI 生成可维护的代码;明确的约束(如类型检查、测试)能防止 AI 在迭代中破坏系统。
3. **AI 时代框架的隐性存在**:引用 React 核心团队成员 Ricky Hanlon 的观点"你要么使用框架,要么构建框架",作者强调即使不显式选择框架,AI 在生成代码时也会隐式地创建框架。与其让 AI 生成一个缺乏维护、充满临时补丁的"隐性框架",不如使用经过实战检验、文档完善的开源框架。
4. **开发者体验(DX)的重构**:通过分析 HMR(热模块替换)、TypeScript 和
useEffect 等具体技术,作者说明某些传统 DX 功能对人类开发者的价值正在转变,但对 AI 编程仍至关重要。例如 TypeScript 的类型约束能有效防止 AI 在复杂应用中引入错误,而 useEffect 这类强大但易误用的抽象则应该避免让 AI 随意使用。5. **框架战争的终结与新机遇**:作者认为 2013-2024 年的"框架战争"已经结束,人们不再渴望为框架争论,但这不意味着框架不再重要。他指出当前框架领域仍存在明显不足,特别是缺乏真正全栈、基于 Web 标准、易于 AI 协作且代码可理解的 JavaScript 框架。
6. **对未来的呼吁**:尽管承认 AI 正在重塑软件开发,且没人知道其长期影响,作者仍坚持认为认为"所有问题都已解决"是一种颓废的态度。他呼吁继续构建新框架,探索更好的抽象和模式,而不是停留在"现有框架足够好"的舒适区。
URL:
https://brookslybrand.com/posts/do-frameworks-matter-anymore/
> 个人觉得有点片面化,remix 脱离 react 转而用 preact 自创轮子
