

Now vibe coding, so learning hammer FE ?
《程序员的音乐理论:从零推导乐理系统》
标签:
#音乐理论 #编程 #Web_Audio_API #声学物理 #数学原理 #计算机科学
总结:
本文从物理和算术的第一性原理出发,用 JavaScript 代码逐步推导出整个西方音乐理论体系。作者不依赖记忆,而是通过编程和听觉验证,解释了为什么音乐有十二个音、为什么大调音阶是那个形状、为什么和弦听起来和谐,以及乐谱本质上是一种序列化格式。核心洞察是:音乐理论并非 arbitrary 的约定,而是物理(泛音列)和数学(简单整数比)的自然结果。
文章要点:
1. 声音的本质是随时间变化的数字 — 音频就是每秒 44,000 次描述扬声器位置的数字列表,频率即音高,440Hz 只是人为约定的基准。
2. 音色来自你没要求的频率 — 任何乐器发出的都不是单一频率,而是基频的整数倍(泛音列)。不同波形(正弦、三角、方波、锯齿波)本质上是泛音配方的差异,这解释了为什么小提琴和小号音色不同。
3. 八度是频率翻倍,音高是乘法关系 — 220Hz、440Hz、880Hz 听起来是"同一个音",因为高八度的所有泛音都包含在低八度的泛音列中。因此整个音高问题简化为"如何把倍频区间分割"。
4. 简单整数比听起来和谐 — 2:1(八度)、3:2(五度)、4:3(四度)、5:4(大三度)听起来协和,是因为它们的泛音列有大量重叠;而复杂比例(如 √2)产生拍频和粗糙感。协和的本质是耳朵能快速找到重复模式。
5. 十二音律是数学妥协 — 纯五度(3:2)叠 12 次不等于 7 个八度(2^7),这个无法修复的误差叫"毕达哥拉斯音差"。现代十二平均律将八度均分为 12 份(每份是 2 的 12 次方根),虽然除了八度都不纯,但让所有调都能用。12 之所以被选中,是因为它是第一个能把五度误差控制在约 0.1% 以内的数字。
6. 音阶是间隔数组 — 大调音阶
7. 和弦是隔一个音取的堆叠 — 三和弦
8. 调内七和弦是自然涌现的 — 在一个大调音阶上,从七个音级分别构建三和弦,会自动得到:I(大三)、ii(小三)、iii(小三)、IV(大三)、V(大三)、vi(小三)、vii°(减三)。罗马数字标记是相对寻址,移调只需加一个常数。
9. 张力与解决有物理基础 — V7 → I 是最强的解决感,因为 V 和弦中的 B(导音)距 I 的根音只差半音,且 V7 包含三全音(B-F,√2 比例,最不稳定),这两个音分别向相反方向移动半音到达稳定位置。
10. 乐谱是带 header 的序列化格式 — 五线谱本质是针对"实时阅读、手在忙"场景优化的数据格式:纵轴是音阶度数(非线性频率),谱号定义坐标原点,升降号是 escape hatch,调号是 DRY 原则(常量提升),时值是 2 的负幂次,附点是二进制分数,速度(BPM)把拍子映射到秒。
URL:
https://runjs.app/blog/music-theory-for-programmers
标签:
#音乐理论 #编程 #Web_Audio_API #声学物理 #数学原理 #计算机科学
总结:
本文从物理和算术的第一性原理出发,用 JavaScript 代码逐步推导出整个西方音乐理论体系。作者不依赖记忆,而是通过编程和听觉验证,解释了为什么音乐有十二个音、为什么大调音阶是那个形状、为什么和弦听起来和谐,以及乐谱本质上是一种序列化格式。核心洞察是:音乐理论并非 arbitrary 的约定,而是物理(泛音列)和数学(简单整数比)的自然结果。
文章要点:
1. 声音的本质是随时间变化的数字 — 音频就是每秒 44,000 次描述扬声器位置的数字列表,频率即音高,440Hz 只是人为约定的基准。
2. 音色来自你没要求的频率 — 任何乐器发出的都不是单一频率,而是基频的整数倍(泛音列)。不同波形(正弦、三角、方波、锯齿波)本质上是泛音配方的差异,这解释了为什么小提琴和小号音色不同。
3. 八度是频率翻倍,音高是乘法关系 — 220Hz、440Hz、880Hz 听起来是"同一个音",因为高八度的所有泛音都包含在低八度的泛音列中。因此整个音高问题简化为"如何把倍频区间分割"。
4. 简单整数比听起来和谐 — 2:1(八度)、3:2(五度)、4:3(四度)、5:4(大三度)听起来协和,是因为它们的泛音列有大量重叠;而复杂比例(如 √2)产生拍频和粗糙感。协和的本质是耳朵能快速找到重复模式。
5. 十二音律是数学妥协 — 纯五度(3:2)叠 12 次不等于 7 个八度(2^7),这个无法修复的误差叫"毕达哥拉斯音差"。现代十二平均律将八度均分为 12 份(每份是 2 的 12 次方根),虽然除了八度都不纯,但让所有调都能用。12 之所以被选中,是因为它是第一个能把五度误差控制在约 0.1% 以内的数字。
6. 音阶是间隔数组 — 大调音阶
[2,2,1,2,2,2,1] 只是一个七元素数组,加起来为 12。自然小调是它的旋转(从第 5 位开始),七种调式则是同一数组的 7 种循环移位,这让作者感叹"音乐理论终于不再像 arbitrary 的 trivia"。7. 和弦是隔一个音取的堆叠 — 三和弦
[0,2,4] 取音阶中每隔一个的音,大三和弦 [0,4,7] 与小三和弦 [0,3,7] 只差一个半音,却代表了西方音乐两大情感极。七和弦加入第四个音后,音乐开始从"圣咏"变成"爵士"。8. 调内七和弦是自然涌现的 — 在一个大调音阶上,从七个音级分别构建三和弦,会自动得到:I(大三)、ii(小三)、iii(小三)、IV(大三)、V(大三)、vi(小三)、vii°(减三)。罗马数字标记是相对寻址,移调只需加一个常数。
9. 张力与解决有物理基础 — V7 → I 是最强的解决感,因为 V 和弦中的 B(导音)距 I 的根音只差半音,且 V7 包含三全音(B-F,√2 比例,最不稳定),这两个音分别向相反方向移动半音到达稳定位置。
10. 乐谱是带 header 的序列化格式 — 五线谱本质是针对"实时阅读、手在忙"场景优化的数据格式:纵轴是音阶度数(非线性频率),谱号定义坐标原点,升降号是 escape hatch,调号是 DRY 原则(常量提升),时值是 2 的负幂次,附点是二进制分数,速度(BPM)把拍子映射到秒。
URL:
https://runjs.app/blog/music-theory-for-programmers
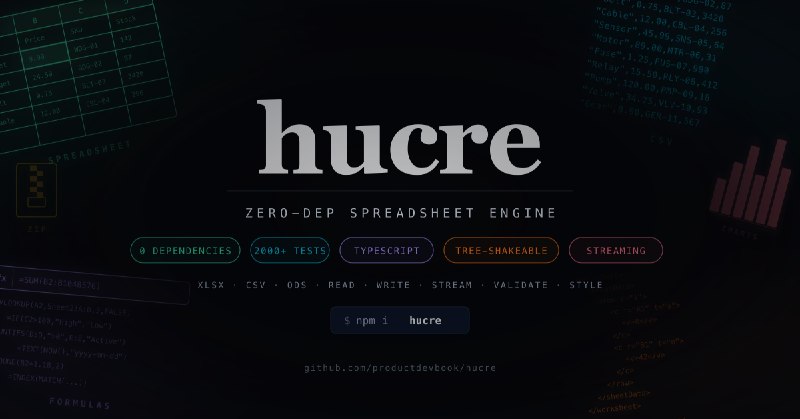
《hucre:零依赖的电子表格引擎》
标签:
#Web开发 #TypeScript #电子表格 #Xlsx #Csv #Ods #数据转换 #零依赖 #流式处理 #数据验证 #无障碍访问
总结:
文章要点:
1. 核心定位:一个纯 TypeScript 编写的零依赖电子表格引擎,支持读写 XLSX、CSV、ODS、JSON、NDJSON、XML、HTML 等多种格式,可在 Node.js、Deno、Bun、浏览器、Cloudflare Workers 等任意平台运行
2. 极致轻量:完全支持 Tree Shaking,按需导入,CSV 模块仅 3.7KB gzip,完整库 129KB gzip,远小于 SheetJS(300KB)和 ExcelJS(500KB)
3. 多格式统一 API:通过
4. 流式处理:支持 XLSX、CSV、NDJSON、ODS、XML 的流式读写,可处理百万级数据而不爆内存;300万行 XLSX 流式写入峰值内存仅 70MB,而增量写入器需要 1GB+
5. 功能全面:支持单元格样式、条件格式(13 种)、数据验证、超链接、图片(含 SVG)、图表(柱状/折线/饼图等)、数据透视表、迷你图、冻结窗格、密码保护、Excel 2024 原生复选框、模板引擎等
6. 往返保真:
7. 数据验证与无障碍:内置 Schema 验证(类型强制、正则、枚举、范围),以及 WCAG 2.1 AA 无障碍审计(对比度检查、缺失替代文本、表头检测等)
8. 遗留格式支持:可读取 XLS(Excel 97-2003)和 XLSB(二进制 Excel)文件,自动检测格式
9. 开发体验友好:提供 Builder API 链式调用、对象简写读写(
10. 明确的能力边界:不实现公式计算引擎、不支持 XLS/XLSB 写入、部分高级图表类型(气泡图/雷达图等)仅支持读取和往返、流式 ODS 写入不带样式
URL:https://github.com/productdevbook/hucre
标签:
#Web开发 #TypeScript #电子表格 #Xlsx #Csv #Ods #数据转换 #零依赖 #流式处理 #数据验证 #无障碍访问
总结:
文章要点:
1. 核心定位:一个纯 TypeScript 编写的零依赖电子表格引擎,支持读写 XLSX、CSV、ODS、JSON、NDJSON、XML、HTML 等多种格式,可在 Node.js、Deno、Bun、浏览器、Cloudflare Workers 等任意平台运行
2. 极致轻量:完全支持 Tree Shaking,按需导入,CSV 模块仅 3.7KB gzip,完整库 129KB gzip,远小于 SheetJS(300KB)和 ExcelJS(500KB)
3. 多格式统一 API:通过
read() 自动检测格式,write() 支持 9 种输出格式(XLSX、ODS、CSV、TSV、JSON、NDJSON、XML、HTML、Markdown),大幅降低多格式处理的心智负担4. 流式处理:支持 XLSX、CSV、NDJSON、ODS、XML 的流式读写,可处理百万级数据而不爆内存;300万行 XLSX 流式写入峰值内存仅 70MB,而增量写入器需要 1GB+
5. 功能全面:支持单元格样式、条件格式(13 种)、数据验证、超链接、图片(含 SVG)、图表(柱状/折线/饼图等)、数据透视表、迷你图、冻结窗格、密码保护、Excel 2024 原生复选框、模板引擎等
6. 往返保真:
openXlsx/saveXlsx 路径可保留图表、VBA 宏、切片器、时间线过滤器等 hucre 不原生建模的部分,实现无损编辑他人文件7. 数据验证与无障碍:内置 Schema 验证(类型强制、正则、枚举、范围),以及 WCAG 2.1 AA 无障碍审计(对比度检查、缺失替代文本、表头检测等)
8. 遗留格式支持:可读取 XLS(Excel 97-2003)和 XLSB(二进制 Excel)文件,自动检测格式
9. 开发体验友好:提供 Builder API 链式调用、对象简写读写(
readObjects/writeObjects)、CLI 工具(格式转换、检查、验证)、单元格工具函数(行列转换、范围解析)10. 明确的能力边界:不实现公式计算引擎、不支持 XLS/XLSB 写入、部分高级图表类型(气泡图/雷达图等)仅支持读取和往返、流式 ODS 写入不带样式
URL:https://github.com/productdevbook/hucre
《开源健身数据集:1324条多语言结构化运动数据与开发者脚手架》
标签:#数据科学 #健身 #开源数据集 #多语言 #开发者工具
总结:
这是一个面向开发者的健身运动结构化数据集,收录1324条运动记录,涵盖部位、器械、目标肌群等元数据,并提供英语、西班牙语、意大利语、土耳其语、俄语和中文六种语言的步骤说明。仓库还附带开箱即用的交互式浏览器和开发者配置向导(含SQL建表、API代码模板、LLM提示词),可快速搭建健身类应用后端。运动媒体文件(图片/GIF)因版权争议未包含,仅保留原始媒体ID引用。
文章要点:
1. 数据规模很扎实:一共1324条运动记录,覆盖从手臂、腿部到背部、核心等10个身体部位,器械类型也多达12种,其中约25%是自重训练,居家健身App也能直接用
2. 多语言支持很贴心:每条运动都配了英、西、意、土、俄、中六种语言的步骤说明,做国际化健身产品不用自己翻译了
3. 开发者体验拉满:仓库里塞了一个纯前端的运动浏览器(index.html)和一个配置向导(setup.html),能直接生成SQL建表语句、多语言API调用代码,还能一键复制LLM提示词让AI帮你搭后端
4. 版权处理很谨慎:图片和GIF动画因为存在多方权属争议,仓库里故意没打包,只留了media_id,需要的话可以通过原始CDN地址自行获取,避免法律风险
5. 数据结构很规范:JSON格式,字段包含ID、名称、部位、器械、目标肌群、协同肌群、六语说明、媒体引用等,还提供了TypeScript类型定义,类型安全直接拿捏
URL:https://github.com/hasaneyldrm/exercises-dataset
标签:#数据科学 #健身 #开源数据集 #多语言 #开发者工具
总结:
这是一个面向开发者的健身运动结构化数据集,收录1324条运动记录,涵盖部位、器械、目标肌群等元数据,并提供英语、西班牙语、意大利语、土耳其语、俄语和中文六种语言的步骤说明。仓库还附带开箱即用的交互式浏览器和开发者配置向导(含SQL建表、API代码模板、LLM提示词),可快速搭建健身类应用后端。运动媒体文件(图片/GIF)因版权争议未包含,仅保留原始媒体ID引用。
文章要点:
1. 数据规模很扎实:一共1324条运动记录,覆盖从手臂、腿部到背部、核心等10个身体部位,器械类型也多达12种,其中约25%是自重训练,居家健身App也能直接用
2. 多语言支持很贴心:每条运动都配了英、西、意、土、俄、中六种语言的步骤说明,做国际化健身产品不用自己翻译了
3. 开发者体验拉满:仓库里塞了一个纯前端的运动浏览器(index.html)和一个配置向导(setup.html),能直接生成SQL建表语句、多语言API调用代码,还能一键复制LLM提示词让AI帮你搭后端
4. 版权处理很谨慎:图片和GIF动画因为存在多方权属争议,仓库里故意没打包,只留了media_id,需要的话可以通过原始CDN地址自行获取,避免法律风险
5. 数据结构很规范:JSON格式,字段包含ID、名称、部位、器械、目标肌群、协同肌群、六语说明、媒体引用等,还提供了TypeScript类型定义,类型安全直接拿捏
URL:https://github.com/hasaneyldrm/exercises-dataset
《node-html-to-text:HTML转纯文本转换器》
标签:#NodeJS #工具库 #HTML解析 #文本转换 #数据提取 #内容处理
总结:
node-html-to-text 是一款成熟的 Node.js 库,用于将 HTML 文档解析并转换为格式优美的纯文本。它通过类 CSS 的 selectors 机制实现高度灵活的格式化控制,支持表格、链接、列表等复杂结构,并提供
文章要点:
- **核心能力**:支持行内/块级标签、表格(含跨行跨列)、链接、自动换行、Unicode 等,能把复杂 HTML 干净地转成可读文本
- **两种使用模式**:`convert()
- **Selectors 驱动配置**:采用类似 CSS 的 selectors 数组来匹配元素并指定格式化方式,支持标签、类名、ID、属性等组合选择,特异性高的规则优先生效
- **丰富的自定义扩展**:可通过
- **版本演进清晰**:v8 引入 selectors 体系,v9 支持 ESM/CJS 双模式并移除大量废弃选项,v10 要求 Node.js 20.19.0+,API 趋于稳定现代
文章URL:https://github.com/html-to-text/node-html-to-text
标签:#NodeJS #工具库 #HTML解析 #文本转换 #数据提取 #内容处理
总结:
node-html-to-text 是一款成熟的 Node.js 库,用于将 HTML 文档解析并转换为格式优美的纯文本。它通过类 CSS 的 selectors 机制实现高度灵活的格式化控制,支持表格、链接、列表等复杂结构,并提供
compile 预编译模式以优化批量处理性能。文章要点:
- **核心能力**:支持行内/块级标签、表格(含跨行跨列)、链接、自动换行、Unicode 等,能把复杂 HTML 干净地转成可读文本
- **两种使用模式**:`convert()
适合单次转换;`compile() 预编译配置后批量处理,性能更优,推荐处理大量文档时使用- **Selectors 驱动配置**:采用类似 CSS 的 selectors 数组来匹配元素并指定格式化方式,支持标签、类名、ID、属性等组合选择,特异性高的规则优先生效
- **丰富的自定义扩展**:可通过
formatters 注册自定义格式化函数,还能传入 metadata 让 formatter 访问额外上下文信息,满足特殊业务需求- **版本演进清晰**:v8 引入 selectors 体系,v9 支持 ESM/CJS 双模式并移除大量废弃选项,v10 要求 Node.js 20.19.0+,API 趋于稳定现代
文章URL:https://github.com/html-to-text/node-html-to-text
《利用浏览器Canvas进行数据压缩》
标签:#前端 #JavaScript #CanvasAPI #数据压缩 #PNG编码 #浏览器兼容性 #SPA
总结:本文介绍了一种利用浏览器Canvas API将任意数据压缩为PNG图像格式的技术方案。通过将字节数据编码为像素颜色值并生成PNG图像,可以间接调用浏览器内置的压缩算法,实现无需外部依赖的数据压缩。该方法特别适用于需要在旧版浏览器中压缩数据、或需要将SPA状态序列化到URL中的场景,提供了Compression Streams API不可用时的替代方案。
文章要点:
- 背景需求:在静态网站和SPA中,有时需要将状态数据序列化到URL hash中,因此需要前端数据压缩方案;虽然2023年5月后Compression Streams API已普及,但旧版浏览器仍需替代方案
- 核心原理:浏览器内置了优化的压缩库用于HTTP请求和图片处理,通过将数据编码为PNG像素数据,可间接利用浏览器的无损压缩能力
- 技术实现:将Uint8Array数据按RGB通道编码到Canvas像素中(首字节存储最后一像素的有效字节数),Alpha通道固定为255以确保跨浏览器一致性,最终通过toDataURL("image/png")获取base64编码的压缩数据
- 解压流程:异步加载生成的PNG图片,读取像素数据后过滤Alpha通道,根据首字节指示的有效长度提取原始字节数据
- 方案特点:即使考虑PNG格式开销,压缩后的数据通常仍小于原始数据;完全基于浏览器原生API,无需外部库依赖
- 应用场景:旧浏览器兼容性支持、URL状态序列化、纯前端数据压缩需求
文章URL:https://jstrieb.github.io/posts/canvas-compress/
标签:#前端 #JavaScript #CanvasAPI #数据压缩 #PNG编码 #浏览器兼容性 #SPA
总结:本文介绍了一种利用浏览器Canvas API将任意数据压缩为PNG图像格式的技术方案。通过将字节数据编码为像素颜色值并生成PNG图像,可以间接调用浏览器内置的压缩算法,实现无需外部依赖的数据压缩。该方法特别适用于需要在旧版浏览器中压缩数据、或需要将SPA状态序列化到URL中的场景,提供了Compression Streams API不可用时的替代方案。
文章要点:
- 背景需求:在静态网站和SPA中,有时需要将状态数据序列化到URL hash中,因此需要前端数据压缩方案;虽然2023年5月后Compression Streams API已普及,但旧版浏览器仍需替代方案
- 核心原理:浏览器内置了优化的压缩库用于HTTP请求和图片处理,通过将数据编码为PNG像素数据,可间接利用浏览器的无损压缩能力
- 技术实现:将Uint8Array数据按RGB通道编码到Canvas像素中(首字节存储最后一像素的有效字节数),Alpha通道固定为255以确保跨浏览器一致性,最终通过toDataURL("image/png")获取base64编码的压缩数据
- 解压流程:异步加载生成的PNG图片,读取像素数据后过滤Alpha通道,根据首字节指示的有效长度提取原始字节数据
- 方案特点:即使考虑PNG格式开销,压缩后的数据通常仍小于原始数据;完全基于浏览器原生API,无需外部库依赖
- 应用场景:旧浏览器兼容性支持、URL状态序列化、纯前端数据压缩需求
文章URL:https://jstrieb.github.io/posts/canvas-compress/
