

Now vibe coding, so learning hammer FE ?
《React 编译器到底做了什么》
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
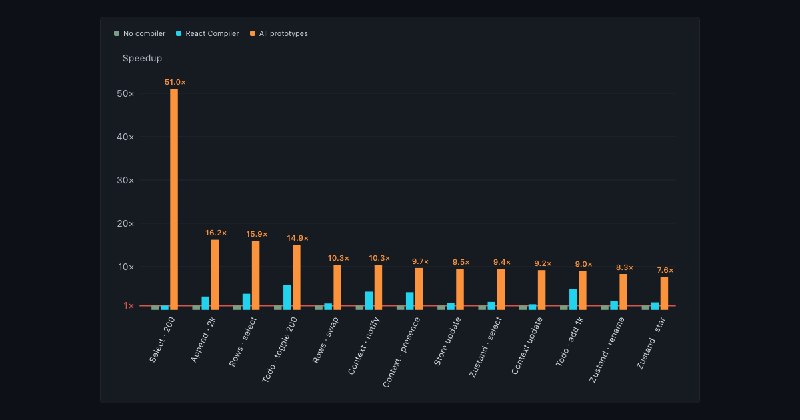
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
_c() 缓存槽位中,首次渲染写入缓存,后续渲染直接复用,本质上相当于给所有内容自动套上了 memo。2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
props.method() 拆成属性加载 + 普通调用),有的推断信息,有的做变换优化。4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
=== 判断挪进 selector 内部这一小改动就能带来数倍提升,编译器完全可以自动完成这类分析(200 次选择从 311.5 ms 降到 48.9 ms)。8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
《与 AI 协作的五种软件工程角色》
标签:
#编程 #AI协作 #软件工程 #人机协作 #开发者角色 #技术管理 #AI编程 #团队协作
总结:
这篇文章由资深软件工程师 Nicholas C. Zakas 撰写,系统性地梳理了 AI 编程时代下人类开发者与 AI 协作的五种角色模式。作者将传统软件工程中的协作关系映射到人机协作场景中,为开发者提供了从深度参与到完全托管的完整光谱,帮助团队根据信任程度、风险等级和技术背景选择最合适的协作方式。
文章要点:
1. **观察者(Observer)模式**:这是最基础的人机协作方式,开发者像结对编程中的观察员一样实时监控 AI 写代码。虽然能确保代码质量,但会面临严重的"审查疲劳"——AI 生成代码的速度远超人类阅读速度,导致效率瓶颈。
2. **技术负责人(Tech Lead)模式**:开发者负责编写技术规格说明书,设定自动化检查(代码格式化、Lint、测试覆盖率),然后让 AI 并行执行多个工作流。这种模式能成倍提升生产力,但核心挑战在于需要大量自动化投资来减轻人工审查负担。
3. **架构师(Architect)模式**:开发者只关注高层系统设计、组件接口和基础设施选型,不再审查具体代码实现。风险在于过度脱离代码细节——当系统出问题时可能缺乏底层知识来诊断和修复,因此需要定期抽查生成的代码和测试。
4. **工程经理(Engineering Manager)模式**:开发者专注于搭建"软件工厂"流程,定义从 PRD 到技术规格再到实现计划的完整生产流水线,将任务分配给不同 AI 代理并设定验收标准。挑战在于流程失败时,过度依赖流程重构可能不如直接介入解决问题高效。
5. **产品经理(Product Manager)模式**:开发者完全脱离技术实现,只关注用户体验和产品功能。虽然能完成产品级工作,但最大风险是技术债务——当 AI 造成问题时,往往只能贴创可贴式的临时修复而非根治,导致系统长期依赖外部维护。
6. **动态选择策略**:没有绝对最优的角色,关键在于根据任务风险、对 AI 的信任度和技术上下文灵活切换。探索陌生代码库时当观察者,协调多任务时当技术负责人,追求用户体验时当产品经理。随着对 AI 能力信心的增强,可以沿光谱向更轻量的角色移动,但始终要对最终结果负责。
URL:
https://humanwhocodes.com/blog/2026/09/five-roles-working-ai/
《框架还重要吗?》
标签:
#编程 #Web开发 #AI编程 #前端框架 #React #软件工程 #技术趋势 #VibeCoding
总结:
这是一篇探讨在 AI 编程时代 Web 框架是否仍然重要的深度分析文章。作者 Brooks Lybrand 作为拥有三年开源框架开发经验的前端工程师,针对"模型已经足够好,框架选择不再重要"的流行观点进行了系统性反驳,论证了框架在提供抽象、结构和约束方面的核心价值,并呼吁行业继续创新和构建新框架。
文章要点:
1. **对"React 已赢"论的质疑**:作者指出当前流行观点认为由于 LLM 训练数据中 React 代码最多,模型最熟悉 React,因此无需尝试其他框架。但他认为这种逻辑存在矛盾——如果框架真的不重要,那连 React 都不需要,直接用 Web Components 或让 AI 生成原生代码即可。
2. **框架的本质价值**:作者将框架的价值精炼为三点:**提供抽象(Abstractions)、结构(Structure)和约束(Constraints)**。这些价值不仅适用于人类开发者,对 AI 编程同样关键——良好的抽象能避免 AI 重复造轮子或创建混乱的临时方案;清晰的结构帮助 AI 生成可维护的代码;明确的约束(如类型检查、测试)能防止 AI 在迭代中破坏系统。
3. **AI 时代框架的隐性存在**:引用 React 核心团队成员 Ricky Hanlon 的观点"你要么使用框架,要么构建框架",作者强调即使不显式选择框架,AI 在生成代码时也会隐式地创建框架。与其让 AI 生成一个缺乏维护、充满临时补丁的"隐性框架",不如使用经过实战检验、文档完善的开源框架。
4. **开发者体验(DX)的重构**:通过分析 HMR(热模块替换)、TypeScript 和
5. **框架战争的终结与新机遇**:作者认为 2013-2024 年的"框架战争"已经结束,人们不再渴望为框架争论,但这不意味着框架不再重要。他指出当前框架领域仍存在明显不足,特别是缺乏真正全栈、基于 Web 标准、易于 AI 协作且代码可理解的 JavaScript 框架。
6. **对未来的呼吁**:尽管承认 AI 正在重塑软件开发,且没人知道其长期影响,作者仍坚持认为认为"所有问题都已解决"是一种颓废的态度。他呼吁继续构建新框架,探索更好的抽象和模式,而不是停留在"现有框架足够好"的舒适区。
URL:
https://brookslybrand.com/posts/do-frameworks-matter-anymore/
> 个人觉得有点片面化,remix 脱离 react 转而用 preact 自创轮子
标签:
#编程 #Web开发 #AI编程 #前端框架 #React #软件工程 #技术趋势 #VibeCoding
总结:
这是一篇探讨在 AI 编程时代 Web 框架是否仍然重要的深度分析文章。作者 Brooks Lybrand 作为拥有三年开源框架开发经验的前端工程师,针对"模型已经足够好,框架选择不再重要"的流行观点进行了系统性反驳,论证了框架在提供抽象、结构和约束方面的核心价值,并呼吁行业继续创新和构建新框架。
文章要点:
1. **对"React 已赢"论的质疑**:作者指出当前流行观点认为由于 LLM 训练数据中 React 代码最多,模型最熟悉 React,因此无需尝试其他框架。但他认为这种逻辑存在矛盾——如果框架真的不重要,那连 React 都不需要,直接用 Web Components 或让 AI 生成原生代码即可。
2. **框架的本质价值**:作者将框架的价值精炼为三点:**提供抽象(Abstractions)、结构(Structure)和约束(Constraints)**。这些价值不仅适用于人类开发者,对 AI 编程同样关键——良好的抽象能避免 AI 重复造轮子或创建混乱的临时方案;清晰的结构帮助 AI 生成可维护的代码;明确的约束(如类型检查、测试)能防止 AI 在迭代中破坏系统。
3. **AI 时代框架的隐性存在**:引用 React 核心团队成员 Ricky Hanlon 的观点"你要么使用框架,要么构建框架",作者强调即使不显式选择框架,AI 在生成代码时也会隐式地创建框架。与其让 AI 生成一个缺乏维护、充满临时补丁的"隐性框架",不如使用经过实战检验、文档完善的开源框架。
4. **开发者体验(DX)的重构**:通过分析 HMR(热模块替换)、TypeScript 和
useEffect 等具体技术,作者说明某些传统 DX 功能对人类开发者的价值正在转变,但对 AI 编程仍至关重要。例如 TypeScript 的类型约束能有效防止 AI 在复杂应用中引入错误,而 useEffect 这类强大但易误用的抽象则应该避免让 AI 随意使用。5. **框架战争的终结与新机遇**:作者认为 2013-2024 年的"框架战争"已经结束,人们不再渴望为框架争论,但这不意味着框架不再重要。他指出当前框架领域仍存在明显不足,特别是缺乏真正全栈、基于 Web 标准、易于 AI 协作且代码可理解的 JavaScript 框架。
6. **对未来的呼吁**:尽管承认 AI 正在重塑软件开发,且没人知道其长期影响,作者仍坚持认为认为"所有问题都已解决"是一种颓废的态度。他呼吁继续构建新框架,探索更好的抽象和模式,而不是停留在"现有框架足够好"的舒适区。
URL:
https://brookslybrand.com/posts/do-frameworks-matter-anymore/
> 个人觉得有点片面化,remix 脱离 react 转而用 preact 自创轮子
《程序员的音乐理论:从零推导乐理系统》
标签:
#音乐理论 #编程 #Web_Audio_API #声学物理 #数学原理 #计算机科学
总结:
本文从物理和算术的第一性原理出发,用 JavaScript 代码逐步推导出整个西方音乐理论体系。作者不依赖记忆,而是通过编程和听觉验证,解释了为什么音乐有十二个音、为什么大调音阶是那个形状、为什么和弦听起来和谐,以及乐谱本质上是一种序列化格式。核心洞察是:音乐理论并非 arbitrary 的约定,而是物理(泛音列)和数学(简单整数比)的自然结果。
文章要点:
1. 声音的本质是随时间变化的数字 — 音频就是每秒 44,000 次描述扬声器位置的数字列表,频率即音高,440Hz 只是人为约定的基准。
2. 音色来自你没要求的频率 — 任何乐器发出的都不是单一频率,而是基频的整数倍(泛音列)。不同波形(正弦、三角、方波、锯齿波)本质上是泛音配方的差异,这解释了为什么小提琴和小号音色不同。
3. 八度是频率翻倍,音高是乘法关系 — 220Hz、440Hz、880Hz 听起来是"同一个音",因为高八度的所有泛音都包含在低八度的泛音列中。因此整个音高问题简化为"如何把倍频区间分割"。
4. 简单整数比听起来和谐 — 2:1(八度)、3:2(五度)、4:3(四度)、5:4(大三度)听起来协和,是因为它们的泛音列有大量重叠;而复杂比例(如 √2)产生拍频和粗糙感。协和的本质是耳朵能快速找到重复模式。
5. 十二音律是数学妥协 — 纯五度(3:2)叠 12 次不等于 7 个八度(2^7),这个无法修复的误差叫"毕达哥拉斯音差"。现代十二平均律将八度均分为 12 份(每份是 2 的 12 次方根),虽然除了八度都不纯,但让所有调都能用。12 之所以被选中,是因为它是第一个能把五度误差控制在约 0.1% 以内的数字。
6. 音阶是间隔数组 — 大调音阶
7. 和弦是隔一个音取的堆叠 — 三和弦
8. 调内七和弦是自然涌现的 — 在一个大调音阶上,从七个音级分别构建三和弦,会自动得到:I(大三)、ii(小三)、iii(小三)、IV(大三)、V(大三)、vi(小三)、vii°(减三)。罗马数字标记是相对寻址,移调只需加一个常数。
9. 张力与解决有物理基础 — V7 → I 是最强的解决感,因为 V 和弦中的 B(导音)距 I 的根音只差半音,且 V7 包含三全音(B-F,√2 比例,最不稳定),这两个音分别向相反方向移动半音到达稳定位置。
10. 乐谱是带 header 的序列化格式 — 五线谱本质是针对"实时阅读、手在忙"场景优化的数据格式:纵轴是音阶度数(非线性频率),谱号定义坐标原点,升降号是 escape hatch,调号是 DRY 原则(常量提升),时值是 2 的负幂次,附点是二进制分数,速度(BPM)把拍子映射到秒。
URL:
https://runjs.app/blog/music-theory-for-programmers
标签:
#音乐理论 #编程 #Web_Audio_API #声学物理 #数学原理 #计算机科学
总结:
本文从物理和算术的第一性原理出发,用 JavaScript 代码逐步推导出整个西方音乐理论体系。作者不依赖记忆,而是通过编程和听觉验证,解释了为什么音乐有十二个音、为什么大调音阶是那个形状、为什么和弦听起来和谐,以及乐谱本质上是一种序列化格式。核心洞察是:音乐理论并非 arbitrary 的约定,而是物理(泛音列)和数学(简单整数比)的自然结果。
文章要点:
1. 声音的本质是随时间变化的数字 — 音频就是每秒 44,000 次描述扬声器位置的数字列表,频率即音高,440Hz 只是人为约定的基准。
2. 音色来自你没要求的频率 — 任何乐器发出的都不是单一频率,而是基频的整数倍(泛音列)。不同波形(正弦、三角、方波、锯齿波)本质上是泛音配方的差异,这解释了为什么小提琴和小号音色不同。
3. 八度是频率翻倍,音高是乘法关系 — 220Hz、440Hz、880Hz 听起来是"同一个音",因为高八度的所有泛音都包含在低八度的泛音列中。因此整个音高问题简化为"如何把倍频区间分割"。
4. 简单整数比听起来和谐 — 2:1(八度)、3:2(五度)、4:3(四度)、5:4(大三度)听起来协和,是因为它们的泛音列有大量重叠;而复杂比例(如 √2)产生拍频和粗糙感。协和的本质是耳朵能快速找到重复模式。
5. 十二音律是数学妥协 — 纯五度(3:2)叠 12 次不等于 7 个八度(2^7),这个无法修复的误差叫"毕达哥拉斯音差"。现代十二平均律将八度均分为 12 份(每份是 2 的 12 次方根),虽然除了八度都不纯,但让所有调都能用。12 之所以被选中,是因为它是第一个能把五度误差控制在约 0.1% 以内的数字。
6. 音阶是间隔数组 — 大调音阶
[2,2,1,2,2,2,1] 只是一个七元素数组,加起来为 12。自然小调是它的旋转(从第 5 位开始),七种调式则是同一数组的 7 种循环移位,这让作者感叹"音乐理论终于不再像 arbitrary 的 trivia"。7. 和弦是隔一个音取的堆叠 — 三和弦
[0,2,4] 取音阶中每隔一个的音,大三和弦 [0,4,7] 与小三和弦 [0,3,7] 只差一个半音,却代表了西方音乐两大情感极。七和弦加入第四个音后,音乐开始从"圣咏"变成"爵士"。8. 调内七和弦是自然涌现的 — 在一个大调音阶上,从七个音级分别构建三和弦,会自动得到:I(大三)、ii(小三)、iii(小三)、IV(大三)、V(大三)、vi(小三)、vii°(减三)。罗马数字标记是相对寻址,移调只需加一个常数。
9. 张力与解决有物理基础 — V7 → I 是最强的解决感,因为 V 和弦中的 B(导音)距 I 的根音只差半音,且 V7 包含三全音(B-F,√2 比例,最不稳定),这两个音分别向相反方向移动半音到达稳定位置。
10. 乐谱是带 header 的序列化格式 — 五线谱本质是针对"实时阅读、手在忙"场景优化的数据格式:纵轴是音阶度数(非线性频率),谱号定义坐标原点,升降号是 escape hatch,调号是 DRY 原则(常量提升),时值是 2 的负幂次,附点是二进制分数,速度(BPM)把拍子映射到秒。
URL:
https://runjs.app/blog/music-theory-for-programmers
《编程 Agent 如何重塑工程、产品和设计》
标签:#AI #编程Agent #软件开发 #产品经理 #系统设计 #VibeCoding
总结:
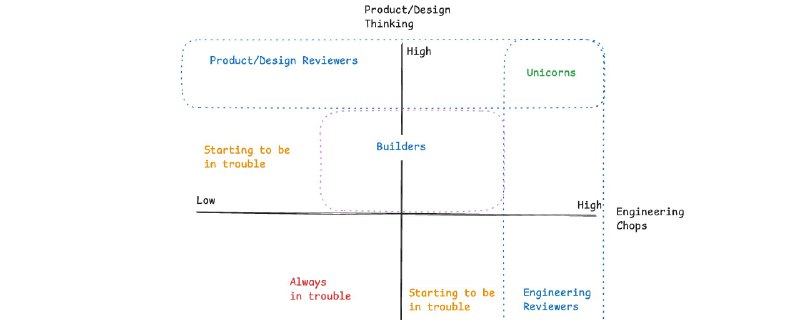
编程 Agent 正在颠覆传统的 EPD(工程、产品、设计)协作模式。当代码生成变得轻而易举,团队的核心价值从"写代码"转向"评审代码"。PRD 不再是流程起点,而是与原型并行的意图说明文档。这场变革让通才价值飙升,也让角色边界变得模糊——你要么是能用 Agent 独立完成功能的建设者,要么是具备顶级系统思维的专业评审者。无论出身产品、设计还是工程,拥有跨领域认知和清晰心智模型的人,将在这个新时代占据绝对优势。
文章要点:
- **PRD 的角色正在蜕变**:传统的"PRD → 设计稿 → 代码"线性流程已终结,但描述产品意图的文档依然重要。未来的 PRD 可能是结构化的、带版本管理的 Prompt,与可运行的代码原型共同构成评审基础。
- **瓶颈从实现转向评审**:当任何人都能快速生成代码原型时,工程、产品和设计的核心价值转变为把关质量——评估架构合理性、用户价值与体验流畅度。评审能力成为新的稀缺资源。
- **通才迎来黄金时代**:能同时驾驭产品思维、设计直觉和工程实现的"多面手"比以往更有影响力,因为他们省去了跨部门沟通的成本,可以直接与 Agent 协作完成端到端的交付。
- **角色分化为建设者与评审者**:团队将呈现两极分化。建设者擅长用 Agent 快速落地想法;评审者则是各领域的系统思维专家,负责把关复杂项目的质量。中间地带的从业者面临最大挑战。
- **产品意识成为全员必修课**:无论是工程师还是设计师,都需要具备判断"该做什么"的能力,否则会产生大量需要他人评审的"垃圾原型",拖累团队效率。
- **AI 放大 PM 的能力差距**:优秀的产品经理能借助 Agent 快速验证洞见,而思考不清晰的 PM 会产生更多低质量原型,造成资源浪费并增加"半成品上线"的风险。
文章URL:
https://baoyu.io/translations/2026-03-11/coding-agents-reshaping-epd
《Python 3.15的JIT编译器重回正轨》
标签:#Python #JIT #CPython #性能优化 #Faster_CPython #编译器 #开源社区
总结:
Python 3.15的JIT编译器开发取得突破性进展,在失去主要赞助商后通过社区协作成功实现性能目标。目前macOS AArch64平台比解释器快11-12%,Linux x86_64快5-6%,提前完成预定目标。文章强调了团队建设、任务分解和幸运的技术决策(如追踪记录解释器和引用计数消除)对项目成功的关键作用。
文章要点:
- **性能目标提前达成**:Python 3.15的JIT在macOS AArch64上比尾调用解释器快11-12%,在Linux x86_64上比标准解释器快5-6%,提前一年多完成目标
- **从困境中重生**:Faster CPython团队2025年失去主要赞助商后,通过社区托管模式维持开发,作者曾怀疑JIT项目能否成功
- **降低"巴士因子"风险**:团队计划在JIT的前端(区域选择器)、中端(优化器)、后端(代码生成器)各配备2名活跃维护者,目前中端已有4名贡献者
- **任务分解吸引新人**:将复杂优化问题拆分为简单任务(如"优化单条指令"),提供详细可操作的指导,让无JIT经验的C程序员也能参与,共11人参与核心重构
- **关键技术决策**:Brandt建议改用追踪式前端,Mark建议双分派表机制,意外地将追踪解释器性能从慢6%提升到快1.x%,并将JIT代码覆盖率提升50%
- **引用计数消除优化**:消除每条Python指令的分支操作,这一优化易于并行化且适合教学,是3.15版本的主要优化方向
- **基础设施支撑**:Savannah Ostrowski一人搭建了等效于整个基础设施团队的CI系统,每日性能测试帮助快速发现回归问题
文章URL:
https://fidget-spinner.github.io/posts/jit-on-track.html
