

Now vibe coding, so learning hammer FE ?
《React 编译器到底做了什么》
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
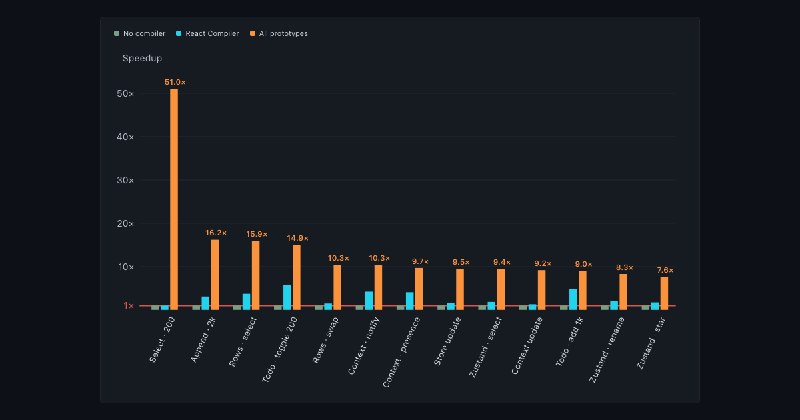
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
_c() 缓存槽位中,首次渲染写入缓存,后续渲染直接复用,本质上相当于给所有内容自动套上了 memo。2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
props.method() 拆成属性加载 + 普通调用),有的推断信息,有的做变换优化。4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
=== 判断挪进 selector 内部这一小改动就能带来数倍提升,编译器完全可以自动完成这类分析(200 次选择从 311.5 ms 降到 48.9 ms)。8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
《Vitest 5.0 正式发布》
标签:
#前端 #JavaScript #Vitest #测试框架 #单元测试 #性能优化 #BrowserMode #MockAPI #基准测试 #断言改进 #代码覆盖率
总结:
Vitest 5.0 于 2026 年 9 月 3 日正式发布,本次大版本以性能优化为核心,同时带来 Trace View 追踪视图、嵌套项目配置、
文章要点:
1. 性能大幅提升:通过共享 Vite 服务器、稳定的文件系统模块缓存、减少主进程与 worker 往返、加速 vm 池与浏览器模式等优化,整体测试速度提升 8%–53%,大型项目(1,280 模块)运行时间从 7.24s 降至 5.83s。
2. **新增
Browser Mode 内置 Trace Viewew**:开启
嵌套项目与配置继承继承**:内联项目默认继承根配置(无需
5. **新 API
8. **Mock
9. **更严格的断言行为**:未 await 的异步断言(
10. **
11. **报告器统一输出目录**:所有报告器输出集中到
12. **其他实用改进**:新增
13. **破坏性变更**:要求 Vite >= 6.4.0 和 Node.js >= 22.12.0,升级前建议查阅迁移指南。
URL:
https://vitest.dev/blog/vitest-5
标签:
#前端 #JavaScript #Vitest #测试框架 #单元测试 #性能优化 #BrowserMode #MockAPI #基准测试 #断言改进 #代码覆盖率
总结:
Vitest 5.0 于 2026 年 9 月 3 日正式发布,本次大版本以性能优化为核心,同时带来 Trace View 追踪视图、嵌套项目配置、
vi.when 条件 Mock、基准测试重写等多项重要更新,并默认启用更严格的断言与 clearMocks 行为,要求 Vite >= 6.4.0 和 Node.js >= 22.12.0。文章要点:
1. 性能大幅提升:通过共享 Vite 服务器、稳定的文件系统模块缓存、减少主进程与 worker 往返、加速 vm 池与浏览器模式等优化,整体测试速度提升 8%–53%,大型项目(1,280 模块)运行时间从 7.24s 降至 5.83s。
2. **新增
vitest doctor 诊断工具**:自动运行替代配置并推荐更快的选项,同时默认输出性能提示,帮助用户发现配置瓶颈。Browser Mode 内置 Trace Viewew**:开启
browser.traceView 后,可记录交互、断言和 DOM 快照,支持逐步回放测试过程,便于调试 CI 失败。嵌套项目与配置继承继承**:内联项目默认继承根配置(无需
extends: true),被引用的配置文件可声明自己的 projects,支持多级嵌套结构。5. **新 API
vi.when**:支持按参数定义不同的 Mock 返回值,支持深度相等和 expect.any() 等非对称匹配器,并可限制调用基准测试 API 重写API 重写**:bench 变为测试上下文 fixture,可在常规 test() 中使用,支持 fixtures、生命周期钩子、重试和断言,结果可存储并与基线定位器错误显示 ARIA 树ARIA 树**:浏览器模式下定位失败时,同时打印 ARIA 快照和 HTML,帮助快速理解 getByRole 等查询的匹配逻辑;定位器默认启用严格模式。8. **Mock
Temporal API**:假计时器现在同时模拟 Temporal 和 Date,适用于 vi.useFakeTimers() 和 vi.setSystemTime()。9. **更严格的断言行为**:未 await 的异步断言(
resolves、rejects 等)现在会导致测试失败;expect.poll 超时后拒绝并支持 AbortSignal 取消。10. **
clearMocks 默认启用**:每个测试前自动清除 Mock 调用历史,避免测试间报告器统一输出目录。11. **报告器统一输出目录**:所有报告器输出集中到
.vitest 目录,减少 .gitignore 配置;HTML 报告器支持 singleFile 选项生成单文件报告。12. **其他实用改进**:新增
--repeats 选项重复运行测试以排查 flaky 测试;injectCjsGlobals 可禁用 CJS 全局注入;覆盖率工具切换到维护中的 @vitest/istanbuljs 包。13. **破坏性变更**:要求 Vite >= 6.4.0 和 Node.js >= 22.12.0,升级前建议查阅迁移指南。
URL:
https://vitest.dev/blog/vitest-5
《smol-toml:小而快的 TOML 解析与序列化库》
标签:
#开发工具 #JavaScript #TOML #NPM #性能优化 #配置解析 #BigInt #TemporalAPI
总结:
smol-toml 是一款轻量、高速且遵循 TOML 1.1.0 规范的 JavaScript 解析与序列化库,目前已是 npm 上下载量最高的 TOML 解析器,被众多框架和工具在生产环境中广泛使用。
文章要点:
1. 小而快的 TOML 解析器:smol-toml 主打"小体积、高性能、正确性",在保持与 TOML v1.1.0 规范高度兼容的同时,解析和序列化速度均领先同类库,是 npm 上最受欢迎的 TOML 解析器。
2. API 简洁易用:提供
3. 整数与 BigInt 支持:默认情况下整数和浮点数都解析为 JavaScript Number(即浮点数),丢失类型信息且不支持超过 53 位的整数;可通过
4. 日期时间处理灵活:使用扩展的
5. 性能表现亮眼:在基准测试中,smol-toml 的解析速度仅次于走捷径牺牲正确性的 fast-toml,序列化速度则全面领先;处理 5MB 大文件时,解析和序列化性能均大幅优于 @iarna/toml、@ltd/j-toml 等主流库。
6. 已知局限透明公开:由于 JavaScript 语言限制,不会拒绝无效 UTF-8 字符串和某些无效日期(如 2 月 30 日会被解析为 3 月 2 日);具体跳过的测试项和原因在
URL:
https://github.com/squirrelchat/smol-toml
标签:
#开发工具 #JavaScript #TOML #NPM #性能优化 #配置解析 #BigInt #TemporalAPI
总结:
smol-toml 是一款轻量、高速且遵循 TOML 1.1.0 规范的 JavaScript 解析与序列化库,目前已是 npm 上下载量最高的 TOML 解析器,被众多框架和工具在生产环境中广泛使用。
文章要点:
1. 小而快的 TOML 解析器:smol-toml 主打"小体积、高性能、正确性",在保持与 TOML v1.1.0 规范高度兼容的同时,解析和序列化速度均领先同类库,是 npm 上最受欢迎的 TOML 解析器。
2. API 简洁易用:提供
parse() 和 stringify() 两个核心方法,用法类似 JSON 全局对象;stringify 会自动忽略对象中的 undefined 和 null 值,但数组中的这些值会被拒绝。3. 整数与 BigInt 支持:默认情况下整数和浮点数都解析为 JavaScript Number(即浮点数),丢失类型信息且不支持超过 53 位的整数;可通过
integersAsBigInt: true 选项启用 BigInt 支持,实现端到端类型保留。4. 日期时间处理灵活:使用扩展的
Date 对象(TomlDate)表示 TOML 的所有日期类型,支持 Offset Date Time、Local Date Time、Local Date 和 Local Time;序列化时支持 Temporal API,但时区信息会转换为偏移量。5. 性能表现亮眼:在基准测试中,smol-toml 的解析速度仅次于走捷径牺牲正确性的 fast-toml,序列化速度则全面领先;处理 5MB 大文件时,解析和序列化性能均大幅优于 @iarna/toml、@ltd/j-toml 等主流库。
6. 已知局限透明公开:由于 JavaScript 语言限制,不会拒绝无效 UTF-8 字符串和某些无效日期(如 2 月 30 日会被解析为 3 月 2 日);具体跳过的测试项和原因在
run-toml-test.bash 中有详细说明。URL:
https://github.com/squirrelchat/smol-toml
《Python 3.15的JIT编译器重回正轨》
标签:#Python #JIT #CPython #性能优化 #Faster_CPython #编译器 #开源社区
总结:
Python 3.15的JIT编译器开发取得突破性进展,在失去主要赞助商后通过社区协作成功实现性能目标。目前macOS AArch64平台比解释器快11-12%,Linux x86_64快5-6%,提前完成预定目标。文章强调了团队建设、任务分解和幸运的技术决策(如追踪记录解释器和引用计数消除)对项目成功的关键作用。
文章要点:
- **性能目标提前达成**:Python 3.15的JIT在macOS AArch64上比尾调用解释器快11-12%,在Linux x86_64上比标准解释器快5-6%,提前一年多完成目标
- **从困境中重生**:Faster CPython团队2025年失去主要赞助商后,通过社区托管模式维持开发,作者曾怀疑JIT项目能否成功
- **降低"巴士因子"风险**:团队计划在JIT的前端(区域选择器)、中端(优化器)、后端(代码生成器)各配备2名活跃维护者,目前中端已有4名贡献者
- **任务分解吸引新人**:将复杂优化问题拆分为简单任务(如"优化单条指令"),提供详细可操作的指导,让无JIT经验的C程序员也能参与,共11人参与核心重构
- **关键技术决策**:Brandt建议改用追踪式前端,Mark建议双分派表机制,意外地将追踪解释器性能从慢6%提升到快1.x%,并将JIT代码覆盖率提升50%
- **引用计数消除优化**:消除每条Python指令的分支操作,这一优化易于并行化且适合教学,是3.15版本的主要优化方向
- **基础设施支撑**:Savannah Ostrowski一人搭建了等效于整个基础设施团队的CI系统,每日性能测试帮助快速发现回归问题
文章URL:
https://fidget-spinner.github.io/posts/jit-on-track.html
《前端内存泄漏:500仓库静态分析与五场景基准测试实证研究》
标签:#前端 #内存泄漏 #性能优化 #React #Vue #Angular #useEffect #静态分析 #基准测试
总结(一段话概括)
该研究对500个开源前端仓库(React/Vue/Angular)进行AST静态分析,发现86%的代码库存在至少一处缺失清理的内存泄漏模式,共识别55,864个潜在泄漏点,其中定时器清理缺失占比最高(43.9%)。通过五个控制变量的基准测试(各50轮×100次挂载循环)证实:每处未清理模式每次挂载/卸载循环平均泄漏约8KB内存,呈线性累积趋势;而正确清理的版本内存增长接近零(约2KB总计)。研究揭示了内存泄漏在前端生产代码中的普遍性及其对长会话应用(如仪表板、视频会议)的性能威胁,并提供了针对性的修复方案。
文章要点:
- 高普遍性:扫描714,217个文件发现55,864处潜在泄漏,430/500个仓库(86%)存在至少一处缺失清理模式,涵盖Kibana、Next.js等知名项目
- 主要泄漏源:定时器未清理(43.9%,22,384处)居首,其次是事件监听器(19.0%)、订阅未取消(13.9%)、useEffect无清理函数(9.3%)
- 统一泄漏成本:五个跨框架场景(React useEffect、Vue onMounted、Angular subscribe、Vue watch、RAF)均显示每循环约8KB线性内存增长,标准差极小(±0.6–37KB),而正确清理版本仅2-3KB噪声基线
- 统计显著性:效应量Cohen's d > 200(BAD与GOOD分布零重叠),p < 0.001,统计功效超99.99%,证实清理缺失是内存占用的主导变量
- 框架差异:React占发现总量62.3%(样本加权),Vue的
- 高危上下文:组件生命周期代码(32.9%)和事件绑定(24.5%)是高发区,因路由切换、标签页切换会频繁触发挂载/卸载
- 实际影响:单泄漏模式200次导航累积1.6MB,多模式叠加可达8MB/会话,足以触发移动端浏览器(iOS Safari 80-120MB阈值)杀标签页
- 修复成本低:92.3%的修复仅需单行代码(返回清理函数、存储stop handle、takeUntil模式),ROI极高
- 工具链缺口:现有ESLint规则(如react-hooks/exhaustive-deps)无法检测清理函数缺失,需借助AST级静态分析或生产环境堆内存监控
文章URL
https://stackinsight.dev/blog/memory-leak-empirical-study/
标签:#前端 #内存泄漏 #性能优化 #React #Vue #Angular #useEffect #静态分析 #基准测试
总结(一段话概括)
该研究对500个开源前端仓库(React/Vue/Angular)进行AST静态分析,发现86%的代码库存在至少一处缺失清理的内存泄漏模式,共识别55,864个潜在泄漏点,其中定时器清理缺失占比最高(43.9%)。通过五个控制变量的基准测试(各50轮×100次挂载循环)证实:每处未清理模式每次挂载/卸载循环平均泄漏约8KB内存,呈线性累积趋势;而正确清理的版本内存增长接近零(约2KB总计)。研究揭示了内存泄漏在前端生产代码中的普遍性及其对长会话应用(如仪表板、视频会议)的性能威胁,并提供了针对性的修复方案。
文章要点:
- 高普遍性:扫描714,217个文件发现55,864处潜在泄漏,430/500个仓库(86%)存在至少一处缺失清理模式,涵盖Kibana、Next.js等知名项目
- 主要泄漏源:定时器未清理(43.9%,22,384处)居首,其次是事件监听器(19.0%)、订阅未取消(13.9%)、useEffect无清理函数(9.3%)
- 统一泄漏成本:五个跨框架场景(React useEffect、Vue onMounted、Angular subscribe、Vue watch、RAF)均显示每循环约8KB线性内存增长,标准差极小(±0.6–37KB),而正确清理版本仅2-3KB噪声基线
- 统计显著性:效应量Cohen's d > 200(BAD与GOOD分布零重叠),p < 0.001,统计功效超99.99%,证实清理缺失是内存占用的主导变量
- 框架差异:React占发现总量62.3%(样本加权),Vue的
watch未存储stop handle(3,989处)和Angular的.subscribe()未取消(5,327处)均为高危模式- 高危上下文:组件生命周期代码(32.9%)和事件绑定(24.5%)是高发区,因路由切换、标签页切换会频繁触发挂载/卸载
- 实际影响:单泄漏模式200次导航累积1.6MB,多模式叠加可达8MB/会话,足以触发移动端浏览器(iOS Safari 80-120MB阈值)杀标签页
- 修复成本低:92.3%的修复仅需单行代码(返回清理函数、存储stop handle、takeUntil模式),ROI极高
- 工具链缺口:现有ESLint规则(如react-hooks/exhaustive-deps)无法检测清理函数缺失,需借助AST级静态分析或生产环境堆内存监控
文章URL
https://stackinsight.dev/blog/memory-leak-empirical-study/
《我们将 Node.js 内存占用减少了一半》
标签:#后端 #Node.js #V8 #性能优化 #内存管理 #Docker
本文介绍了通过启用 V8 引擎的指针压缩(Pointer Compression)技术,在不修改代码的情况下将 Node.js 应用内存占用减少约 50%,且仅带来 2-4% 的平均延迟开销,同时显著降低 P99 延迟。Cloudflare 与 Igalia 合作解决了历史性的"4GB 内存笼"限制,使每个 Worker 线程拥有独立的 4GB 压缩内存空间。
文章要点:
- 技术原理:指针压缩将 64 位指针转为 32 位偏移量,使每个指针从 8 字节减至 4 字节,内存占用减半,代价是每次堆访问需额外的加减法运算
- 历史障碍:此前 Node.js 未默认启用是因所有 Worker 线程共享单一 4GB 内存空间,2024 年 Cloudflare 与 Igalia 合作推出 IsolateGroups 功能,使每个 V8 实例拥有独立的 4GB 压缩内存笼
- 实验结果:在 Next.js 电商应用基准测试中,指针压缩实现内存减半(2GB→1GB),平均延迟仅增加 2.5-4.2%,但 P99 延迟降低 7-43%,最大延迟降低 6-38%,因更小的堆减少了 GC 暂停时间
- 业务价值:可显著降低 Kubernetes 集群成本、提升多租户 SaaS 密度、支持边缘计算部署、增加 WebSocket 并发连接数
- 兼容性限制:每个 V8 实例仍受 4GB 堆内存限制;使用旧版 NAN 的原生插件不兼容,但 Node-API 插件不受影响
- 使用方式:通过
链接:https://blog.platformatic.dev/we-cut-nodejs-memory-in-half
标签:#后端 #Node.js #V8 #性能优化 #内存管理 #Docker
本文介绍了通过启用 V8 引擎的指针压缩(Pointer Compression)技术,在不修改代码的情况下将 Node.js 应用内存占用减少约 50%,且仅带来 2-4% 的平均延迟开销,同时显著降低 P99 延迟。Cloudflare 与 Igalia 合作解决了历史性的"4GB 内存笼"限制,使每个 Worker 线程拥有独立的 4GB 压缩内存空间。
文章要点:
- 技术原理:指针压缩将 64 位指针转为 32 位偏移量,使每个指针从 8 字节减至 4 字节,内存占用减半,代价是每次堆访问需额外的加减法运算
- 历史障碍:此前 Node.js 未默认启用是因所有 Worker 线程共享单一 4GB 内存空间,2024 年 Cloudflare 与 Igalia 合作推出 IsolateGroups 功能,使每个 V8 实例拥有独立的 4GB 压缩内存笼
- 实验结果:在 Next.js 电商应用基准测试中,指针压缩实现内存减半(2GB→1GB),平均延迟仅增加 2.5-4.2%,但 P99 延迟降低 7-43%,最大延迟降低 6-38%,因更小的堆减少了 GC 暂停时间
- 业务价值:可显著降低 Kubernetes 集群成本、提升多租户 SaaS 密度、支持边缘计算部署、增加 WebSocket 并发连接数
- 兼容性限制:每个 V8 实例仍受 4GB 堆内存限制;使用旧版 NAN 的原生插件不兼容,但 Node-API 插件不受影响
- 使用方式:通过
platformatic/node-caged Docker 镜像一键替换官方 Node.js 镜像即可启用链接:https://blog.platformatic.dev/we-cut-nodejs-memory-in-half
