

Now vibe coding, so learning hammer FE ?
《React 编译器到底做了什么》
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
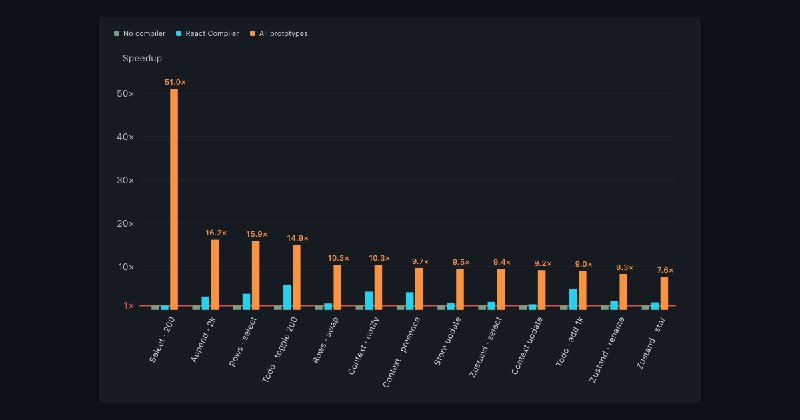
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
_c() 缓存槽位中,首次渲染写入缓存,后续渲染直接复用,本质上相当于给所有内容自动套上了 memo。2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
props.method() 拆成属性加载 + 普通调用),有的推断信息,有的做变换优化。4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
=== 判断挪进 selector 内部这一小改动就能带来数倍提升,编译器完全可以自动完成这类分析(200 次选择从 311.5 ms 降到 48.9 ms)。8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
《在 GitHub Copilot 应用中流畅渲染超大 Pull Request》
标签:
#软件工程 #前端性能优化 #PullRequest #虚拟化渲染 #React #测量调度 #滚动锚定 #性能监控
总结:
文章介绍了 GitHub Copilot 应用如何重构 Pull Request 视图,使其能够流畅处理包含 2,200 个文件、超过 100 万行代码变更和 400 多条内联评论的超大型 PR。核心挑战在于评论高度的动态性——与代码行不同,评论高度取决于 Markdown 换行、可展开区块、回复框和图片加载等渲染时才能确定的因素。团队通过分离确定性与动态几何、实现智能测量调度器、采用滚动锚定技术,并建立自动化测量循环来解决这一问题,最终实现了百万行 diff 的流畅浏览体验。
文章要点:
1. 代码与评论的几何分离:代码行高度固定且可预先计算,而评论高度动态变化。团队将文档高度分为确定性代码高度(精确前缀和)和动态块高度(估算后测量),两者独立管理,避免评论调整时重建整个代码几何。
2. 智能测量调度器:放弃每块一个 ResizeObserver 的方案(会触发反馈循环),改为单一的空闲和滚动门控测量通道。仅在视口附近约 2400px 范围内进行测量,屏幕上的块优先批量读取,离屏块最多做一次有限渲染,超过视口高度的块跳过测量。
3. 滚动锚定技术:当测量高度与估算不符时,通过身份而非像素来校正——记录用户锚定的行或块,应用高度增量后,将同一锚点解析到新像素位置并滚动,确保用户视线不跳动。区分用户滚动与程序滚动,避免侧边栏切换等操作误触发保护机制。
4. 数据管道优化:流式传输结构优先于内容,文件树和元数据在文档加载时即可渲染;语法高亮在主线程外运行,行先以纯文本显示;释放文档时保留最近几个 diff 的缓存,平衡内存与返回时的加载速度。
5. 自动化测量循环:建立"变更→测量→改进"的无人值守循环,包括无头探针车道(声明式流程 + 生产环境插桩)和自动驾驶仪(驱动真实桌面应用),通过健康信号(如无未填充间隙、评论块非空)自动检测问题,实现机械式调试而非人工复现。
URL:
https://github.blog/engineering/user-experience/rendering-huge-pull-requests-in-the-github-copilot-app/
《框架还重要吗?》
标签:
#编程 #Web开发 #AI编程 #前端框架 #React #软件工程 #技术趋势 #VibeCoding
总结:
这是一篇探讨在 AI 编程时代 Web 框架是否仍然重要的深度分析文章。作者 Brooks Lybrand 作为拥有三年开源框架开发经验的前端工程师,针对"模型已经足够好,框架选择不再重要"的流行观点进行了系统性反驳,论证了框架在提供抽象、结构和约束方面的核心价值,并呼吁行业继续创新和构建新框架。
文章要点:
1. **对"React 已赢"论的质疑**:作者指出当前流行观点认为由于 LLM 训练数据中 React 代码最多,模型最熟悉 React,因此无需尝试其他框架。但他认为这种逻辑存在矛盾——如果框架真的不重要,那连 React 都不需要,直接用 Web Components 或让 AI 生成原生代码即可。
2. **框架的本质价值**:作者将框架的价值精炼为三点:**提供抽象(Abstractions)、结构(Structure)和约束(Constraints)**。这些价值不仅适用于人类开发者,对 AI 编程同样关键——良好的抽象能避免 AI 重复造轮子或创建混乱的临时方案;清晰的结构帮助 AI 生成可维护的代码;明确的约束(如类型检查、测试)能防止 AI 在迭代中破坏系统。
3. **AI 时代框架的隐性存在**:引用 React 核心团队成员 Ricky Hanlon 的观点"你要么使用框架,要么构建框架",作者强调即使不显式选择框架,AI 在生成代码时也会隐式地创建框架。与其让 AI 生成一个缺乏维护、充满临时补丁的"隐性框架",不如使用经过实战检验、文档完善的开源框架。
4. **开发者体验(DX)的重构**:通过分析 HMR(热模块替换)、TypeScript 和
5. **框架战争的终结与新机遇**:作者认为 2013-2024 年的"框架战争"已经结束,人们不再渴望为框架争论,但这不意味着框架不再重要。他指出当前框架领域仍存在明显不足,特别是缺乏真正全栈、基于 Web 标准、易于 AI 协作且代码可理解的 JavaScript 框架。
6. **对未来的呼吁**:尽管承认 AI 正在重塑软件开发,且没人知道其长期影响,作者仍坚持认为认为"所有问题都已解决"是一种颓废的态度。他呼吁继续构建新框架,探索更好的抽象和模式,而不是停留在"现有框架足够好"的舒适区。
URL:
https://brookslybrand.com/posts/do-frameworks-matter-anymore/
> 个人觉得有点片面化,remix 脱离 react 转而用 preact 自创轮子
标签:
#编程 #Web开发 #AI编程 #前端框架 #React #软件工程 #技术趋势 #VibeCoding
总结:
这是一篇探讨在 AI 编程时代 Web 框架是否仍然重要的深度分析文章。作者 Brooks Lybrand 作为拥有三年开源框架开发经验的前端工程师,针对"模型已经足够好,框架选择不再重要"的流行观点进行了系统性反驳,论证了框架在提供抽象、结构和约束方面的核心价值,并呼吁行业继续创新和构建新框架。
文章要点:
1. **对"React 已赢"论的质疑**:作者指出当前流行观点认为由于 LLM 训练数据中 React 代码最多,模型最熟悉 React,因此无需尝试其他框架。但他认为这种逻辑存在矛盾——如果框架真的不重要,那连 React 都不需要,直接用 Web Components 或让 AI 生成原生代码即可。
2. **框架的本质价值**:作者将框架的价值精炼为三点:**提供抽象(Abstractions)、结构(Structure)和约束(Constraints)**。这些价值不仅适用于人类开发者,对 AI 编程同样关键——良好的抽象能避免 AI 重复造轮子或创建混乱的临时方案;清晰的结构帮助 AI 生成可维护的代码;明确的约束(如类型检查、测试)能防止 AI 在迭代中破坏系统。
3. **AI 时代框架的隐性存在**:引用 React 核心团队成员 Ricky Hanlon 的观点"你要么使用框架,要么构建框架",作者强调即使不显式选择框架,AI 在生成代码时也会隐式地创建框架。与其让 AI 生成一个缺乏维护、充满临时补丁的"隐性框架",不如使用经过实战检验、文档完善的开源框架。
4. **开发者体验(DX)的重构**:通过分析 HMR(热模块替换)、TypeScript 和
useEffect 等具体技术,作者说明某些传统 DX 功能对人类开发者的价值正在转变,但对 AI 编程仍至关重要。例如 TypeScript 的类型约束能有效防止 AI 在复杂应用中引入错误,而 useEffect 这类强大但易误用的抽象则应该避免让 AI 随意使用。5. **框架战争的终结与新机遇**:作者认为 2013-2024 年的"框架战争"已经结束,人们不再渴望为框架争论,但这不意味着框架不再重要。他指出当前框架领域仍存在明显不足,特别是缺乏真正全栈、基于 Web 标准、易于 AI 协作且代码可理解的 JavaScript 框架。
6. **对未来的呼吁**:尽管承认 AI 正在重塑软件开发,且没人知道其长期影响,作者仍坚持认为认为"所有问题都已解决"是一种颓废的态度。他呼吁继续构建新框架,探索更好的抽象和模式,而不是停留在"现有框架足够好"的舒适区。
URL:
https://brookslybrand.com/posts/do-frameworks-matter-anymore/
> 个人觉得有点片面化,remix 脱离 react 转而用 preact 自创轮子
《用 AI 定制框架替换 Next.js:一个静态网站的“超个性化”重构实验》
标签:
#Web开发 #前端工程 #AI辅助编程 #NextJs #静态网站 #自定义框架 #性能优化 #Vercel部署
总结:
作者 Max Leiter 用 Claude Code(Fable 5 架构、Opus 实现)在约 3 小时内把个人博客从 Next.js 迁移到了一个为站点量身定制的静态构建框架。新方案把全站编译成纯 HTML,按需加载少量 Preact islands,结果页面体积、Lighthouse 分数、构建时间全面大幅优于 Next.js;代价是放弃了框架生态的无数隐性优化,后续维护与安全问题也由自己承担。
文章要点:
1. 作者让 AI “按需造一个比 Next.js 更快的专属框架”,核心思路是只保留这个网站真正用到的 Next.js 功能,而不是继续背着整个框架跑。
2. 新框架本质上是一个构建脚本:读取文章目录,用 React 在服务端渲染每条路由为静态 index.html,再按 Vercel Build Output API 输出,M2 MacBook 上热构建只要约 0.5 秒。
3. 性能提升非常夸张:首页 JS 从 208 KB 降到 2.3 KB(约 -99%),移动端 LCP 从 2.4 秒降到 1.3 秒,整页重量从 1153 KB 降到 78 KB,Lighthouse 直接冲到 100 分。
4. 博客文章页同样收益明显:HTML 更小、JS 只剩 2.3 KB,移动端 LCP 从 2.2 秒降到 1.1 秒,页面重量从 405 KB 降到 57 KB,软导航也改成更轻的 partial/prerender 方案。
5. 交互没有消失,而是改成“islands”模式:桌面窗口管理器和命令面板用 Preact 组件按需水合,命令面板首次按 Cmd+K 才加载,Preact 兼容层只有约 7 KB,比 React 的 52 KB 轻很多。
6. 构建链路保留原有体验:MDX 仍在构建期用同一套 remark/rehype 插件编译,shiki 在构建时同时输出两套主题的代码高亮,所以切换主题不需要额外 JS。
7. AI 还写了一个“parity harness”,对旧站 101 条路由做快照,对比 head、正文和代码块,结果抓出了 8 篇未发布文章泄漏进 RSS、以及一张 404 的 OG 图这类真实问题。
8. 整个实验花费约 669 美元,API 运行 8 小时 27 分,代码新增 20914 行、删除 2022 行,大约用掉 Claude Code 20x 订阅额度的 10%。
9. 作者认为这种做法的意义在于“只 vendor 你真正需要的东西”:框架被压缩到约 5000 行,人和模型都更容易审查,也能减少供应链攻击面。
10. 缺点也很直白:Next.js 里成百上千个小优化和边界处理 AI 未必都知道或能复现;没有现成的 agent 工具链集成;安全修复不再自动从上游来;而且网站一旦有问题,bug、安全、功能需求都归你自己管。
11. 文章还记录了两个浏览器层面的坑:Chrome 的跨文档 view transitions 会因 head 里的外部 module script 静默跳过入场动画,所以 runtime 必须内联;Safari 对 Speculation Rules 的 feature detection 需要同时检查 API 支持和 document.prerendering。
12. 作者最后判断:未来可能会出现更多“vendoring”和 agentic rewrite,也就是所谓“slop forks”;更激进的猜测是,框架本身可能会消亡,因为框架真正值钱的是沉淀下来的庞大知识,而这些知识未来可能被蒸馏成 skills 或某种新标准。
URL:
https://maxleiter.com/blog/thank-u-next
《浏览器主线程很昂贵:高性能前端优化实战指南》
标签:
#前端 #Web性能 #浏览器原理 #JavaScript #渲染管线 #WebWorker #动画优化 #交互优化 #性能调优
总结:
本文深入剖析了浏览器主线程作为稀缺资源的工作原理,指出前端性能问题的根源往往不是代码速度慢,而是主线程被长时间占用导致界面冻结。文章系统性地介绍了两大类优化策略:在主线程上"精打细算"(拆分、批处理、优先级排序、延迟执行),以及"完全不用主线程"(利用合成器线程、Web Worker、消除不必要的工作),并通过大量交互式 Demo 帮助读者直观理解每种技术的实际效果。
文章要点:
1. 主线程是性能瓶颈的核心:主线程同时负责运行 JavaScript、样式计算、布局、绘制和事件处理,所有工作排队串行执行。60Hz 屏幕每帧预算约 16.6ms,实际可用仅约 10ms,超过 50ms 的任务会导致界面卡顿。
2. 拆分(Splitting):将大任务切割成小片段,通过
3. 批处理(Batching):将频繁触发的事件(如滚动、输入)合并执行,使用防抖(debounce)和节流(throttle)减少重复劳动。React 的虚拟 DOM 本质上也是一种批处理机制。
4. 优先级排序(Prioritizing):通过自定义队列(基于
5. 延迟执行(Deferring):非必要工作延后处理,包括代码分割、使用
6. 利用合成器线程:使用
7. FLIP 动画技术:对于必须改变布局的动画(如列表重排),先测量初始和最终位置,通过反转和播放
8. Web Worker 处理重计算:将图片处理、大数据解析等纯计算任务转移到 Worker 线程,通过
9. 消除不必要的工作:当数据流入速度超过处理能力时,采用丢弃(旧日志)、合并(只保留最新值)、跳过(缓存 memoization)三种策略,从源头减少工作量。
10. 避免布局抖动(Layout Thrashing):不要交替读写布局属性(如
URL:
https://kciter.so/posts/the-expensive-main-thread/en/
标签:
#前端 #Web性能 #浏览器原理 #JavaScript #渲染管线 #WebWorker #动画优化 #交互优化 #性能调优
总结:
本文深入剖析了浏览器主线程作为稀缺资源的工作原理,指出前端性能问题的根源往往不是代码速度慢,而是主线程被长时间占用导致界面冻结。文章系统性地介绍了两大类优化策略:在主线程上"精打细算"(拆分、批处理、优先级排序、延迟执行),以及"完全不用主线程"(利用合成器线程、Web Worker、消除不必要的工作),并通过大量交互式 Demo 帮助读者直观理解每种技术的实际效果。
文章要点:
1. 主线程是性能瓶颈的核心:主线程同时负责运行 JavaScript、样式计算、布局、绘制和事件处理,所有工作排队串行执行。60Hz 屏幕每帧预算约 16.6ms,实际可用仅约 10ms,超过 50ms 的任务会导致界面卡顿。
2. 拆分(Splitting):将大任务切割成小片段,通过
setTimeout 或 requestAnimationFrame 让出主线程,让浏览器在间隙处理渲染和输入。注意过度拆分会产生额外开销,且 JSON.parse 等原子操作无法拆分。3. 批处理(Batching):将频繁触发的事件(如滚动、输入)合并执行,使用防抖(debounce)和节流(throttle)减少重复劳动。React 的虚拟 DOM 本质上也是一种批处理机制。
4. 优先级排序(Prioritizing):通过自定义队列(基于
MessageChannel)实现任务插队机制,确保用户当前关注的操作(如点击预览图片)优先执行,采用"空闲时预处理,紧急时优先处理"的策略。5. 延迟执行(Deferring):非必要工作延后处理,包括代码分割、使用
IntersectionObserver 实现虚拟列表(只渲染可视区域内容)、离屏时暂停动画等,避免一次性处理全部数据。6. 利用合成器线程:使用
transform 和 opacity 代替 top、left、width 等触发布局的属性做动画,让动画在合成器线程运行,即使主线程繁忙也能保持流畅。7. FLIP 动画技术:对于必须改变布局的动画(如列表重排),先测量初始和最终位置,通过反转和播放
transform 来实现平滑过渡,将布局计算限制为仅一次,动画过程交给合成器。8. Web Worker 处理重计算:将图片处理、大数据解析等纯计算任务转移到 Worker 线程,通过
postMessage 的 Transferable 对象(如 ArrayBuffer)实现零拷贝数据传输,避免主线程冻结。9. 消除不必要的工作:当数据流入速度超过处理能力时,采用丢弃(旧日志)、合并(只保留最新值)、跳过(缓存 memoization)三种策略,从源头减少工作量。
10. 避免布局抖动(Layout Thrashing):不要交替读写布局属性(如
offsetWidth),应先批量读取再批量写入,强制浏览器反复计算布局会严重阻塞主线程。URL:
https://kciter.so/posts/the-expensive-main-thread/en/
《十个防止 AI 代码泛滥的前端项目护栏》
标签:
#前端 #TypeScript #React #AI编程 #代码质量 #ESLint #测试策略 #CI_CD #代码审查 #工程实践
总结:
本文针对 AI 生成代码速度远超人类审查能力的前端项目,提供了一套实用的十项防护清单。核心思路是通过自动化工具链(类型系统、Linter、变异测试、CI 门禁)在代码合并前拦截机械性错误,而非依赖人工逐行审查。
文章要点:
1. 用 OpenAPI 契约替代手写类型:通过 Hey API 等工具从 OpenAPI 规范直接生成 TypeScript 类型、客户端和 Zod 校验,避免 AI 臆造不存在的 API 字段(如
2. 开启严格 TypeScript 配置:启用
3. 把 Linter 当作行为过滤器:使用 SonarJS、react-you-might-not-need-an-effect、vitest/playwright 插件、jsx-a11y 等 ESLint 插件,自动拦截认知复杂度过高、不必要的 Effect、可访问性违规等问题。
4. 设定架构层边界:使用 eslint-plugin-boundaries 或 dependency-cruiser 强制实施分层架构(如 UI 层不得直接访问 API 层),防止 AI 生成的代码逐渐退化为"GitHub 平均水平"的混乱结构。
5. 将重复出现的错误转化为自定义 Linter 规则:当同一种 bug 第二次出现时,立即编写自定义 ESLint 规则禁止该模式。例如禁止在服务层函数中使用
6. 把规则直接喂给 AI 模型:通过项目规则文件(如
7. 用变异测试验证测试有效性:使用 Stryker 故意破坏代码(翻转运算符、反转条件、交换返回值),检查现有测试是否能捕获这些变异。存活的变异体通常暴露"只测形状不测内容"的无效测试。一个项目约 4,700 个变异体在 6 分钟内完成扫描。
8. 用 Knip 清理死代码:Knip 可以检测未使用的文件、导出和依赖,配合自定义可达性脚本填补其盲区,防止 AI 生成大量"以防万一"却无人调用的冗余代码。
9. 用 jscpd 检测重复代码:AI 倾向于在不同地方生成几乎相同的逻辑,jscpd 能发现这些重复,提示抽象机会或错误的复制粘贴。
10. 将所有检查强制设为 CI 门禁:上述所有工具(类型检查、Lint、测试、变异测试、重复检测)必须作为 CI 的强制通过项,而非可选建议,确保 AI 生成的代码无法绕过质量关卡。
11. 成本与局限:这些护栏会产生噪音(误报)、规则过时和新人上手摩擦等成本,建议按"类型 → Lint → 测试 → CI"的顺序渐进式推行。同时需注意,这些检查只能捕获机械性错误,无法识别糟糕的品味或错误的抽象。
URL:
https://evilmartians.com/chronicles/ten-anti-ai-slop-moves-for-frontend-projects-going-faster-than-humans-can-review
标签:
#前端 #TypeScript #React #AI编程 #代码质量 #ESLint #测试策略 #CI_CD #代码审查 #工程实践
总结:
本文针对 AI 生成代码速度远超人类审查能力的前端项目,提供了一套实用的十项防护清单。核心思路是通过自动化工具链(类型系统、Linter、变异测试、CI 门禁)在代码合并前拦截机械性错误,而非依赖人工逐行审查。
文章要点:
1. 用 OpenAPI 契约替代手写类型:通过 Hey API 等工具从 OpenAPI 规范直接生成 TypeScript 类型、客户端和 Zod 校验,避免 AI 臆造不存在的 API 字段(如
user.fullName),让编译器在构建期就报错。2. 开启严格 TypeScript 配置:启用
noUncheckedIndexedAccess 等严格标志,让数组索引访问返回 T | undefined,迫使代码显式处理边界情况,减少 AI 常见的"想当然"代码。3. 把 Linter 当作行为过滤器:使用 SonarJS、react-you-might-not-need-an-effect、vitest/playwright 插件、jsx-a11y 等 ESLint 插件,自动拦截认知复杂度过高、不必要的 Effect、可访问性违规等问题。
4. 设定架构层边界:使用 eslint-plugin-boundaries 或 dependency-cruiser 强制实施分层架构(如 UI 层不得直接访问 API 层),防止 AI 生成的代码逐渐退化为"GitHub 平均水平"的混乱结构。
5. 将重复出现的错误转化为自定义 Linter 规则:当同一种 bug 第二次出现时,立即编写自定义 ESLint 规则禁止该模式。例如禁止在服务层函数中使用
Math.round 和 toFixed,避免双重取整导致的薪资计算错误。6. 把规则直接喂给 AI 模型:通过项目规则文件(如
.cursor/rules、CLAUDE.md)或技能文件(如 react-doctor),将项目约定、架构决策和禁止模式直接提供给 AI,让模型在生成代码时就遵循规范。7. 用变异测试验证测试有效性:使用 Stryker 故意破坏代码(翻转运算符、反转条件、交换返回值),检查现有测试是否能捕获这些变异。存活的变异体通常暴露"只测形状不测内容"的无效测试。一个项目约 4,700 个变异体在 6 分钟内完成扫描。
8. 用 Knip 清理死代码:Knip 可以检测未使用的文件、导出和依赖,配合自定义可达性脚本填补其盲区,防止 AI 生成大量"以防万一"却无人调用的冗余代码。
9. 用 jscpd 检测重复代码:AI 倾向于在不同地方生成几乎相同的逻辑,jscpd 能发现这些重复,提示抽象机会或错误的复制粘贴。
10. 将所有检查强制设为 CI 门禁:上述所有工具(类型检查、Lint、测试、变异测试、重复检测)必须作为 CI 的强制通过项,而非可选建议,确保 AI 生成的代码无法绕过质量关卡。
11. 成本与局限:这些护栏会产生噪音(误报)、规则过时和新人上手摩擦等成本,建议按"类型 → Lint → 测试 → CI"的顺序渐进式推行。同时需注意,这些检查只能捕获机械性错误,无法识别糟糕的品味或错误的抽象。
URL:
https://evilmartians.com/chronicles/ten-anti-ai-slop-moves-for-frontend-projects-going-faster-than-humans-can-review
《Vitest 5.0 正式发布》
标签:
#前端 #JavaScript #Vitest #测试框架 #单元测试 #性能优化 #BrowserMode #MockAPI #基准测试 #断言改进 #代码覆盖率
总结:
Vitest 5.0 于 2026 年 9 月 3 日正式发布,本次大版本以性能优化为核心,同时带来 Trace View 追踪视图、嵌套项目配置、
文章要点:
1. 性能大幅提升:通过共享 Vite 服务器、稳定的文件系统模块缓存、减少主进程与 worker 往返、加速 vm 池与浏览器模式等优化,整体测试速度提升 8%–53%,大型项目(1,280 模块)运行时间从 7.24s 降至 5.83s。
2. **新增
Browser Mode 内置 Trace Viewew**:开启
嵌套项目与配置继承继承**:内联项目默认继承根配置(无需
5. **新 API
8. **Mock
9. **更严格的断言行为**:未 await 的异步断言(
10. **
11. **报告器统一输出目录**:所有报告器输出集中到
12. **其他实用改进**:新增
13. **破坏性变更**:要求 Vite >= 6.4.0 和 Node.js >= 22.12.0,升级前建议查阅迁移指南。
URL:
https://vitest.dev/blog/vitest-5
标签:
#前端 #JavaScript #Vitest #测试框架 #单元测试 #性能优化 #BrowserMode #MockAPI #基准测试 #断言改进 #代码覆盖率
总结:
Vitest 5.0 于 2026 年 9 月 3 日正式发布,本次大版本以性能优化为核心,同时带来 Trace View 追踪视图、嵌套项目配置、
vi.when 条件 Mock、基准测试重写等多项重要更新,并默认启用更严格的断言与 clearMocks 行为,要求 Vite >= 6.4.0 和 Node.js >= 22.12.0。文章要点:
1. 性能大幅提升:通过共享 Vite 服务器、稳定的文件系统模块缓存、减少主进程与 worker 往返、加速 vm 池与浏览器模式等优化,整体测试速度提升 8%–53%,大型项目(1,280 模块)运行时间从 7.24s 降至 5.83s。
2. **新增
vitest doctor 诊断工具**:自动运行替代配置并推荐更快的选项,同时默认输出性能提示,帮助用户发现配置瓶颈。Browser Mode 内置 Trace Viewew**:开启
browser.traceView 后,可记录交互、断言和 DOM 快照,支持逐步回放测试过程,便于调试 CI 失败。嵌套项目与配置继承继承**:内联项目默认继承根配置(无需
extends: true),被引用的配置文件可声明自己的 projects,支持多级嵌套结构。5. **新 API
vi.when**:支持按参数定义不同的 Mock 返回值,支持深度相等和 expect.any() 等非对称匹配器,并可限制调用基准测试 API 重写API 重写**:bench 变为测试上下文 fixture,可在常规 test() 中使用,支持 fixtures、生命周期钩子、重试和断言,结果可存储并与基线定位器错误显示 ARIA 树ARIA 树**:浏览器模式下定位失败时,同时打印 ARIA 快照和 HTML,帮助快速理解 getByRole 等查询的匹配逻辑;定位器默认启用严格模式。8. **Mock
Temporal API**:假计时器现在同时模拟 Temporal 和 Date,适用于 vi.useFakeTimers() 和 vi.setSystemTime()。9. **更严格的断言行为**:未 await 的异步断言(
resolves、rejects 等)现在会导致测试失败;expect.poll 超时后拒绝并支持 AbortSignal 取消。10. **
clearMocks 默认启用**:每个测试前自动清除 Mock 调用历史,避免测试间报告器统一输出目录。11. **报告器统一输出目录**:所有报告器输出集中到
.vitest 目录,减少 .gitignore 配置;HTML 报告器支持 singleFile 选项生成单文件报告。12. **其他实用改进**:新增
--repeats 选项重复运行测试以排查 flaky 测试;injectCjsGlobals 可禁用 CJS 全局注入;覆盖率工具切换到维护中的 @vitest/istanbuljs 包。13. **破坏性变更**:要求 Vite >= 6.4.0 和 Node.js >= 22.12.0,升级前建议查阅迁移指南。
URL:
https://vitest.dev/blog/vitest-5
《你的模块在骗你:ESM 与 CommonJS 的本质差异与陷阱全解析》
标签:
#JavaScript #NodeJS #ESM #CommonJS #模块系统 #前端工程化
总结:
本文深入剖析了 ESM 和 CommonJS 两种模块系统在底层机制上的根本差异——ESM 通过"活绑定"(live bindings)在模块间共享变量引用,而 CommonJS 通过
文章要点:
1. 活绑定 vs 值复制:最经典的陷阱 — ESM 的
2. ESM 的导入会被提升,CommonJS 按执行顺序 — ESM 静态导入在模块体执行前就已经解析、链接并评估依赖,所以
3. 两种系统有独立的缓存 — ESM 和 CommonJS 各自维护自己的模块缓存,URL 查询参数(如
4. 循环依赖的处理方式天差地别 — CommonJS 允许在模块未完全初始化时就返回
5. 跨系统互操作的隐藏复杂性 — ESM 导入 CJS 时,
6. 双包实例风险(Dual-Package Hazard) — 当
7. 发布库的最佳实践 — 用
8. 调试模块问题的检查清单 — 从导入文件的格式、解析到的入口点、返回值形状、本地变量持有的是绑定还是副本、评估是否完成、是否存在循环依赖、模块身份是否一致、是否经过构建工具转换、是否通过打包后的 tarball 测试等 9 个维度系统排查。
9. 九条实践规则 — 新项目优先用 ESM;库优先用命名导出;可变导出视为共享进程状态;CJS 属性会变时保留对象而非解构;移除循环依赖而非绕开;条件/延迟加载用动态
URL:
https://blog.gaborkoos.com/posts/2026-08-14-Your-Modules-Are-Lying-to-You/
标签:
#JavaScript #NodeJS #ESM #CommonJS #模块系统 #前端工程化
总结:
本文深入剖析了 ESM 和 CommonJS 两种模块系统在底层机制上的根本差异——ESM 通过"活绑定"(live bindings)在模块间共享变量引用,而 CommonJS 通过
module.exports 返回一个普通值(通常是对象)。这一差异导致了同名导入在两种系统下行为截然不同:ESM 的命名导入能观察到导出模块的变量重新赋值,CommonJS 的解构赋值则只复制了属性的当前值。文章进一步系统讲解了评估顺序、缓存机制、循环依赖处理、跨系统互操作、双包实例风险等关键话题,并提供了 9 条实践规则和调试清单。文章要点:
1. 活绑定 vs 值复制:最经典的陷阱 — ESM 的
import { status } 是活绑定,导出模块重新赋值后导入方自动看到新值;CommonJS 的 const { status } = require() 是解构赋值,只复制了对象属性的当前值,后续变化不可见。只有保留整个对象 const state = require() 才能观察到属性变更。2. ESM 的导入会被提升,CommonJS 按执行顺序 — ESM 静态导入在模块体执行前就已经解析、链接并评估依赖,所以
import 写在代码中间也不影响执行顺序;CommonJS 的 require() 是普通函数调用,走到哪行才执行哪行。3. 两种系统有独立的缓存 — ESM 和 CommonJS 各自维护自己的模块缓存,URL 查询参数(如
?mode=one)会让同一文件被当作不同模块实例加载两次。条件导出("import" / "require")指向不同文件时,也会产生两个独立的模块实例。4. 循环依赖的处理方式天差地别 — CommonJS 允许在模块未完全初始化时就返回
exports 对象,因此循环依赖中的模块能看到对方"半成品"状态;ESM 则先创建绑定再执行模块体,如果在初始化前读取对方绑定会抛出 ReferenceError: Cannot access before initialization。5. 跨系统互操作的隐藏复杂性 — ESM 导入 CJS 时,
module.exports 作为 default 导出最可靠,命名导出是 Node 静态分析的"快照",不会跟踪后续属性变更;CJS 通过 require() 加载 ESM 时返回的是命名空间对象,需通过 .default 访问默认导出。__esModule 只是工具链约定,不是语言特性。6. 双包实例风险(Dual-Package Hazard) — 当
"import" 和 "require" 指向不同构建文件时,同一个类会被实例化为两个不同的构造函数,instanceof 会返回 false,共享状态(如计数器、注册表)也会分裂成两份。7. 发布库的最佳实践 — 用
.mjs/.cjs 明确文件格式;package.json 中 "type" 字段决定 .js 的解析方式;相对 ESM 导入必须带文件扩展名;用 "exports" 条件导出为不同系统提供入口,但要警惕实例分裂。8. 调试模块问题的检查清单 — 从导入文件的格式、解析到的入口点、返回值形状、本地变量持有的是绑定还是副本、评估是否完成、是否存在循环依赖、模块身份是否一致、是否经过构建工具转换、是否通过打包后的 tarball 测试等 9 个维度系统排查。
9. 九条实践规则 — 新项目优先用 ESM;库优先用命名导出;可变导出视为共享进程状态;CJS 属性会变时保留对象而非解构;移除循环依赖而非绕开;条件/延迟加载用动态
import();包边界显式声明文件格式;假设不同导出目标是不同实例;通过包名而非源码路径测试。URL:
https://blog.gaborkoos.com/posts/2026-08-14-Your-Modules-Are-Lying-to-You/
《TanStack AI 进入 RC 阶段:从 humble chat() 到完整 AI 生态》
标签:
#前端开发 #AI框架 #TanStack #TypeScript #开源
总结:
TanStack AI 正式从早期原型迈入 RC(Release Candidate)阶段,标志着其从一个简单的 LLM 聊天方法,成长为覆盖聊天、媒体生成、MCP、沙箱、Agent 编排等全场景的 AI 开发框架。核心设计哲学是"不锁定用户"——在传输层、提供商、前后端技术栈上都保持中立,同时通过极致的类型安全和统一的 API 模式降低学习成本。项目由三人业余时间维护,完全开源,无商业路线图。
文章要点:
1. 从小 chat() 到大生态 — 最初只有 4 个提供商和一个自定义协议,如今已支持 24+ 提供商,采用 AG-UI 官方协议(被 20+ Agent 框架跨语言支持),并扩展到媒体生成、MCP、沙箱、Agent Harness 等领域。
2. 中间件是架构的核心超能力 — 几乎所有高级功能(持久化、沙箱 Agent、内存、遥测)都以中间件形式接入 chat() 方法,Durability 则通过适配器插入流式响应。Lazy Tool Calling 用一个布尔标志就能降低 Token 成本。
3. 传输层零锁定 — 提供 SSE、WebSocket、HTTP Stream、Cap'n Web 等原生传输原语,客户端通过自定义连接适配器消费流,让你对传输层有端到端的完全控制权。
4. 一套 API 模式打遍所有模态 — 无论是文本生成、图像生成、视频生成、音频生成、转录还是实时音频,API 结构几乎完全相同。学一次模式,换适配器即可,不用学 20 套不同 API。
5. 类型安全是 DNA 级别 — 不支持的模型选项、缺少必填属性、把某提供商专属工具传给不支持的模型……统统在编译期报错。目标是让你在再复杂的应用里也能自信上线。
6. chat() 方法是全能核心 — 支持直接对话 LLM 和沙箱 Agent Harness;内置持久化与 Durability(刷新页面、切换对话后能从断点实时续流);支持 Codex 等 Agent 在远程/本地沙箱中运行;还有 Code Mode(Agent 在 isolate 中写代码并执行,优化性能和成本)。
7. 媒体生成是一等公民 — 实时音频、TTS、图像/视频/音频/音乐生成、转录等全部稳定可用,覆盖 100+ 模型。支持流式直传客户端或一次性生成,两者切换无缝。
8. RAG 与记忆 — 通过 Cohere、OpenRouter 等提供商支持嵌入和重排序;支持所有主流厂商的 Agent 记忆,让 Agent 跨对话记住用户偏好和关键事实。
9. 沙箱与 Agent Harness 不挑提供商 — 不强制你用 Daytona、E2B 或 Vercel Sandboxes,基础设施随你选。支持 Codex、Claude Code、Grok、OpenCode 等 20+ ACP 兼容 Agent,甚至能自建本地编码 Agent。
10. MCP 支持带类型生成 — 不仅能连接外部 MCP 服务器,还能通过 CLI 为远程 MCP 暴露的工具生成类型,保持端到端类型安全。支持连接池和生命周期管理。
11. 持久化与 Durability 是亮点 — 提供存储原语,你只需实现 Store 并通过一致性测试套件验证,接入持久化中间件后,用户一个月后回来也能从断点续聊。Durability 适配器可将流块持久化到内存、Durable Streams 等,用户重连后不会漏掉任何内容——全部配置约 20 行代码。
12. 未来路线图 — 核心架构已锁定,接下来重点在 Agent 工作流与编排(并行运行、定时任务、复杂工作流协调),以及继续补齐提供商生态。完全开源,无商业 upsell,欢迎社区贡献。
URL:
https://tanstack.com/blog/tanstack-ai-rc
《5 个实用的 npx 辅助工具》
标签:
#Web开发 #NodeJs #命令行工具 #Npx #前端工程化 #代码质量 #Markdown #图片优化 #依赖管理 #拼写检查
总结:
文章要点:
1. cspell:一个拼写检查器,适合快速排查拼写错误,建议搭配配置文件使用自定义白名单,运行方式如
2. markdown-link-check:专门检查 Markdown 文件中的链接是否有效,能帮助防止链接失效,推荐配合配置文件使用
3. image-guard:作者自己开发的工具,用于自动化近无损图片压缩,也适合在命令行中快速压缩图片,运行
4. npm-check-updates:快速检查
5. knip:功能比 npm-check-updates 更广,还能检查未使用的文件和导出,但文件和导出检查可能会有误报,运行
URL:https://meiert.com/blog/5-npx-helpers/
标签:
#Web开发 #NodeJs #命令行工具 #Npx #前端工程化 #代码质量 #Markdown #图片优化 #依赖管理 #拼写检查
总结:
文章要点:
1. cspell:一个拼写检查器,适合快速排查拼写错误,建议搭配配置文件使用自定义白名单,运行方式如
npx cspell **/*.md2. markdown-link-check:专门检查 Markdown 文件中的链接是否有效,能帮助防止链接失效,推荐配合配置文件使用
3. image-guard:作者自己开发的工具,用于自动化近无损图片压缩,也适合在命令行中快速压缩图片,运行
npx image-guard 即可4. npm-check-updates:快速检查
package.json 中的依赖是否有更新版本,适合在新仓库工作或手动处理依赖更新时使用5. knip:功能比 npm-check-updates 更广,还能检查未使用的文件和导出,但文件和导出检查可能会有误报,运行
npx knip 即可URL:https://meiert.com/blog/5-npx-helpers/
《Domenic 的 Agentic 编码工作流:2026 年 7 月实战指南》
标签:#前端 #AI_Agent #Claude_Code #ChatGPT #Tailscale #Git_Worktrees #DevOps #远程开发
总结:
Domenic 分享了他脱离企业环境后搭建的一套 AI 辅助开发工作流:以一台常驻开机的 Linux VM 为中枢,通过 Tailscale 构建跨设备私有网络,让 ChatGPT/Claude 桌面应用作为瘦客户端远程操控 Agent。核心亮点包括零审批的"YOLO"安全策略、Git worktrees 实现多 Agent 并行开发、Portless 自动暴露安全预览服务器、VS Code Remote-SSH 审查代码,以及 chezmoi 同步配置。最终效果惊人——他能在火车上用手机连接 VM,让前沿模型修复生产 bug 并直接合并 PR。
文章要点:
1. Linux VM + Tailscale 是地基:Agent 训练数据几乎全是 Bash/Unix 工具,Windows 下寸步难行。用 Ubuntu Server 搭一台可抛弃的 VM,配合 Tailscale 的魔法 SSH 和 HTTPS 证书,无论在哪台设备、哪个 Wi-Fi 下都能无缝接入,还能让 Agent 启动的开发服务器拥有安全上下文。
2. ChatGPT 桌面应用体验完胜 Claude:ChatGPT 原生支持远程 SSH 会话,断线重连优雅、worktree 管理清爽(默认放在
3. Git Worktrees 解锁并行开发:在 VM 上让多个 Agent 同时 hack 同一个仓库而不互相踩脚,ChatGPT 和 Claude 都支持一键勾选 worktree 模式。Agent 会自动处理
4. Portless 让预览服务器"零摩擦":不用改
5. "危险模式"下的生存策略:把
6. 手机修生产 Bug 已成现实:完整闭环——聚会发现 bug → 火车上打开 ChatGPT App → 远程连接 VM 启动修复 → 收到推送通知里的预览链接验证 → 手机审阅 diff 并合并 PR → 到家前 GitHub Actions 已部署上线。这就是未来。
URL:https://domenic.me/agentic-coding-setup/
标签:#前端 #AI_Agent #Claude_Code #ChatGPT #Tailscale #Git_Worktrees #DevOps #远程开发
总结:
Domenic 分享了他脱离企业环境后搭建的一套 AI 辅助开发工作流:以一台常驻开机的 Linux VM 为中枢,通过 Tailscale 构建跨设备私有网络,让 ChatGPT/Claude 桌面应用作为瘦客户端远程操控 Agent。核心亮点包括零审批的"YOLO"安全策略、Git worktrees 实现多 Agent 并行开发、Portless 自动暴露安全预览服务器、VS Code Remote-SSH 审查代码,以及 chezmoi 同步配置。最终效果惊人——他能在火车上用手机连接 VM,让前沿模型修复生产 bug 并直接合并 PR。
文章要点:
1. Linux VM + Tailscale 是地基:Agent 训练数据几乎全是 Bash/Unix 工具,Windows 下寸步难行。用 Ubuntu Server 搭一台可抛弃的 VM,配合 Tailscale 的魔法 SSH 和 HTTPS 证书,无论在哪台设备、哪个 Wi-Fi 下都能无缝接入,还能让 Agent 启动的开发服务器拥有安全上下文。
2. ChatGPT 桌面应用体验完胜 Claude:ChatGPT 原生支持远程 SSH 会话,断线重连优雅、worktree 管理清爽(默认放在
~/.codex/worktrees/);Claude 桌面应用则在 SSH/Remote Control 混合逻辑、会话同步、worktree 目录污染项目等方面表现糟糕,目前只能退而求其次用 Claude Code + tmux。3. Git Worktrees 解锁并行开发:在 VM 上让多个 Agent 同时 hack 同一个仓库而不互相踩脚,ChatGPT 和 Claude 都支持一键勾选 worktree 模式。Agent 会自动处理
origin/main 同步、依赖安装和 .env 复制,人类完全不用操心。4. Portless 让预览服务器"零摩擦":不用改
npm run dev 绑定 0.0.0.0,也不用记端口。tportless 包装器自动把 localhost 服务代理到 Tailscale 专属域名(如 https://agents-base.tail234567.ts.net:8443/),多 Agent 并行时端口自动隔离,且外网无法访问。5. "危险模式"下的生存策略:把
~/.codex/config.toml 和 ~/.claude/settings.json 都设为"永不询问权限",配合 sudo 和 gh CLI 登录,让 Agent 能自主装工具、发 PR、合并代码。风险靠"频繁推送到 GitHub 私有仓库"来对冲——VM 炸了代码也在云端。6. 手机修生产 Bug 已成现实:完整闭环——聚会发现 bug → 火车上打开 ChatGPT App → 远程连接 VM 启动修复 → 收到推送通知里的预览链接验证 → 手机审阅 diff 并合并 PR → 到家前 GitHub Actions 已部署上线。这就是未来。
URL:https://domenic.me/agentic-coding-setup/
《W键在前端:技术与产品的协同进化》
标签:#前端工程化 #Electron #Vite #代码重构 #Monorepo #TailwindCSS #ShadcnUI #ReactRouter #性能优化 #Medal
总结:
文章要点:
1. **从"巨兽组件"说起**:作者用一张拥有30+ props的TextInput截图开场,生动展示了"反模式"组件的恐怖——职责混乱、默认值泛滥、DOM和自定义props杂糅,改一行代码要检查十个角落,开发体验堪比噩梦
2. **宏观手术刀**:不硬啃旧组件,而是先换"土壤"——迁移Monorepo+PNPM解决版本混乱,引入Vite+HMR让Electron本地开发告别"停启地狱",CEO亲自下场当普罗米修斯点火
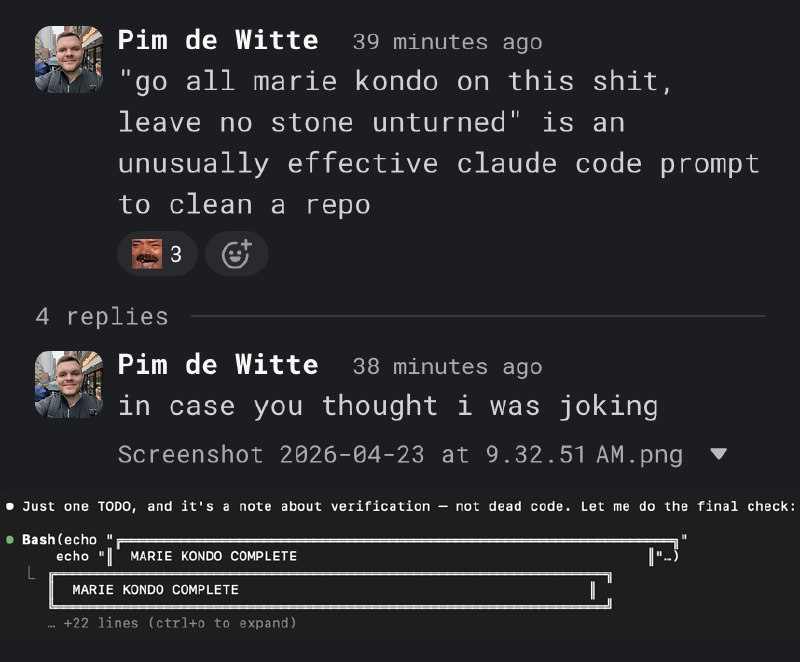
3. **Marie Kondo式删代码**:统一导入路径(包名+清晰路径+文件后缀),减少barrel文件,让AI能精准识别"死代码"。结果疯狂删代码:单PR删除上万行,团队享受"五杀"快感,还提炼出跨平台通用包(utils/hooks/types)
4. **生产环境统一Vite**:干掉Rollup,用Glob Imports做代码分割,配合路由级动态加载,i18n文件懒加载,最终渲染包从巨大体积瘦身到2.7MB,构建速度快到QA都惊呼"嗖嗖嗖"
5. **组件层"换血"**:用Tailwind+Shadcn/Radix UI(后迁Base UI)替代Grommet和Styled Components,给旧组件挂ESLint"红牌"禁止令,同时写迁移指南。React Router v5→v7的大升级也顺势完成,现在搭个新页面只需一天
URL:https://medal.tv/blog/posts/w-key-in-frontend-synergizing-technology-and-product
《MDN 推出官方 MCP 服务器,让 AI 助手实时获取权威 Web 文档》
标签:#前端 #AI工具 #MCP #MDN #浏览器兼容性 #VSCode #Claude
总结:
MDN 官方发布了一款实验性 MCP(Model Context Protocol)服务器,旨在让 LLM 和编程助手直接访问 MDN 的搜索、文档及浏览器兼容性数据(BCD),解决 AI 回答中可能出现的过时或错误信息问题。开发者可通过远程服务或本地部署方式接入,支持 VS Code、Claude Code 等 MCP 兼容客户端,实现编码时一键查询 API 用法和兼容性,无需离开编辑器。
文章要点:
1. 官方出品,权威数据源:这是 MDN 官方推出的 MCP 服务器,直接对接 MDN 的搜索 API、文档 JSON API 以及浏览器兼容性数据(BCD),确保 AI 获取的是最新、最准确的 Web 平台技术资料,而不是训练数据中的"旧知识"
2. 六大核心工具,覆盖开发全场景:提供
3. 远程 + 本地双模式部署:既可以一键接入官方远程服务(
4. 无缝集成主流开发工具:完美支持 VS Code、Claude Code、Cursor 等 MCP 兼容客户端,配置简单,安装后直接在 AI 聊天中调用工具,真正实现"边写代码边查文档"的流畅体验
5. 实验性质,持续迭代中:目前处于实验阶段,Mozilla 会收集查询数据以优化服务(可 opt-out),且保留随时调整或下线服务的权利,建议开发者关注官方动态
URL:
https://developer.mozilla.org/en-US/blog/introducing-mdn-mcp-server/
标签:#前端 #AI工具 #MCP #MDN #浏览器兼容性 #VSCode #Claude
总结:
MDN 官方发布了一款实验性 MCP(Model Context Protocol)服务器,旨在让 LLM 和编程助手直接访问 MDN 的搜索、文档及浏览器兼容性数据(BCD),解决 AI 回答中可能出现的过时或错误信息问题。开发者可通过远程服务或本地部署方式接入,支持 VS Code、Claude Code 等 MCP 兼容客户端,实现编码时一键查询 API 用法和兼容性,无需离开编辑器。
文章要点:
1. 官方出品,权威数据源:这是 MDN 官方推出的 MCP 服务器,直接对接 MDN 的搜索 API、文档 JSON API 以及浏览器兼容性数据(BCD),确保 AI 获取的是最新、最准确的 Web 平台技术资料,而不是训练数据中的"旧知识"
2. 六大核心工具,覆盖开发全场景:提供
mdn_search(关键词搜索)、mdn_doc(获取完整文档)、mdn_compat(浏览器兼容性检查)、mdn_list(浏览 BCD 特性)、mdn_css(CSS 属性定义)、mdn_http(HTTP 参考)等工具,从查文档到看兼容性一站搞定3. 远程 + 本地双模式部署:既可以一键接入官方远程服务(
https://mcp.mdn.mozilla.net/),也可以克隆仓库本地运行,满足对数据隐私有顾虑的团队需求;本地模式支持 MCP Inspector 调试,开发体验友好4. 无缝集成主流开发工具:完美支持 VS Code、Claude Code、Cursor 等 MCP 兼容客户端,配置简单,安装后直接在 AI 聊天中调用工具,真正实现"边写代码边查文档"的流畅体验
5. 实验性质,持续迭代中:目前处于实验阶段,Mozilla 会收集查询数据以优化服务(可 opt-out),且保留随时调整或下线服务的权利,建议开发者关注官方动态
URL:
https://developer.mozilla.org/en-US/blog/introducing-mdn-mcp-server/
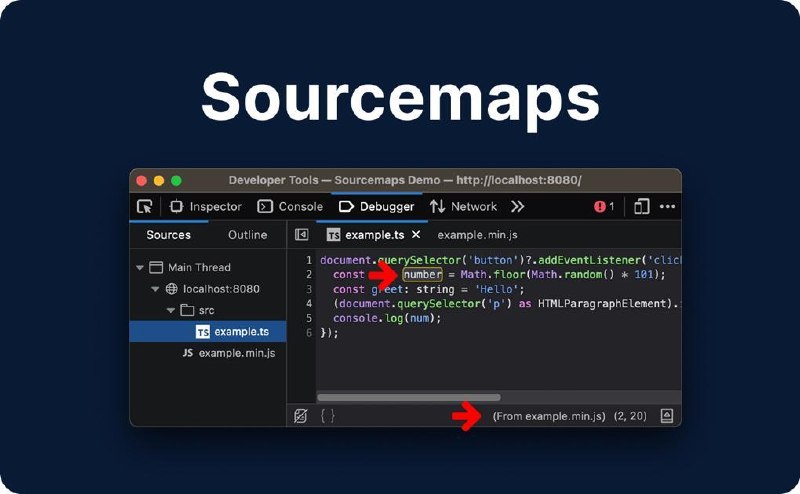
《关于SourceMap你需要知道的一切》
标签:#前端 #SourceMap #Vite #NextJS #Webpack #安全 #CI_CD
总结:SourceMap是前端开发中用于将压缩后的代码映射回原始代码的JSON文件,能极大提升调试体验。但文章重点警示了其安全隐患——默认配置下SourceMap会内联完整源代码,若不慎部署到生产环境,任何人都能通过浏览器或curl获取你的原始代码、目录结构甚至敏感信息。文章以Apple和Anthropic的泄露事件为例,详细说明了如何正确配置构建工具、设置服务器规则以及在CI/CD中自动化检测,防止源代码泄露。
文章要点:
1. SourceMap本质上是一个JSON文件,包含sources(原始文件路径)、names(原始变量名)、mappings(位置映射)和sourcesContent(完整源代码)四个关键字段,能将压缩后的代码精准还原
2. 构建流程通常是TypeScript编译→JS代码→压缩混淆,而SourceMap则反向执行这个流程,让浏览器DevTools能显示原始代码和变量名
3. 最大的安全风险在于sourcesContent默认会内联完整源代码,泄露后不仅暴露目录结构和模块名,还可能泄露API密钥、端点信息和未发布的功能开关
4. Apple在2025年11月因部署SourceMap到生产环境导致App Store前端源码泄露;Anthropic在2026年3月因npm包包含59.8MB的SourceMap文件,导致Claude Code核心代码被永久镜像传播
5. 防护措施包括:构建工具关闭生产环境SourceMap(Vite设sourcemap:false,NextJS设productionBrowserSourceMaps:false)、使用hidden模式仅上传错误追踪平台、服务器对.map请求返回404
6. 建议在CI/CD中添加自动化检查脚本,扫描输出目录中的.map文件,若包含sourcesContent则中断构建,从源头杜绝人为疏忽导致的泄露
URL:https://neciudan.dev/everything-you-need-to-know-about-sourcemaps
《为什么我放弃Next.js和RSC,回归传统SPA与独立后端》
标签:#前端 #Web开发 #React #NextJS #React_Server_Components #SPA #架构设计 #安全 #TanStack #Hono
总结:
作者回顾了自己从Next.js忠实用户到拥抱App Router/RSC,最终回归传统SPA+独立后端的完整历程。文章深入分析了RSC架构带来的心智负担、序列化开销和安全风险,结合2025-2026年多起严重CVE漏洞,论证了将渲染框架与安全边界解耦的必要性,并分享了当前基于React Router+Vite+Hono的简洁技术栈。
文章要点:
1. Next.js的黄金时代:Pages Router时期心智模型清晰,服务端/客户端边界一目了然,文件路由简单易懂,部署零成本
2. App Router带来的混乱:Server/Client Component区分成为负担,"use client"指令传染性强,开发/构建/生产环境缓存行为不一致,服务端客户端边界变得不可见
3. 安全漏洞敲响警钟:2025年CVE-2025-29927中间件绕过(CVSS 9.1)、2025年底RSC核心包10分满分漏洞CVE-2025-55182、2026年初多起Server Function DoS漏洞,攻击面集中在服务端渲染和反序列化环节
4. TanStack并非避风港:2026年5月TanStack遭遇供应链攻击,42个包被投毒,说明换框架不能免疫风险,减少依赖面才是关键
5. 序列化是根本原因:RSC的"无缝"本质是分布式系统的序列化问题,函数、类实例、错误栈都无法透明穿越边界,反序列化不可信输入成为高危攻击面
6. 当前架构选择:React Router框架模式+Vite纯SPA(仅营销页预渲染)+ Hono独立后端,API通过显式HTTP调用,无RSC负载,无服务端序列化
7. 安全设计原则:认证授权在API层强制执行,前端中间件只做UX跳转,CORS/CSRF/验证码/限流全部在可控的后端实现,与渲染框架彻底解耦
8. 核心收获:架构清晰可指认、无序列化税、前端攻击面趋近于零、后端语言自由选型、依赖更少爆炸半径更小——"无聊"在软件工程里是赞美
URL:https://dev.to/zulikram/why-i-walked-back-from-nextjs-and-rsc-to-a-plain-spa-and-a-separate-backend-4k8p
《Markdown SVG 渲染器:AI 辅助开发的实用小工具》
标签:#前端 #工具 #Markdown #SVG #AI辅助编程 #SimonWillison #WebComponents
总结:
Simon Willison 分享了他用 Claude Opus 4.8 和 GPT-5.5 辅助开发的一个轻量级 Markdown 渲染工具,核心亮点是对 SVG 代码块的特殊处理——不仅能渲染出图像,还提供「渲染图 / 源代码」双标签切换。该工具支持直接粘贴 Markdown、加载远程文件或 GitHub Gist,并用 Fragment URL 记录状态以便分享。整个项目从需求到安全加固完全由 AI 驱动,是「提示驱动开发」的又一实例。
文章要点:
1. 这个工具的诞生源于一个具体场景:Simon 用 LLM CLI 让 Claude Opus 4.8 生成了五组不同思考深度(low 到 max)的「鹈鹕骑自行车」SVG,想找个优雅的方式展示这些 Markdown 日志
2. 核心定制点在于 SVG 围栏代码块(\
3. 支持三种内容输入方式:直接粘贴 Markdown、输入 CORS 兼容的远程 Markdown 文件 URL、或者加载 GitHub Gist 中的第一个文件
4. 用 URL Fragment(#)记录当前加载的文件地址,刷新页面或分享链接时能自动恢复状态,不用依赖后端
5. 安全方面,Simon 后续用 GPT-5.5(Codex xhigh 模式)专门审计并修复了 XSS 漏洞,体现了 AI 辅助开发中「生成 + 安全加固」的两步走思路
6. 整个工具属于 Simon 的「HTML Tools」系列——单文件 HTML+JS+CSS、无构建步骤、托管在 tools.simonwillison.net,目前已积累超过 150 个类似小工具
URL:https://simonwillison.net/2026/May/28/markdown-svg-renderer/
标签:#前端 #工具 #Markdown #SVG #AI辅助编程 #SimonWillison #WebComponents
总结:
Simon Willison 分享了他用 Claude Opus 4.8 和 GPT-5.5 辅助开发的一个轻量级 Markdown 渲染工具,核心亮点是对 SVG 代码块的特殊处理——不仅能渲染出图像,还提供「渲染图 / 源代码」双标签切换。该工具支持直接粘贴 Markdown、加载远程文件或 GitHub Gist,并用 Fragment URL 记录状态以便分享。整个项目从需求到安全加固完全由 AI 驱动,是「提示驱动开发」的又一实例。
文章要点:
1. 这个工具的诞生源于一个具体场景:Simon 用 LLM CLI 让 Claude Opus 4.8 生成了五组不同思考深度(low 到 max)的「鹈鹕骑自行车」SVG,想找个优雅的方式展示这些 Markdown 日志
2. 核心定制点在于 SVG 围栏代码块(\
\\`svg)——普通 Markdown 渲染器只会显示代码,而这个工具会把它变成可交互的 Web Component,默认展示渲染好的 SVG,点击可切换到源码查看3. 支持三种内容输入方式:直接粘贴 Markdown、输入 CORS 兼容的远程 Markdown 文件 URL、或者加载 GitHub Gist 中的第一个文件
4. 用 URL Fragment(#)记录当前加载的文件地址,刷新页面或分享链接时能自动恢复状态,不用依赖后端
5. 安全方面,Simon 后续用 GPT-5.5(Codex xhigh 模式)专门审计并修复了 XSS 漏洞,体现了 AI 辅助开发中「生成 + 安全加固」的两步走思路
6. 整个工具属于 Simon 的「HTML Tools」系列——单文件 HTML+JS+CSS、无构建步骤、托管在 tools.simonwillison.net,目前已积累超过 150 个类似小工具
URL:https://simonwillison.net/2026/May/28/markdown-svg-renderer/
《AI 正在重演前端的"失落十年"吗?》
标签:#前端 #AI编程 #职业发展 #软件工程 # craftsmanship #Bauhaus
总结:
作者将 AI 对编程行业的冲击与前十年 JavaScript 框架对前端的"去技能化"(deskilling)进行类比。框架把浏览器当作编译目标,让通用开发者无需理解 HTML 语义、无障碍、性能等底层知识就能"搞定"前端;AI 编码则进一步将手工写代码的技能消解为"操作半熟练工人使用的技术"。文章认为这降低了从业者议价能力、牺牲了质量,但也承认这是效率提升和抽象层级升高的必然趋势。作者借用 Bauhaus 运动的启示——不是对抗工业化,而是让工匠与工厂协作、以用户为中心重新设计——呼吁在 AI 时代依然需要"懂材料"的人,同时指出商业成功与软件质量本就很少相关,真正的 craft 只会成为更小的切片。
文章要点:
1. "去技能化"正在从特定领域扩散到整个编程行业:框架让前端从专精技能变成通用技能,AI 让编程本身面临同样命运
2. 现代"全栈开发者"往往不是前后端都精通,而是能用框架两边都糊弄的通才,企业因此获得成本节省和人员灵活调配
3. AI 编码是"非确定性抽象"——不像编译器那样稳定,输入或模型的微小变化会导致截然不同的结果,更像是"不会学习的初级工程师"
4. LLM 是 Stack Overflow 复制粘贴的终极进化:让懂行的人更快,让不懂的人也能凑出"能跑"的东西,但抽象泄漏时依然需要有人深入理解并修复
5. 商业成功与软件质量几乎不相关,糟糕的网站对转化率影响有限,且"没人因为选了 React 而被解雇"
6. Bauhaus 运动的启示:不复古也不对抗工业化,而是让设计师回到工坊、与材料共事,最终产出兼顾批量生产和用户体验的设计
7. 前端 craft 不会消失,但会成为更小的切片;就像字体设计不再是全职工作、塑料垃圾泛滥但好工业设计依然存在
8. 快速迭代和 MVP 有其价值,但需要知道自己在验证什么;性能和无障碍等基础如果一开始没做对,后期很难补救
9. AI 只是工具箱里的又一件工具,但 hype 周期内我们会看到丑陋的代码、破碎的沟通和借 AI 之名裁员
10. 作者自己的框架 Mastro 倡导"从简单栈开始、后续再添加功能",反对先上重型框架再试图优化
URL:https://mastrojs.github.io/blog/2026-05-23-is-AI-causing-a-repeat-of-frontends-lost-decade/
《用 Web Components 构建框架无关的设计系统(实践指南)》
标签:#前端 #WebComponents #设计系统 #Elena #VitePress #CSS #无障碍
总结:
本文是一份超详细的实战教程,手把手教你用 Web Components(通过 Elena 库)和 VitePress 搭建一个框架无关、可发布的设计系统。核心思路是"最低可行层级"——用 web 标准直接写原子组件,避免框架锁定;组件保持"最笨"状态,把复杂业务逻辑留给应用层。文章涵盖 monorepo 结构搭建、Elena 组件脚手架、条件渲染、@scope 样式隔离、CSS 自定义属性主题化,以及通过 JSDoc + Custom Elements Manifest 自动生成 Props 表格的文档工作流。最终产出的是一个可独立发布的组件包 + 可部署的静态文档站。
文章要点:
1. 设计系统从第一天就绑定特定框架(如 React)是"令人费解的"——web 标准组件才是可移植、可组合、经得起时间考验的选择
2. Elena 是"刚好够用的抽象":处理跨框架的 prop/attribute 同步、事件委托等脏活,但不掩盖 web 标准本质
3. 组件应保持"最笨"——被告知显式状态和内容的声明式组件,比内置复杂状态管理的"聪明"组件更健康
4. 设计决策应该在代码中而非 Figma 中完成:现代色彩空间、相对单位、对数排版比例等,设计工具只能模拟浏览器的很小一部分能力
5. 用 @scope 实现样式隔离 + 组件级 CSS 自定义属性作为"最终层 token",既保证封装又有主题化回退
6. JSDoc 注释即文档:Elena 自动生成 custom-elements.json,VitePress 通过 data loader 直接渲染 PropsTable 和 ComponentHeader
7. 文档即测试场:在 VitePress 中实时预览组件,确保跨框架可移植性;开发时 concurrent 运行 watch + docs:dev 实现热更新
8. 条件渲染示例:同一个组件通过 href prop 自动切换 button/a 标签,CTA 链接按钮的常见需求也能语义化实现
URL:https://piccalil.li/blog/framework-agnostic-design-systems-part-1/
《Orval:从OpenAPI规范自动生成类型安全客户端代码》
标签:#前端 #全栈 #OpenAPI #TypeScript #CodeGeneration #ReactQuery #Swagger #APIClient
总结:
Orval 是一个代码生成工具,能读取 OpenAPI v3 或 Swagger v2 规范(支持 yaml 和 json 格式),自动生成带完整 TypeScript 类型签名的客户端代码。它支持 React Query、SWR、Vue Query、Svelte Query、Solid Query、Angular、Hono、Zod、原生 fetch 和 MCP 等多种框架与库,同时还能生成模型、请求函数、Hooks 和 Mock 数据。项目提供在线 Playground 快速体验,开发时使用 Bun 构建,社区活跃且有赞助支持。
文章要点:
1. Orval 的核心能力是从 OpenAPI / Swagger 文档一键生成类型安全的 TS 客户端,告别手写接口代码的繁琐工作
2. 生态支持非常全面,覆盖了 React、Vue、Svelte、Solid、Angular 等主流前端框架,还有 React Query、SWR 等数据获取方案
3. 不只是生成请求函数,还能顺带产出数据模型(Models)、React Hooks、以及用于测试的 Mock 数据,一条龙服务
4. 项目内置了在线 Playground,不用安装就能上手体验,对新手和想快速验证的同学很友好
5. 开发侧使用 Bun 作为包管理工具,测试流程完善,包含单元测试、快照测试和 CLI 验证
URL:https://github.com/orval-labs/orval
《在本地终端预览OpenGraph卡片》
标签:#前端 #OpenGraph #CLI工具 #Zig #Kitty图形协议 #开发工具
总结:
作者为解决OpenGraph调试痛点,开发了CLI工具
文章要点:
- 传统OG调试流程繁琐:需要部署到公网或使用隧道工具,且Facebook等平台的调试器缓存机制会导致反复迭代困难
-
- 终端图片渲染基于Kitty图形协议,兼容Ghostty、iTerm2、WezTerm等主流终端,不支持的终端会自动降级为文本输出
- 工具内部使用Zig的
- 提供四种输出模式:OpenGraph预览(默认)、Twitter Card预览、表格视图、JSON格式,后者支持管道操作(如配合jq使用)
- 具备校验功能:当缺少必需的OG字段(title、type、image、url)时会输出错误并返回非零退出码,适合集成到CI流程作为布局模板检查
- 安装方式灵活:支持预编译二进制、源码编译(Zig 0.15+)和mise工具管理
文章URL:https://simonhartcher.com/posts/2026-04-15-testing-opengraph-on-localhost-from-the-cli/
标签:#前端 #OpenGraph #CLI工具 #Zig #Kitty图形协议 #开发工具
总结:
作者为解决OpenGraph调试痛点,开发了CLI工具
og-check,可直接在终端内渲染本地开发环境的OG卡片预览,无需部署到公网或使用隧道服务。工具基于Zig编写,支持Kitty图形协议在终端内显示图片,并提供OpenGraph、Twitter Card、表格和JSON四种输出格式,同时可作为CI检查工具确保OG标签完整性。文章要点:
- 传统OG调试流程繁琐:需要部署到公网或使用隧道工具,且Facebook等平台的调试器缓存机制会导致反复迭代困难
-
og-check支持在本地终端直接预览OG卡片,包含图片渲染,将反馈周期从分钟级缩短到秒级- 终端图片渲染基于Kitty图形协议,兼容Ghostty、iTerm2、WezTerm等主流终端,不支持的终端会自动降级为文本输出
- 工具内部使用Zig的
std.http.Client抓取页面,解析meta标签并按命名空间分类(og:、twitter:等),通过zigdown渲染Markdown到终端- 提供四种输出模式:OpenGraph预览(默认)、Twitter Card预览、表格视图、JSON格式,后者支持管道操作(如配合jq使用)
- 具备校验功能:当缺少必需的OG字段(title、type、image、url)时会输出错误并返回非零退出码,适合集成到CI流程作为布局模板检查
- 安装方式灵活:支持预编译二进制、源码编译(Zig 0.15+)和mise工具管理
文章URL:https://simonhartcher.com/posts/2026-04-15-testing-opengraph-on-localhost-from-the-cli/