

Now vibe coding, so learning hammer FE ?
《React 编译器到底做了什么》
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
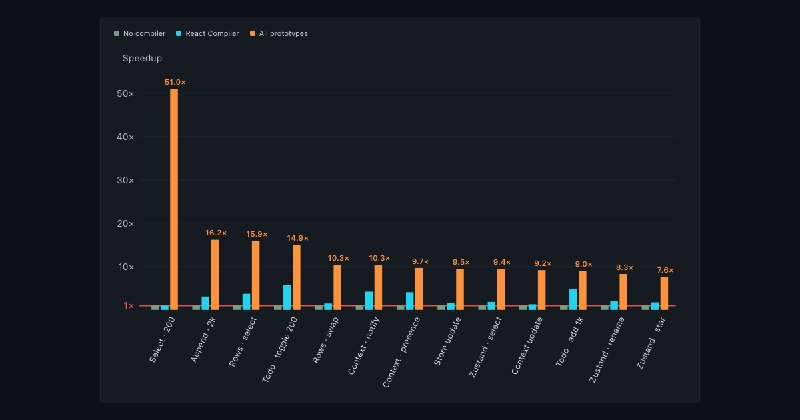
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
_c() 缓存槽位中,首次渲染写入缓存,后续渲染直接复用,本质上相当于给所有内容自动套上了 memo。2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
props.method() 拆成属性加载 + 普通调用),有的推断信息,有的做变换优化。4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
=== 判断挪进 selector 内部这一小改动就能带来数倍提升,编译器完全可以自动完成这类分析(200 次选择从 311.5 ms 降到 48.9 ms)。8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
《在 GitHub Copilot 应用中流畅渲染超大 Pull Request》
标签:
#软件工程 #前端性能优化 #PullRequest #虚拟化渲染 #React #测量调度 #滚动锚定 #性能监控
总结:
文章介绍了 GitHub Copilot 应用如何重构 Pull Request 视图,使其能够流畅处理包含 2,200 个文件、超过 100 万行代码变更和 400 多条内联评论的超大型 PR。核心挑战在于评论高度的动态性——与代码行不同,评论高度取决于 Markdown 换行、可展开区块、回复框和图片加载等渲染时才能确定的因素。团队通过分离确定性与动态几何、实现智能测量调度器、采用滚动锚定技术,并建立自动化测量循环来解决这一问题,最终实现了百万行 diff 的流畅浏览体验。
文章要点:
1. 代码与评论的几何分离:代码行高度固定且可预先计算,而评论高度动态变化。团队将文档高度分为确定性代码高度(精确前缀和)和动态块高度(估算后测量),两者独立管理,避免评论调整时重建整个代码几何。
2. 智能测量调度器:放弃每块一个 ResizeObserver 的方案(会触发反馈循环),改为单一的空闲和滚动门控测量通道。仅在视口附近约 2400px 范围内进行测量,屏幕上的块优先批量读取,离屏块最多做一次有限渲染,超过视口高度的块跳过测量。
3. 滚动锚定技术:当测量高度与估算不符时,通过身份而非像素来校正——记录用户锚定的行或块,应用高度增量后,将同一锚点解析到新像素位置并滚动,确保用户视线不跳动。区分用户滚动与程序滚动,避免侧边栏切换等操作误触发保护机制。
4. 数据管道优化:流式传输结构优先于内容,文件树和元数据在文档加载时即可渲染;语法高亮在主线程外运行,行先以纯文本显示;释放文档时保留最近几个 diff 的缓存,平衡内存与返回时的加载速度。
5. 自动化测量循环:建立"变更→测量→改进"的无人值守循环,包括无头探针车道(声明式流程 + 生产环境插桩)和自动驾驶仪(驱动真实桌面应用),通过健康信号(如无未填充间隙、评论块非空)自动检测问题,实现机械式调试而非人工复现。
URL:
https://github.blog/engineering/user-experience/rendering-huge-pull-requests-in-the-github-copilot-app/
《浏览器主线程很昂贵:高性能前端优化实战指南》
标签:
#前端 #Web性能 #浏览器原理 #JavaScript #渲染管线 #WebWorker #动画优化 #交互优化 #性能调优
总结:
本文深入剖析了浏览器主线程作为稀缺资源的工作原理,指出前端性能问题的根源往往不是代码速度慢,而是主线程被长时间占用导致界面冻结。文章系统性地介绍了两大类优化策略:在主线程上"精打细算"(拆分、批处理、优先级排序、延迟执行),以及"完全不用主线程"(利用合成器线程、Web Worker、消除不必要的工作),并通过大量交互式 Demo 帮助读者直观理解每种技术的实际效果。
文章要点:
1. 主线程是性能瓶颈的核心:主线程同时负责运行 JavaScript、样式计算、布局、绘制和事件处理,所有工作排队串行执行。60Hz 屏幕每帧预算约 16.6ms,实际可用仅约 10ms,超过 50ms 的任务会导致界面卡顿。
2. 拆分(Splitting):将大任务切割成小片段,通过
3. 批处理(Batching):将频繁触发的事件(如滚动、输入)合并执行,使用防抖(debounce)和节流(throttle)减少重复劳动。React 的虚拟 DOM 本质上也是一种批处理机制。
4. 优先级排序(Prioritizing):通过自定义队列(基于
5. 延迟执行(Deferring):非必要工作延后处理,包括代码分割、使用
6. 利用合成器线程:使用
7. FLIP 动画技术:对于必须改变布局的动画(如列表重排),先测量初始和最终位置,通过反转和播放
8. Web Worker 处理重计算:将图片处理、大数据解析等纯计算任务转移到 Worker 线程,通过
9. 消除不必要的工作:当数据流入速度超过处理能力时,采用丢弃(旧日志)、合并(只保留最新值)、跳过(缓存 memoization)三种策略,从源头减少工作量。
10. 避免布局抖动(Layout Thrashing):不要交替读写布局属性(如
URL:
https://kciter.so/posts/the-expensive-main-thread/en/
标签:
#前端 #Web性能 #浏览器原理 #JavaScript #渲染管线 #WebWorker #动画优化 #交互优化 #性能调优
总结:
本文深入剖析了浏览器主线程作为稀缺资源的工作原理,指出前端性能问题的根源往往不是代码速度慢,而是主线程被长时间占用导致界面冻结。文章系统性地介绍了两大类优化策略:在主线程上"精打细算"(拆分、批处理、优先级排序、延迟执行),以及"完全不用主线程"(利用合成器线程、Web Worker、消除不必要的工作),并通过大量交互式 Demo 帮助读者直观理解每种技术的实际效果。
文章要点:
1. 主线程是性能瓶颈的核心:主线程同时负责运行 JavaScript、样式计算、布局、绘制和事件处理,所有工作排队串行执行。60Hz 屏幕每帧预算约 16.6ms,实际可用仅约 10ms,超过 50ms 的任务会导致界面卡顿。
2. 拆分(Splitting):将大任务切割成小片段,通过
setTimeout 或 requestAnimationFrame 让出主线程,让浏览器在间隙处理渲染和输入。注意过度拆分会产生额外开销,且 JSON.parse 等原子操作无法拆分。3. 批处理(Batching):将频繁触发的事件(如滚动、输入)合并执行,使用防抖(debounce)和节流(throttle)减少重复劳动。React 的虚拟 DOM 本质上也是一种批处理机制。
4. 优先级排序(Prioritizing):通过自定义队列(基于
MessageChannel)实现任务插队机制,确保用户当前关注的操作(如点击预览图片)优先执行,采用"空闲时预处理,紧急时优先处理"的策略。5. 延迟执行(Deferring):非必要工作延后处理,包括代码分割、使用
IntersectionObserver 实现虚拟列表(只渲染可视区域内容)、离屏时暂停动画等,避免一次性处理全部数据。6. 利用合成器线程:使用
transform 和 opacity 代替 top、left、width 等触发布局的属性做动画,让动画在合成器线程运行,即使主线程繁忙也能保持流畅。7. FLIP 动画技术:对于必须改变布局的动画(如列表重排),先测量初始和最终位置,通过反转和播放
transform 来实现平滑过渡,将布局计算限制为仅一次,动画过程交给合成器。8. Web Worker 处理重计算:将图片处理、大数据解析等纯计算任务转移到 Worker 线程,通过
postMessage 的 Transferable 对象(如 ArrayBuffer)实现零拷贝数据传输,避免主线程冻结。9. 消除不必要的工作:当数据流入速度超过处理能力时,采用丢弃(旧日志)、合并(只保留最新值)、跳过(缓存 memoization)三种策略,从源头减少工作量。
10. 避免布局抖动(Layout Thrashing):不要交替读写布局属性(如
offsetWidth),应先批量读取再批量写入,强制浏览器反复计算布局会严重阻塞主线程。URL:
https://kciter.so/posts/the-expensive-main-thread/en/
《Vitest 5.0 正式发布》
标签:
#前端 #JavaScript #Vitest #测试框架 #单元测试 #性能优化 #BrowserMode #MockAPI #基准测试 #断言改进 #代码覆盖率
总结:
Vitest 5.0 于 2026 年 9 月 3 日正式发布,本次大版本以性能优化为核心,同时带来 Trace View 追踪视图、嵌套项目配置、
文章要点:
1. 性能大幅提升:通过共享 Vite 服务器、稳定的文件系统模块缓存、减少主进程与 worker 往返、加速 vm 池与浏览器模式等优化,整体测试速度提升 8%–53%,大型项目(1,280 模块)运行时间从 7.24s 降至 5.83s。
2. **新增
Browser Mode 内置 Trace Viewew**:开启
嵌套项目与配置继承继承**:内联项目默认继承根配置(无需
5. **新 API
8. **Mock
9. **更严格的断言行为**:未 await 的异步断言(
10. **
11. **报告器统一输出目录**:所有报告器输出集中到
12. **其他实用改进**:新增
13. **破坏性变更**:要求 Vite >= 6.4.0 和 Node.js >= 22.12.0,升级前建议查阅迁移指南。
URL:
https://vitest.dev/blog/vitest-5
标签:
#前端 #JavaScript #Vitest #测试框架 #单元测试 #性能优化 #BrowserMode #MockAPI #基准测试 #断言改进 #代码覆盖率
总结:
Vitest 5.0 于 2026 年 9 月 3 日正式发布,本次大版本以性能优化为核心,同时带来 Trace View 追踪视图、嵌套项目配置、
vi.when 条件 Mock、基准测试重写等多项重要更新,并默认启用更严格的断言与 clearMocks 行为,要求 Vite >= 6.4.0 和 Node.js >= 22.12.0。文章要点:
1. 性能大幅提升:通过共享 Vite 服务器、稳定的文件系统模块缓存、减少主进程与 worker 往返、加速 vm 池与浏览器模式等优化,整体测试速度提升 8%–53%,大型项目(1,280 模块)运行时间从 7.24s 降至 5.83s。
2. **新增
vitest doctor 诊断工具**:自动运行替代配置并推荐更快的选项,同时默认输出性能提示,帮助用户发现配置瓶颈。Browser Mode 内置 Trace Viewew**:开启
browser.traceView 后,可记录交互、断言和 DOM 快照,支持逐步回放测试过程,便于调试 CI 失败。嵌套项目与配置继承继承**:内联项目默认继承根配置(无需
extends: true),被引用的配置文件可声明自己的 projects,支持多级嵌套结构。5. **新 API
vi.when**:支持按参数定义不同的 Mock 返回值,支持深度相等和 expect.any() 等非对称匹配器,并可限制调用基准测试 API 重写API 重写**:bench 变为测试上下文 fixture,可在常规 test() 中使用,支持 fixtures、生命周期钩子、重试和断言,结果可存储并与基线定位器错误显示 ARIA 树ARIA 树**:浏览器模式下定位失败时,同时打印 ARIA 快照和 HTML,帮助快速理解 getByRole 等查询的匹配逻辑;定位器默认启用严格模式。8. **Mock
Temporal API**:假计时器现在同时模拟 Temporal 和 Date,适用于 vi.useFakeTimers() 和 vi.setSystemTime()。9. **更严格的断言行为**:未 await 的异步断言(
resolves、rejects 等)现在会导致测试失败;expect.poll 超时后拒绝并支持 AbortSignal 取消。10. **
clearMocks 默认启用**:每个测试前自动清除 Mock 调用历史,避免测试间报告器统一输出目录。11. **报告器统一输出目录**:所有报告器输出集中到
.vitest 目录,减少 .gitignore 配置;HTML 报告器支持 singleFile 选项生成单文件报告。12. **其他实用改进**:新增
--repeats 选项重复运行测试以排查 flaky 测试;injectCjsGlobals 可禁用 CJS 全局注入;覆盖率工具切换到维护中的 @vitest/istanbuljs 包。13. **破坏性变更**:要求 Vite >= 6.4.0 和 Node.js >= 22.12.0,升级前建议查阅迁移指南。
URL:
https://vitest.dev/blog/vitest-5
《Oxlint 原生集成 React Compiler:Lint 速度提升 3 倍,Rust 工具链再进一步》
标签:
#前端开发 #React #Rust #Oxlint #性能优化 #编译器
总结:
Oxlint 在 v1.79.0 中正式原生集成了 React Compiler 的 22 条 lint 规则,无需 Babel 管道即可在 Rust 层直接运行。这意味着开发者可以在 lint 阶段就捕获 React Compiler 的 bailout(回退)情况,而 lint 任务耗时从约 29.2 秒骤降至 9.1 秒(3.2 倍加速),若去掉其他 JS 插件甚至可达 11 倍。作者强调:使用 React Compiler 时,启用全部 lint 规则是"不可争议的前提条件",因为一次 bailout 就可能导致性能严重退化(如作者主页动画卡顿)。同时,oxc 的 Rust 版 React Compiler 构建时转换也已接近可用,比原版快约 2 倍。
文章要点:
1. React Compiler 的 Rust 重写已成官方版本 — React 团队近期发布了 Rust 重写的 React Compiler,作为新的 canonical 版本。作者已在 AI 建站工具 Outlyne 中使用近一年,彻底告别手动
2. 作者已全面迁移到 oxc 生态 — Rollup → Rolldown、ESLint → Oxlint、Prettier → oxfmt、Jest → Vitest,整体工具链已 Rust 化,但 React Compiler 的 lint 插件一直是瓶颈。
3. 旧方案的痛点:Babel 管道拖慢 lint 3 倍 — 此前通过 Oxlint 的 JS 插件支持运行 React Compiler linter,需要先跑 Babel 再跑 Compiler 核心构建 AST,导致 lint 任务耗时从 9 秒暴涨到 29 秒。
4. Oxlint v1.70.0 起引入原生支持 — 新增 nursery 规则
5. 推荐配置:correctness + 枚举剩余规则 — 启用
6. 速度实测:3.2 倍到 11 倍提升 — 原生规则下 lint 从 29.2s → 9.1s;若同时去掉无原生替代的 JS 插件(如 perfectionist),可进一步降至 2.6s,实现 11 倍加速。
7. 构建时转换也在推进中 — oxc 已合并原生构建时 transform,但 Rolldown/Vite 曾因二进制体积增加 17% 而暂时回退。oxc-transform-react v0.0.1 已发布,比原版 Rust Compiler 快约 2 倍,source map 已修复,支持 fast refresh,作者已在生产环境测试。
8. 迁移门槛极低 — 只需 lint 层面改动,不影响构建步骤。可用
9. 一个常见陷阱:props 重新赋值 —
10. 作者的底线原则 — "React Compiler without linting all bailouts considered unsafe"(不 lint 所有 bailout 的 React Compiler 视为不安全)。一次 bailout 曾导致其首页动画 placeholder 卡顿、视觉破碎。
URL:
https://blog.master.dev/react-compiler-linting-just-got-a-rust-native-speedup-in-oxlint/
标签:
#前端开发 #React #Rust #Oxlint #性能优化 #编译器
总结:
Oxlint 在 v1.79.0 中正式原生集成了 React Compiler 的 22 条 lint 规则,无需 Babel 管道即可在 Rust 层直接运行。这意味着开发者可以在 lint 阶段就捕获 React Compiler 的 bailout(回退)情况,而 lint 任务耗时从约 29.2 秒骤降至 9.1 秒(3.2 倍加速),若去掉其他 JS 插件甚至可达 11 倍。作者强调:使用 React Compiler 时,启用全部 lint 规则是"不可争议的前提条件",因为一次 bailout 就可能导致性能严重退化(如作者主页动画卡顿)。同时,oxc 的 Rust 版 React Compiler 构建时转换也已接近可用,比原版快约 2 倍。
文章要点:
1. React Compiler 的 Rust 重写已成官方版本 — React 团队近期发布了 Rust 重写的 React Compiler,作为新的 canonical 版本。作者已在 AI 建站工具 Outlyne 中使用近一年,彻底告别手动
useCallback/useMemo。2. 作者已全面迁移到 oxc 生态 — Rollup → Rolldown、ESLint → Oxlint、Prettier → oxfmt、Jest → Vitest,整体工具链已 Rust 化,但 React Compiler 的 lint 插件一直是瓶颈。
3. 旧方案的痛点:Babel 管道拖慢 lint 3 倍 — 此前通过 Oxlint 的 JS 插件支持运行 React Compiler linter,需要先跑 Babel 再跑 Compiler 核心构建 AST,导致 lint 任务耗时从 9 秒暴涨到 29 秒。
4. Oxlint v1.70.0 起引入原生支持 — 新增 nursery 规则
react/react-compiler,直接在 Rust 中运行 React Compiler,无需 Babel。v1.79.0 正式发布 22 条 Compiler 驱动的规则,覆盖 React 规则的验证。5. 推荐配置:correctness + 枚举剩余规则 — 启用
correctness 类别可覆盖 12 条规则,再手动列出其余 10 条。若启用 restriction 类别则自动再纳入 5 条,suspicious 纳入 4 条,perf 纳入 1 条。6. 速度实测:3.2 倍到 11 倍提升 — 原生规则下 lint 从 29.2s → 9.1s;若同时去掉无原生替代的 JS 插件(如 perfectionist),可进一步降至 2.6s,实现 11 倍加速。
7. 构建时转换也在推进中 — oxc 已合并原生构建时 transform,但 Rolldown/Vite 曾因二进制体积增加 17% 而暂时回退。oxc-transform-react v0.0.1 已发布,比原版 Rust Compiler 快约 2 倍,source map 已修复,支持 fast refresh,作者已在生产环境测试。
8. 迁移门槛极低 — 只需 lint 层面改动,不影响构建步骤。可用
npx @oxlint/migrate 自动迁移 ESLint flat config,或让 LLM 帮忙。甚至可以先并行跑 Oxlint 和 ESLint,只替换 React Compiler 插件就能提速。9. 一个常见陷阱:props 重新赋值 —
function MyComponent({ value }) { value = value ?? fallback; } 这种写法会让整个组件被 Compiler 跳过(bailout),导致性能退化。建议用解构重命名解决,同时开启 eslint/no-param-reassign 规则。10. 作者的底线原则 — "React Compiler without linting all bailouts considered unsafe"(不 lint 所有 bailout 的 React Compiler 视为不安全)。一次 bailout 曾导致其首页动画 placeholder 卡顿、视觉破碎。
URL:
https://blog.master.dev/react-compiler-linting-just-got-a-rust-native-speedup-in-oxlint/
《一次被低估的重构如何让内存暴降90%——TanStack_Table_V9内存优化揭秘》
标签:#前端 #TanStackTable #性能优化 #JavaScript #内存管理
总结:
TanStack_Table_V9通过将行、列、单元格和表头对象的方法从实例属性迁移到共享原型上,实现了大型表格场景下最高达90%的内存节省。这一改动让V9能处理1000-1600万行数据(V8仅约150万行即达4GB内存上限),同时保持了动态特性组合的能力,仅带来解构方法调用这一处Breaking_Change。
文章要点:
1. 数据亮眼:处理100万行×8列时,V9比V8节省超2.4GB内存,最高降幅达90.5%,表格承载能力从约150万行跃升至1000-1600万行
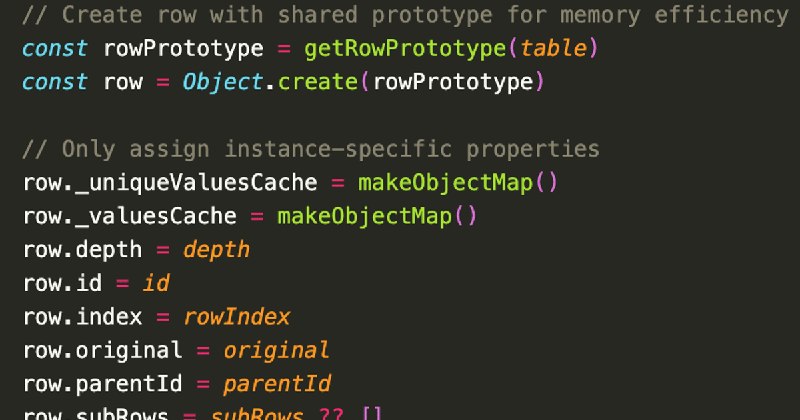
2. 核心手法:用
3. 不用类的智慧:因为TanStack_Table的特性是动态组合的(按需注册排序、筛选、分页等),单继承的Class难以优雅表达"条件式多重继承",手动原型模式更灵活
4. 唯一代价:方法不能再解构调用(如
5. 通用启示:任何需要大规模创建相似对象的库或应用,都可以借鉴这种"共享原型+实例数据分离"的模式来优化内存
URL:https://tanstack.com/blog/tanstack-table-v9-memory-performance
标签:#前端 #TanStackTable #性能优化 #JavaScript #内存管理
总结:
TanStack_Table_V9通过将行、列、单元格和表头对象的方法从实例属性迁移到共享原型上,实现了大型表格场景下最高达90%的内存节省。这一改动让V9能处理1000-1600万行数据(V8仅约150万行即达4GB内存上限),同时保持了动态特性组合的能力,仅带来解构方法调用这一处Breaking_Change。
文章要点:
1. 数据亮眼:处理100万行×8列时,V9比V8节省超2.4GB内存,最高降幅达90.5%,表格承载能力从约150万行跃升至1000-1600万行
2. 核心手法:用
Object.create创建共享原型对象,将方法统一挂载到原型上,实例只保留独有数据,彻底消灭百万级重复函数对象及其闭包作用域3. 不用类的智慧:因为TanStack_Table的特性是动态组合的(按需注册排序、筛选、分页等),单继承的Class难以优雅表达"条件式多重继承",手动原型模式更灵活
4. 唯一代价:方法不能再解构调用(如
const {getValue} = row会丢失this),且Object.keys/{...row}浅拷贝不会包含方法,但直接调用row.getValue()一切正常5. 通用启示:任何需要大规模创建相似对象的库或应用,都可以借鉴这种"共享原型+实例数据分离"的模式来优化内存
URL:https://tanstack.com/blog/tanstack-table-v9-memory-performance
《Node.js流内存泄漏生产级排查手册:五大隐蔽陷阱与五则铁律》
标签:#NodeJS #后端 #流处理 #内存优化 #性能调优
总结:
文章要点:
1. 五大隐蔽泄漏模式:①客户端断开但服务端未感知(legacy pipe() 不处理 premature close)②手动事件解绑是噩梦(async iterator 的 break 自动触发 destroy)③超时只杀响应不杀上游(AbortSignal.timeout 才能全链路终止)④数据库生命周期绑定网络速度(应解耦上游资源与下游传输)⑤pipeline() 异步 destroy 的竞态窗口(catch 里手动补刀 source.destroy)
2. 五则生产铁律:Rule 1 永远用 pipeline() 替代 .pipe(),自动处理错误/完成/背压传播;Rule 2 尊重 .write() 的布尔返回值,并掌握防"Drain Hang"的 AbortController 竞速清理写法;Rule 3 谁创建谁销毁,try/finally + AbortSignal 是标配;Rule 4 用 --max-old-space-size=128 做本地压测,看 writableLength 是否脱离 highWaterMark 失控飙升;Rule 5 写单元测试验证背压,用低 highWaterMark 的慢消费者 mock 检测队列是否暴涨
3. 未来方向:Node.js 正推动"stream-less future",用纯 async generator + pipeline() 替代 legacy Stream API,从 push 模式转为 pull 模式,背压协作变成结构性而非手动检查;Node.js 22 的 stream.compose() 可将多个 generator/流封装为可复用的 Duplex 单元
4. 核心洞察:Node.js 流基于信任系统,破坏信任时不会大声报错,而是静默累积直到崩溃。四行修复代码(检查 write 返回值 + await drain)只是起点,真正的挑战在于理解生产环境中连接断开、超时、慢网络等边界情况
URL:https://frontendmasters.com/blog/the-production-playbook-for-node-js-stream-leaks/
《CSS 与 JavaScript 动画性能之争》
标签:#前端 #CSS动画 #JavaScript动画 #WebAnimationsAPI #性能优化 #GSAP #Motion
总结:
本文通过交互式演示拆解了 CSS 与 JS 动画的性能差异真相:CSS Keyframes 和 Transitions 运行在独立线程,主线程阻塞时依然流畅;而传统 JS 动画(如 requestAnimationFrame 循环)与主线程争抢资源,容易卡顿。但 Motion 库通过底层调用 Web Animations API(WAAPI)绕过了这一限制,实现了与 CSS 同级别的流畅度。作者建议优先使用原生 CSS,遇到 CSS 无法覆盖的场景时选择 Motion 等 WAAPI 方案,而非直接上 GSAP 这类纯主线程库。
文章要点:
1. CSS 动画的核心优势不是"计算快",而是运行在独立线程,主线程再忙也不影响动画流畅度
2. 传统 JS 动画(requestAnimationFrame)每帧都在主线程计算,React 重渲染或 fetch 解析时容易掉帧
3. Motion 库(原 Framer Motion)底层使用 Web Animations API,能接入与 CSS 相同的底层动画引擎,主线程阻塞时照样丝滑
4. GSAP 功能极其强大,但坚持在主线程运行,是"能力换性能"的取舍,适合复杂序列动画而非简单过渡
5. 现代 CSS 已经很能打,View Transitions、linear()、Animation Timeline 等新 API 大幅减少了必须上 JS 的场景
6. 选型建议:能用 CSS 就不用库 → CSS 搞不定优先选 Motion/WAAPI → 只有复杂时间线控制才考虑 GSAP
URL:https://www.joshwcomeau.com/animation/css-vs-javascript/
《Python 3.15的JIT编译器重回正轨》
标签:#Python #JIT #CPython #性能优化 #Faster_CPython #编译器 #开源社区
总结:
Python 3.15的JIT编译器开发取得突破性进展,在失去主要赞助商后通过社区协作成功实现性能目标。目前macOS AArch64平台比解释器快11-12%,Linux x86_64快5-6%,提前完成预定目标。文章强调了团队建设、任务分解和幸运的技术决策(如追踪记录解释器和引用计数消除)对项目成功的关键作用。
文章要点:
- **性能目标提前达成**:Python 3.15的JIT在macOS AArch64上比尾调用解释器快11-12%,在Linux x86_64上比标准解释器快5-6%,提前一年多完成目标
- **从困境中重生**:Faster CPython团队2025年失去主要赞助商后,通过社区托管模式维持开发,作者曾怀疑JIT项目能否成功
- **降低"巴士因子"风险**:团队计划在JIT的前端(区域选择器)、中端(优化器)、后端(代码生成器)各配备2名活跃维护者,目前中端已有4名贡献者
- **任务分解吸引新人**:将复杂优化问题拆分为简单任务(如"优化单条指令"),提供详细可操作的指导,让无JIT经验的C程序员也能参与,共11人参与核心重构
- **关键技术决策**:Brandt建议改用追踪式前端,Mark建议双分派表机制,意外地将追踪解释器性能从慢6%提升到快1.x%,并将JIT代码覆盖率提升50%
- **引用计数消除优化**:消除每条Python指令的分支操作,这一优化易于并行化且适合教学,是3.15版本的主要优化方向
- **基础设施支撑**:Savannah Ostrowski一人搭建了等效于整个基础设施团队的CI系统,每日性能测试帮助快速发现回归问题
文章URL:
https://fidget-spinner.github.io/posts/jit-on-track.html
《关于协作编辑的谎言(第二部分):为什么我们不用Yjs》
标签:#前端 #ProseMirror #CRDT #协作编辑 #性能优化 #Yjs #实时协作
总结:
本文是Moment.dev团队关于协作编辑算法分析的第二部分,作者详细阐述了为何在生产环境中放弃Yjs而选择基于ProseMirror-collab的简单方案。文章指出Yjs存在严重的性能问题(每次协作编辑会销毁重建整个文档)、与文档Schema冲突、权限控制困难、调试困难以及墓碑数据占用内存等问题。作者认为,除非真正需要无主节点的P2P架构,否则40行代码的"简单方案"在性能、可维护性和开发体验上都优于复杂的CRDT实现。
文章要点:
- Yjs存在严重性能缺陷:每次协作编辑会销毁并重建整个文档,导致60fps目标难以达成,影响NodeView、插件状态、撤销功能和光标位置管理
- 简单方案仅需40行代码:使用prosemirror-collab库,通过单一权威节点管理文档版本和事务,支持乐观更新、离线编辑和网络中断恢复
- Yjs与文档Schema冲突:在无主节点架构下难以验证事务有效性,可能导致数据永久丢失,升级时尤其危险
- 权限控制复杂化:需要将Yjs的XML更新预测转换为ProseMirror事务来判断权限,实现难度大
- 墓碑数据问题:Yjs需保留删除标记,导致内存持续增长或数据丢失风险,而简单方案通过数据库存储步骤即可解决
- 调试困难:CRDT仅保证最终一致性,难以区分暂时分歧与真正错误,调试工具受限
- 核心观点:技术选型应从最终用户体验出发,而非算法本身;如无P2P刚需,简单方案在各方面均优于CRDT
文章URL:https://www.moment.dev/blog/lies-i-was-told-pt-2
《理解 React Fiber 存在的意义》
标签:#前端 #React #React_Fiber #性能优化 #并发渲染 #Virtual_DOM
总结(一段话概括)
React Fiber 是 React 16 对核心协调算法的彻底重写,旨在解决 React 15 中 Stack Reconciler 同步递归更新导致的主线程阻塞问题。通过将组件树重构为链表结构的 Fiber 节点,React 实现了可中断的异步更新、任务优先级调度和时间切片机制,使高优先级任务(如用户输入)能插队执行,避免页面卡顿,并为 Concurrent Mode、Suspense 等现代特性奠定基础。
文章要点:
- React 15 的瓶颈:Stack Reconciler 采用递归遍历,更新一旦开始无法中断,复杂组件树会导致主线程长时间阻塞,造成掉帧和交互卡顿
- Fiber 的本质:将同步更新改为可中断的异步更新,每个 Fiber 节点是一个执行单元,通过
- 时间切片(Time Slicing):利用
- 优先级调度:引入 Lanes 机制,区分 Immediate(最高)、UserBlocking、Normal、Low、Idle 五级优先级,确保紧急更新优先处理
- 双缓冲机制:维护
- Phase 分离:将更新分为 Render 阶段(可中断,构建 Fiber 树)和 Commit 阶段(不可中断,同步执行 DOM 操作),支持错误边界(Error Boundaries)捕获
- 架构演进:从 React 15 的两层(Reconciler + Renderer)增至 React 16+ 的三层(Scheduler + Reconciler + Renderer),调度器负责任务分配和中断控制
文章URL:https://inside-react.vercel.app/blog/understanding-why-react-fiber-exists
标签:#前端 #React #React_Fiber #性能优化 #并发渲染 #Virtual_DOM
总结(一段话概括)
React Fiber 是 React 16 对核心协调算法的彻底重写,旨在解决 React 15 中 Stack Reconciler 同步递归更新导致的主线程阻塞问题。通过将组件树重构为链表结构的 Fiber 节点,React 实现了可中断的异步更新、任务优先级调度和时间切片机制,使高优先级任务(如用户输入)能插队执行,避免页面卡顿,并为 Concurrent Mode、Suspense 等现代特性奠定基础。
文章要点:
- React 15 的瓶颈:Stack Reconciler 采用递归遍历,更新一旦开始无法中断,复杂组件树会导致主线程长时间阻塞,造成掉帧和交互卡顿
- Fiber 的本质:将同步更新改为可中断的异步更新,每个 Fiber 节点是一个执行单元,通过
child、sibling、return 指针形成链表树,取代递归调用栈- 时间切片(Time Slicing):利用
requestIdleCallback polyfill(基于 MessageChannel),在浏览器每帧(16.6ms)中预留时间(默认 5ms)给 React,超时即让出主线程控制权- 优先级调度:引入 Lanes 机制,区分 Immediate(最高)、UserBlocking、Normal、Low、Idle 五级优先级,确保紧急更新优先处理
- 双缓冲机制:维护
current Fiber 和 workInProgress Fiber 两棵树,通过 alternate 指针关联,渲染完成后直接切换指针指向,避免重复创建对象- Phase 分离:将更新分为 Render 阶段(可中断,构建 Fiber 树)和 Commit 阶段(不可中断,同步执行 DOM 操作),支持错误边界(Error Boundaries)捕获
- 架构演进:从 React 15 的两层(Reconciler + Renderer)增至 React 16+ 的三层(Scheduler + Reconciler + Renderer),调度器负责任务分配和中断控制
文章URL:https://inside-react.vercel.app/blog/understanding-why-react-fiber-exists