

Now vibe coding, so learning hammer FE ?
《在 GitHub Copilot 应用中流畅渲染超大 Pull Request》
标签:
#软件工程 #前端性能优化 #PullRequest #虚拟化渲染 #React #测量调度 #滚动锚定 #性能监控
总结:
文章介绍了 GitHub Copilot 应用如何重构 Pull Request 视图,使其能够流畅处理包含 2,200 个文件、超过 100 万行代码变更和 400 多条内联评论的超大型 PR。核心挑战在于评论高度的动态性——与代码行不同,评论高度取决于 Markdown 换行、可展开区块、回复框和图片加载等渲染时才能确定的因素。团队通过分离确定性与动态几何、实现智能测量调度器、采用滚动锚定技术,并建立自动化测量循环来解决这一问题,最终实现了百万行 diff 的流畅浏览体验。
文章要点:
1. 代码与评论的几何分离:代码行高度固定且可预先计算,而评论高度动态变化。团队将文档高度分为确定性代码高度(精确前缀和)和动态块高度(估算后测量),两者独立管理,避免评论调整时重建整个代码几何。
2. 智能测量调度器:放弃每块一个 ResizeObserver 的方案(会触发反馈循环),改为单一的空闲和滚动门控测量通道。仅在视口附近约 2400px 范围内进行测量,屏幕上的块优先批量读取,离屏块最多做一次有限渲染,超过视口高度的块跳过测量。
3. 滚动锚定技术:当测量高度与估算不符时,通过身份而非像素来校正——记录用户锚定的行或块,应用高度增量后,将同一锚点解析到新像素位置并滚动,确保用户视线不跳动。区分用户滚动与程序滚动,避免侧边栏切换等操作误触发保护机制。
4. 数据管道优化:流式传输结构优先于内容,文件树和元数据在文档加载时即可渲染;语法高亮在主线程外运行,行先以纯文本显示;释放文档时保留最近几个 diff 的缓存,平衡内存与返回时的加载速度。
5. 自动化测量循环:建立"变更→测量→改进"的无人值守循环,包括无头探针车道(声明式流程 + 生产环境插桩)和自动驾驶仪(驱动真实桌面应用),通过健康信号(如无未填充间隙、评论块非空)自动检测问题,实现机械式调试而非人工复现。
URL:
https://github.blog/engineering/user-experience/rendering-huge-pull-requests-in-the-github-copilot-app/
《用 AI 定制框架替换 Next.js:一个静态网站的“超个性化”重构实验》
标签:
#Web开发 #前端工程 #AI辅助编程 #NextJs #静态网站 #自定义框架 #性能优化 #Vercel部署
总结:
作者 Max Leiter 用 Claude Code(Fable 5 架构、Opus 实现)在约 3 小时内把个人博客从 Next.js 迁移到了一个为站点量身定制的静态构建框架。新方案把全站编译成纯 HTML,按需加载少量 Preact islands,结果页面体积、Lighthouse 分数、构建时间全面大幅优于 Next.js;代价是放弃了框架生态的无数隐性优化,后续维护与安全问题也由自己承担。
文章要点:
1. 作者让 AI “按需造一个比 Next.js 更快的专属框架”,核心思路是只保留这个网站真正用到的 Next.js 功能,而不是继续背着整个框架跑。
2. 新框架本质上是一个构建脚本:读取文章目录,用 React 在服务端渲染每条路由为静态 index.html,再按 Vercel Build Output API 输出,M2 MacBook 上热构建只要约 0.5 秒。
3. 性能提升非常夸张:首页 JS 从 208 KB 降到 2.3 KB(约 -99%),移动端 LCP 从 2.4 秒降到 1.3 秒,整页重量从 1153 KB 降到 78 KB,Lighthouse 直接冲到 100 分。
4. 博客文章页同样收益明显:HTML 更小、JS 只剩 2.3 KB,移动端 LCP 从 2.2 秒降到 1.1 秒,页面重量从 405 KB 降到 57 KB,软导航也改成更轻的 partial/prerender 方案。
5. 交互没有消失,而是改成“islands”模式:桌面窗口管理器和命令面板用 Preact 组件按需水合,命令面板首次按 Cmd+K 才加载,Preact 兼容层只有约 7 KB,比 React 的 52 KB 轻很多。
6. 构建链路保留原有体验:MDX 仍在构建期用同一套 remark/rehype 插件编译,shiki 在构建时同时输出两套主题的代码高亮,所以切换主题不需要额外 JS。
7. AI 还写了一个“parity harness”,对旧站 101 条路由做快照,对比 head、正文和代码块,结果抓出了 8 篇未发布文章泄漏进 RSS、以及一张 404 的 OG 图这类真实问题。
8. 整个实验花费约 669 美元,API 运行 8 小时 27 分,代码新增 20914 行、删除 2022 行,大约用掉 Claude Code 20x 订阅额度的 10%。
9. 作者认为这种做法的意义在于“只 vendor 你真正需要的东西”:框架被压缩到约 5000 行,人和模型都更容易审查,也能减少供应链攻击面。
10. 缺点也很直白:Next.js 里成百上千个小优化和边界处理 AI 未必都知道或能复现;没有现成的 agent 工具链集成;安全修复不再自动从上游来;而且网站一旦有问题,bug、安全、功能需求都归你自己管。
11. 文章还记录了两个浏览器层面的坑:Chrome 的跨文档 view transitions 会因 head 里的外部 module script 静默跳过入场动画,所以 runtime 必须内联;Safari 对 Speculation Rules 的 feature detection 需要同时检查 API 支持和 document.prerendering。
12. 作者最后判断:未来可能会出现更多“vendoring”和 agentic rewrite,也就是所谓“slop forks”;更激进的猜测是,框架本身可能会消亡,因为框架真正值钱的是沉淀下来的庞大知识,而这些知识未来可能被蒸馏成 skills 或某种新标准。
URL:
https://maxleiter.com/blog/thank-u-next
《浏览器主线程很昂贵:高性能前端优化实战指南》
标签:
#前端 #Web性能 #浏览器原理 #JavaScript #渲染管线 #WebWorker #动画优化 #交互优化 #性能调优
总结:
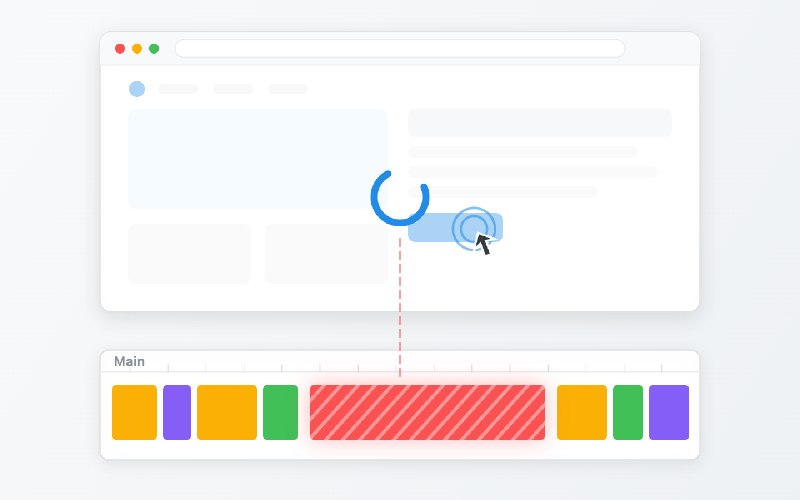
本文深入剖析了浏览器主线程作为稀缺资源的工作原理,指出前端性能问题的根源往往不是代码速度慢,而是主线程被长时间占用导致界面冻结。文章系统性地介绍了两大类优化策略:在主线程上"精打细算"(拆分、批处理、优先级排序、延迟执行),以及"完全不用主线程"(利用合成器线程、Web Worker、消除不必要的工作),并通过大量交互式 Demo 帮助读者直观理解每种技术的实际效果。
文章要点:
1. 主线程是性能瓶颈的核心:主线程同时负责运行 JavaScript、样式计算、布局、绘制和事件处理,所有工作排队串行执行。60Hz 屏幕每帧预算约 16.6ms,实际可用仅约 10ms,超过 50ms 的任务会导致界面卡顿。
2. 拆分(Splitting):将大任务切割成小片段,通过
3. 批处理(Batching):将频繁触发的事件(如滚动、输入)合并执行,使用防抖(debounce)和节流(throttle)减少重复劳动。React 的虚拟 DOM 本质上也是一种批处理机制。
4. 优先级排序(Prioritizing):通过自定义队列(基于
5. 延迟执行(Deferring):非必要工作延后处理,包括代码分割、使用
6. 利用合成器线程:使用
7. FLIP 动画技术:对于必须改变布局的动画(如列表重排),先测量初始和最终位置,通过反转和播放
8. Web Worker 处理重计算:将图片处理、大数据解析等纯计算任务转移到 Worker 线程,通过
9. 消除不必要的工作:当数据流入速度超过处理能力时,采用丢弃(旧日志)、合并(只保留最新值)、跳过(缓存 memoization)三种策略,从源头减少工作量。
10. 避免布局抖动(Layout Thrashing):不要交替读写布局属性(如
URL:
https://kciter.so/posts/the-expensive-main-thread/en/
标签:
#前端 #Web性能 #浏览器原理 #JavaScript #渲染管线 #WebWorker #动画优化 #交互优化 #性能调优
总结:
本文深入剖析了浏览器主线程作为稀缺资源的工作原理,指出前端性能问题的根源往往不是代码速度慢,而是主线程被长时间占用导致界面冻结。文章系统性地介绍了两大类优化策略:在主线程上"精打细算"(拆分、批处理、优先级排序、延迟执行),以及"完全不用主线程"(利用合成器线程、Web Worker、消除不必要的工作),并通过大量交互式 Demo 帮助读者直观理解每种技术的实际效果。
文章要点:
1. 主线程是性能瓶颈的核心:主线程同时负责运行 JavaScript、样式计算、布局、绘制和事件处理,所有工作排队串行执行。60Hz 屏幕每帧预算约 16.6ms,实际可用仅约 10ms,超过 50ms 的任务会导致界面卡顿。
2. 拆分(Splitting):将大任务切割成小片段,通过
setTimeout 或 requestAnimationFrame 让出主线程,让浏览器在间隙处理渲染和输入。注意过度拆分会产生额外开销,且 JSON.parse 等原子操作无法拆分。3. 批处理(Batching):将频繁触发的事件(如滚动、输入)合并执行,使用防抖(debounce)和节流(throttle)减少重复劳动。React 的虚拟 DOM 本质上也是一种批处理机制。
4. 优先级排序(Prioritizing):通过自定义队列(基于
MessageChannel)实现任务插队机制,确保用户当前关注的操作(如点击预览图片)优先执行,采用"空闲时预处理,紧急时优先处理"的策略。5. 延迟执行(Deferring):非必要工作延后处理,包括代码分割、使用
IntersectionObserver 实现虚拟列表(只渲染可视区域内容)、离屏时暂停动画等,避免一次性处理全部数据。6. 利用合成器线程:使用
transform 和 opacity 代替 top、left、width 等触发布局的属性做动画,让动画在合成器线程运行,即使主线程繁忙也能保持流畅。7. FLIP 动画技术:对于必须改变布局的动画(如列表重排),先测量初始和最终位置,通过反转和播放
transform 来实现平滑过渡,将布局计算限制为仅一次,动画过程交给合成器。8. Web Worker 处理重计算:将图片处理、大数据解析等纯计算任务转移到 Worker 线程,通过
postMessage 的 Transferable 对象(如 ArrayBuffer)实现零拷贝数据传输,避免主线程冻结。9. 消除不必要的工作:当数据流入速度超过处理能力时,采用丢弃(旧日志)、合并(只保留最新值)、跳过(缓存 memoization)三种策略,从源头减少工作量。
10. 避免布局抖动(Layout Thrashing):不要交替读写布局属性(如
offsetWidth),应先批量读取再批量写入,强制浏览器反复计算布局会严重阻塞主线程。URL:
https://kciter.so/posts/the-expensive-main-thread/en/
《Vitest 5.0 正式发布》
标签:
#前端 #JavaScript #Vitest #测试框架 #单元测试 #性能优化 #BrowserMode #MockAPI #基准测试 #断言改进 #代码覆盖率
总结:
Vitest 5.0 于 2026 年 9 月 3 日正式发布,本次大版本以性能优化为核心,同时带来 Trace View 追踪视图、嵌套项目配置、
文章要点:
1. 性能大幅提升:通过共享 Vite 服务器、稳定的文件系统模块缓存、减少主进程与 worker 往返、加速 vm 池与浏览器模式等优化,整体测试速度提升 8%–53%,大型项目(1,280 模块)运行时间从 7.24s 降至 5.83s。
2. **新增
Browser Mode 内置 Trace Viewew**:开启
嵌套项目与配置继承继承**:内联项目默认继承根配置(无需
5. **新 API
8. **Mock
9. **更严格的断言行为**:未 await 的异步断言(
10. **
11. **报告器统一输出目录**:所有报告器输出集中到
12. **其他实用改进**:新增
13. **破坏性变更**:要求 Vite >= 6.4.0 和 Node.js >= 22.12.0,升级前建议查阅迁移指南。
URL:
https://vitest.dev/blog/vitest-5
标签:
#前端 #JavaScript #Vitest #测试框架 #单元测试 #性能优化 #BrowserMode #MockAPI #基准测试 #断言改进 #代码覆盖率
总结:
Vitest 5.0 于 2026 年 9 月 3 日正式发布,本次大版本以性能优化为核心,同时带来 Trace View 追踪视图、嵌套项目配置、
vi.when 条件 Mock、基准测试重写等多项重要更新,并默认启用更严格的断言与 clearMocks 行为,要求 Vite >= 6.4.0 和 Node.js >= 22.12.0。文章要点:
1. 性能大幅提升:通过共享 Vite 服务器、稳定的文件系统模块缓存、减少主进程与 worker 往返、加速 vm 池与浏览器模式等优化,整体测试速度提升 8%–53%,大型项目(1,280 模块)运行时间从 7.24s 降至 5.83s。
2. **新增
vitest doctor 诊断工具**:自动运行替代配置并推荐更快的选项,同时默认输出性能提示,帮助用户发现配置瓶颈。Browser Mode 内置 Trace Viewew**:开启
browser.traceView 后,可记录交互、断言和 DOM 快照,支持逐步回放测试过程,便于调试 CI 失败。嵌套项目与配置继承继承**:内联项目默认继承根配置(无需
extends: true),被引用的配置文件可声明自己的 projects,支持多级嵌套结构。5. **新 API
vi.when**:支持按参数定义不同的 Mock 返回值,支持深度相等和 expect.any() 等非对称匹配器,并可限制调用基准测试 API 重写API 重写**:bench 变为测试上下文 fixture,可在常规 test() 中使用,支持 fixtures、生命周期钩子、重试和断言,结果可存储并与基线定位器错误显示 ARIA 树ARIA 树**:浏览器模式下定位失败时,同时打印 ARIA 快照和 HTML,帮助快速理解 getByRole 等查询的匹配逻辑;定位器默认启用严格模式。8. **Mock
Temporal API**:假计时器现在同时模拟 Temporal 和 Date,适用于 vi.useFakeTimers() 和 vi.setSystemTime()。9. **更严格的断言行为**:未 await 的异步断言(
resolves、rejects 等)现在会导致测试失败;expect.poll 超时后拒绝并支持 AbortSignal 取消。10. **
clearMocks 默认启用**:每个测试前自动清除 Mock 调用历史,避免测试间报告器统一输出目录。11. **报告器统一输出目录**:所有报告器输出集中到
.vitest 目录,减少 .gitignore 配置;HTML 报告器支持 singleFile 选项生成单文件报告。12. **其他实用改进**:新增
--repeats 选项重复运行测试以排查 flaky 测试;injectCjsGlobals 可禁用 CJS 全局注入;覆盖率工具切换到维护中的 @vitest/istanbuljs 包。13. **破坏性变更**:要求 Vite >= 6.4.0 和 Node.js >= 22.12.0,升级前建议查阅迁移指南。
URL:
https://vitest.dev/blog/vitest-5
《你的模块在骗你:ESM 与 CommonJS 的本质差异与陷阱全解析》
标签:
#JavaScript #NodeJS #ESM #CommonJS #模块系统 #前端工程化
总结:
本文深入剖析了 ESM 和 CommonJS 两种模块系统在底层机制上的根本差异——ESM 通过"活绑定"(live bindings)在模块间共享变量引用,而 CommonJS 通过
文章要点:
1. 活绑定 vs 值复制:最经典的陷阱 — ESM 的
2. ESM 的导入会被提升,CommonJS 按执行顺序 — ESM 静态导入在模块体执行前就已经解析、链接并评估依赖,所以
3. 两种系统有独立的缓存 — ESM 和 CommonJS 各自维护自己的模块缓存,URL 查询参数(如
4. 循环依赖的处理方式天差地别 — CommonJS 允许在模块未完全初始化时就返回
5. 跨系统互操作的隐藏复杂性 — ESM 导入 CJS 时,
6. 双包实例风险(Dual-Package Hazard) — 当
7. 发布库的最佳实践 — 用
8. 调试模块问题的检查清单 — 从导入文件的格式、解析到的入口点、返回值形状、本地变量持有的是绑定还是副本、评估是否完成、是否存在循环依赖、模块身份是否一致、是否经过构建工具转换、是否通过打包后的 tarball 测试等 9 个维度系统排查。
9. 九条实践规则 — 新项目优先用 ESM;库优先用命名导出;可变导出视为共享进程状态;CJS 属性会变时保留对象而非解构;移除循环依赖而非绕开;条件/延迟加载用动态
URL:
https://blog.gaborkoos.com/posts/2026-08-14-Your-Modules-Are-Lying-to-You/
标签:
#JavaScript #NodeJS #ESM #CommonJS #模块系统 #前端工程化
总结:
本文深入剖析了 ESM 和 CommonJS 两种模块系统在底层机制上的根本差异——ESM 通过"活绑定"(live bindings)在模块间共享变量引用,而 CommonJS 通过
module.exports 返回一个普通值(通常是对象)。这一差异导致了同名导入在两种系统下行为截然不同:ESM 的命名导入能观察到导出模块的变量重新赋值,CommonJS 的解构赋值则只复制了属性的当前值。文章进一步系统讲解了评估顺序、缓存机制、循环依赖处理、跨系统互操作、双包实例风险等关键话题,并提供了 9 条实践规则和调试清单。文章要点:
1. 活绑定 vs 值复制:最经典的陷阱 — ESM 的
import { status } 是活绑定,导出模块重新赋值后导入方自动看到新值;CommonJS 的 const { status } = require() 是解构赋值,只复制了对象属性的当前值,后续变化不可见。只有保留整个对象 const state = require() 才能观察到属性变更。2. ESM 的导入会被提升,CommonJS 按执行顺序 — ESM 静态导入在模块体执行前就已经解析、链接并评估依赖,所以
import 写在代码中间也不影响执行顺序;CommonJS 的 require() 是普通函数调用,走到哪行才执行哪行。3. 两种系统有独立的缓存 — ESM 和 CommonJS 各自维护自己的模块缓存,URL 查询参数(如
?mode=one)会让同一文件被当作不同模块实例加载两次。条件导出("import" / "require")指向不同文件时,也会产生两个独立的模块实例。4. 循环依赖的处理方式天差地别 — CommonJS 允许在模块未完全初始化时就返回
exports 对象,因此循环依赖中的模块能看到对方"半成品"状态;ESM 则先创建绑定再执行模块体,如果在初始化前读取对方绑定会抛出 ReferenceError: Cannot access before initialization。5. 跨系统互操作的隐藏复杂性 — ESM 导入 CJS 时,
module.exports 作为 default 导出最可靠,命名导出是 Node 静态分析的"快照",不会跟踪后续属性变更;CJS 通过 require() 加载 ESM 时返回的是命名空间对象,需通过 .default 访问默认导出。__esModule 只是工具链约定,不是语言特性。6. 双包实例风险(Dual-Package Hazard) — 当
"import" 和 "require" 指向不同构建文件时,同一个类会被实例化为两个不同的构造函数,instanceof 会返回 false,共享状态(如计数器、注册表)也会分裂成两份。7. 发布库的最佳实践 — 用
.mjs/.cjs 明确文件格式;package.json 中 "type" 字段决定 .js 的解析方式;相对 ESM 导入必须带文件扩展名;用 "exports" 条件导出为不同系统提供入口,但要警惕实例分裂。8. 调试模块问题的检查清单 — 从导入文件的格式、解析到的入口点、返回值形状、本地变量持有的是绑定还是副本、评估是否完成、是否存在循环依赖、模块身份是否一致、是否经过构建工具转换、是否通过打包后的 tarball 测试等 9 个维度系统排查。
9. 九条实践规则 — 新项目优先用 ESM;库优先用命名导出;可变导出视为共享进程状态;CJS 属性会变时保留对象而非解构;移除循环依赖而非绕开;条件/延迟加载用动态
import();包边界显式声明文件格式;假设不同导出目标是不同实例;通过包名而非源码路径测试。URL:
https://blog.gaborkoos.com/posts/2026-08-14-Your-Modules-Are-Lying-to-You/
《Oxlint 原生集成 React Compiler:Lint 速度提升 3 倍,Rust 工具链再进一步》
标签:
#前端开发 #React #Rust #Oxlint #性能优化 #编译器
总结:
Oxlint 在 v1.79.0 中正式原生集成了 React Compiler 的 22 条 lint 规则,无需 Babel 管道即可在 Rust 层直接运行。这意味着开发者可以在 lint 阶段就捕获 React Compiler 的 bailout(回退)情况,而 lint 任务耗时从约 29.2 秒骤降至 9.1 秒(3.2 倍加速),若去掉其他 JS 插件甚至可达 11 倍。作者强调:使用 React Compiler 时,启用全部 lint 规则是"不可争议的前提条件",因为一次 bailout 就可能导致性能严重退化(如作者主页动画卡顿)。同时,oxc 的 Rust 版 React Compiler 构建时转换也已接近可用,比原版快约 2 倍。
文章要点:
1. React Compiler 的 Rust 重写已成官方版本 — React 团队近期发布了 Rust 重写的 React Compiler,作为新的 canonical 版本。作者已在 AI 建站工具 Outlyne 中使用近一年,彻底告别手动
2. 作者已全面迁移到 oxc 生态 — Rollup → Rolldown、ESLint → Oxlint、Prettier → oxfmt、Jest → Vitest,整体工具链已 Rust 化,但 React Compiler 的 lint 插件一直是瓶颈。
3. 旧方案的痛点:Babel 管道拖慢 lint 3 倍 — 此前通过 Oxlint 的 JS 插件支持运行 React Compiler linter,需要先跑 Babel 再跑 Compiler 核心构建 AST,导致 lint 任务耗时从 9 秒暴涨到 29 秒。
4. Oxlint v1.70.0 起引入原生支持 — 新增 nursery 规则
5. 推荐配置:correctness + 枚举剩余规则 — 启用
6. 速度实测:3.2 倍到 11 倍提升 — 原生规则下 lint 从 29.2s → 9.1s;若同时去掉无原生替代的 JS 插件(如 perfectionist),可进一步降至 2.6s,实现 11 倍加速。
7. 构建时转换也在推进中 — oxc 已合并原生构建时 transform,但 Rolldown/Vite 曾因二进制体积增加 17% 而暂时回退。oxc-transform-react v0.0.1 已发布,比原版 Rust Compiler 快约 2 倍,source map 已修复,支持 fast refresh,作者已在生产环境测试。
8. 迁移门槛极低 — 只需 lint 层面改动,不影响构建步骤。可用
9. 一个常见陷阱:props 重新赋值 —
10. 作者的底线原则 — "React Compiler without linting all bailouts considered unsafe"(不 lint 所有 bailout 的 React Compiler 视为不安全)。一次 bailout 曾导致其首页动画 placeholder 卡顿、视觉破碎。
URL:
https://blog.master.dev/react-compiler-linting-just-got-a-rust-native-speedup-in-oxlint/
标签:
#前端开发 #React #Rust #Oxlint #性能优化 #编译器
总结:
Oxlint 在 v1.79.0 中正式原生集成了 React Compiler 的 22 条 lint 规则,无需 Babel 管道即可在 Rust 层直接运行。这意味着开发者可以在 lint 阶段就捕获 React Compiler 的 bailout(回退)情况,而 lint 任务耗时从约 29.2 秒骤降至 9.1 秒(3.2 倍加速),若去掉其他 JS 插件甚至可达 11 倍。作者强调:使用 React Compiler 时,启用全部 lint 规则是"不可争议的前提条件",因为一次 bailout 就可能导致性能严重退化(如作者主页动画卡顿)。同时,oxc 的 Rust 版 React Compiler 构建时转换也已接近可用,比原版快约 2 倍。
文章要点:
1. React Compiler 的 Rust 重写已成官方版本 — React 团队近期发布了 Rust 重写的 React Compiler,作为新的 canonical 版本。作者已在 AI 建站工具 Outlyne 中使用近一年,彻底告别手动
useCallback/useMemo。2. 作者已全面迁移到 oxc 生态 — Rollup → Rolldown、ESLint → Oxlint、Prettier → oxfmt、Jest → Vitest,整体工具链已 Rust 化,但 React Compiler 的 lint 插件一直是瓶颈。
3. 旧方案的痛点:Babel 管道拖慢 lint 3 倍 — 此前通过 Oxlint 的 JS 插件支持运行 React Compiler linter,需要先跑 Babel 再跑 Compiler 核心构建 AST,导致 lint 任务耗时从 9 秒暴涨到 29 秒。
4. Oxlint v1.70.0 起引入原生支持 — 新增 nursery 规则
react/react-compiler,直接在 Rust 中运行 React Compiler,无需 Babel。v1.79.0 正式发布 22 条 Compiler 驱动的规则,覆盖 React 规则的验证。5. 推荐配置:correctness + 枚举剩余规则 — 启用
correctness 类别可覆盖 12 条规则,再手动列出其余 10 条。若启用 restriction 类别则自动再纳入 5 条,suspicious 纳入 4 条,perf 纳入 1 条。6. 速度实测:3.2 倍到 11 倍提升 — 原生规则下 lint 从 29.2s → 9.1s;若同时去掉无原生替代的 JS 插件(如 perfectionist),可进一步降至 2.6s,实现 11 倍加速。
7. 构建时转换也在推进中 — oxc 已合并原生构建时 transform,但 Rolldown/Vite 曾因二进制体积增加 17% 而暂时回退。oxc-transform-react v0.0.1 已发布,比原版 Rust Compiler 快约 2 倍,source map 已修复,支持 fast refresh,作者已在生产环境测试。
8. 迁移门槛极低 — 只需 lint 层面改动,不影响构建步骤。可用
npx @oxlint/migrate 自动迁移 ESLint flat config,或让 LLM 帮忙。甚至可以先并行跑 Oxlint 和 ESLint,只替换 React Compiler 插件就能提速。9. 一个常见陷阱:props 重新赋值 —
function MyComponent({ value }) { value = value ?? fallback; } 这种写法会让整个组件被 Compiler 跳过(bailout),导致性能退化。建议用解构重命名解决,同时开启 eslint/no-param-reassign 规则。10. 作者的底线原则 — "React Compiler without linting all bailouts considered unsafe"(不 lint 所有 bailout 的 React Compiler 视为不安全)。一次 bailout 曾导致其首页动画 placeholder 卡顿、视觉破碎。
URL:
https://blog.master.dev/react-compiler-linting-just-got-a-rust-native-speedup-in-oxlint/
《TanStack AI 进入 RC 阶段:从 humble chat() 到完整 AI 生态》
标签:
#前端开发 #AI框架 #TanStack #TypeScript #开源
总结:
TanStack AI 正式从早期原型迈入 RC(Release Candidate)阶段,标志着其从一个简单的 LLM 聊天方法,成长为覆盖聊天、媒体生成、MCP、沙箱、Agent 编排等全场景的 AI 开发框架。核心设计哲学是"不锁定用户"——在传输层、提供商、前后端技术栈上都保持中立,同时通过极致的类型安全和统一的 API 模式降低学习成本。项目由三人业余时间维护,完全开源,无商业路线图。
文章要点:
1. 从小 chat() 到大生态 — 最初只有 4 个提供商和一个自定义协议,如今已支持 24+ 提供商,采用 AG-UI 官方协议(被 20+ Agent 框架跨语言支持),并扩展到媒体生成、MCP、沙箱、Agent Harness 等领域。
2. 中间件是架构的核心超能力 — 几乎所有高级功能(持久化、沙箱 Agent、内存、遥测)都以中间件形式接入 chat() 方法,Durability 则通过适配器插入流式响应。Lazy Tool Calling 用一个布尔标志就能降低 Token 成本。
3. 传输层零锁定 — 提供 SSE、WebSocket、HTTP Stream、Cap'n Web 等原生传输原语,客户端通过自定义连接适配器消费流,让你对传输层有端到端的完全控制权。
4. 一套 API 模式打遍所有模态 — 无论是文本生成、图像生成、视频生成、音频生成、转录还是实时音频,API 结构几乎完全相同。学一次模式,换适配器即可,不用学 20 套不同 API。
5. 类型安全是 DNA 级别 — 不支持的模型选项、缺少必填属性、把某提供商专属工具传给不支持的模型……统统在编译期报错。目标是让你在再复杂的应用里也能自信上线。
6. chat() 方法是全能核心 — 支持直接对话 LLM 和沙箱 Agent Harness;内置持久化与 Durability(刷新页面、切换对话后能从断点实时续流);支持 Codex 等 Agent 在远程/本地沙箱中运行;还有 Code Mode(Agent 在 isolate 中写代码并执行,优化性能和成本)。
7. 媒体生成是一等公民 — 实时音频、TTS、图像/视频/音频/音乐生成、转录等全部稳定可用,覆盖 100+ 模型。支持流式直传客户端或一次性生成,两者切换无缝。
8. RAG 与记忆 — 通过 Cohere、OpenRouter 等提供商支持嵌入和重排序;支持所有主流厂商的 Agent 记忆,让 Agent 跨对话记住用户偏好和关键事实。
9. 沙箱与 Agent Harness 不挑提供商 — 不强制你用 Daytona、E2B 或 Vercel Sandboxes,基础设施随你选。支持 Codex、Claude Code、Grok、OpenCode 等 20+ ACP 兼容 Agent,甚至能自建本地编码 Agent。
10. MCP 支持带类型生成 — 不仅能连接外部 MCP 服务器,还能通过 CLI 为远程 MCP 暴露的工具生成类型,保持端到端类型安全。支持连接池和生命周期管理。
11. 持久化与 Durability 是亮点 — 提供存储原语,你只需实现 Store 并通过一致性测试套件验证,接入持久化中间件后,用户一个月后回来也能从断点续聊。Durability 适配器可将流块持久化到内存、Durable Streams 等,用户重连后不会漏掉任何内容——全部配置约 20 行代码。
12. 未来路线图 — 核心架构已锁定,接下来重点在 Agent 工作流与编排(并行运行、定时任务、复杂工作流协调),以及继续补齐提供商生态。完全开源,无商业 upsell,欢迎社区贡献。
URL:
https://tanstack.com/blog/tanstack-ai-rc
《Microcharts:一句话里就能塞下的React微图表库》
标签:#前端 #React #数据可视化 #图表库 #性能优化 #无障碍 #ServerComponents
总结:
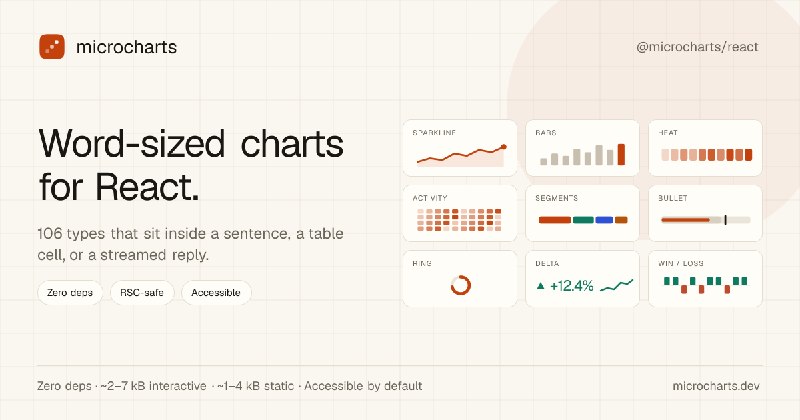
Microcharts是一个专为React设计的微图表库,提供106种图表类型,单个图表gzip后仅2.18-7KB(中位数5.25KB),零依赖。它主打"词级图表"理念——图表小到可以嵌入句子、表格单元格和KPI卡片中,无需坐标轴和图例,由上下文文字承载含义。支持服务端组件静态渲染(0KB客户端JS)、自动生成无障碍alt文本、单色系主题系统,并能在错误数据下优雅降级。
文章要点:
1. 小到离谱:中位数图表仅5.25KB gzip,最大7KB,零运行时依赖,React只是peer dependency,比通用图表库(如Recharts 106KB共享内核)轻了整整101KB
2. 一句话装得下:图表设计为"词级尺寸",可以直接嵌入正文、表格单元格、KPI卡片甚至打印报告,读者不用离开句子就能理解数字
3. 106种图表统一API:传一个data数组就搞定,domain、color、title在每个图表里含义一致,TypeScript类型完备,编辑器能自动补全
4. 静态渲染零负担:在Server Component里渲染时完全不产生客户端JS,hydrate成本为0,对性能敏感场景极其友好
5. 坏数据也能优雅处理:NaN、空数组、单一数值都不会报错,会自动渲染成点、空白或水平线,不用写try/catch兜底
6. 无障碍开箱即用:自动生成alt文本(如"趋势上升27%,范围128到163"),每个图表一个tab焦点,支持方向键浏览,色盲安全配色和RTL都内置
7. 单色系主题系统:给一个accent主色就能自动推导出完整配色(包括正负色、分类色、暗色模式),整个页面一键换肤
URL:https://microcharts.dev/
《让React Compiler接管Memoization后,我踩了哪些坑》
标签:#前端 #React #ReactCompiler #Memoization #NextJS #ReactHookForm
总结:
作者在生产级Next.js项目中启用React Compiler v1.0的真实踩坑记录。编译器确实能自动处理大部分memoization,但"大部分"这个词背后藏着不少陷阱:React Hook Form的
文章要点:
1. React Compiler的本质是Babel插件:它通过为每个组件预分配扁平缓存数组(内部hook
2. React Hook Form的
3. 有些
4. DevTools的Memo徽章会误导你:徽章只表示编译器"处理过"该组件,不代表优化成功。即使组件违反React规则(如直接修改props),徽章依然可能出现,真正没徽章的只有显式加了
5. 迁移有明确的正确顺序:先升级eslint-plugin-react-hooks到v7+并修复lint错误,再在feature分支启用编译器,最后用Profiler和E2E测试验证,不要依赖Memo徽章作为正确性信号
URL:https://blog.logrocket.com/react-compiler-memoization-what-actually-broke/
标签:#前端 #React #ReactCompiler #Memoization #NextJS #ReactHookForm
总结:
作者在生产级Next.js项目中启用React Compiler v1.0的真实踩坑记录。编译器确实能自动处理大部分memoization,但"大部分"这个词背后藏着不少陷阱:React Hook Form的
watch()因内部可变状态导致实时预览冻结;Chart.js的点击处理器在移除useCallback后出现数据过时问题;DevTools的Memo徽章仅表示组件被"处理"而非"成功优化"。核心结论是:迁移不是一键操作,需要先升级eslint-plugin-react-hooks、在feature分支启用、用E2E测试覆盖,并保留那些跨越React边界的显式hook。文章要点:
1. React Compiler的本质是Babel插件:它通过为每个组件预分配扁平缓存数组(内部hook
_c)来实现比手写useMemo更细粒度的自动memoization,让你可以删掉大部分显式hook2. React Hook Form的
watch()直接翻车:启用编译器后,表单的实时预览完全冻结,原因是RHF依赖内部可变状态,编译器无法安全memoize。解决方案是用"use no memo"指令包裹useForm的调用3. 有些
useCallback真的删不得:Chart.js的点击处理器在移除useCallback后,高并发下偶尔引用旧数据。这不是编译器bug,而是编译器的memoization节奏与外部库(按引用注册回调)的预期不一致,最终选择保留useCallback并加注释说明4. DevTools的Memo徽章会误导你:徽章只表示编译器"处理过"该组件,不代表优化成功。即使组件违反React规则(如直接修改props),徽章依然可能出现,真正没徽章的只有显式加了
"use no memo"的组件5. 迁移有明确的正确顺序:先升级eslint-plugin-react-hooks到v7+并修复lint错误,再在feature分支启用编译器,最后用Profiler和E2E测试验证,不要依赖Memo徽章作为正确性信号
URL:https://blog.logrocket.com/react-compiler-memoization-what-actually-broke/
《水合不匹配的隐藏代价:一个错误如何让LCP从绿变红》
标签:#前端 #React #HydrationMismatch #LCP #CoreWebVitals #SSR
总结:
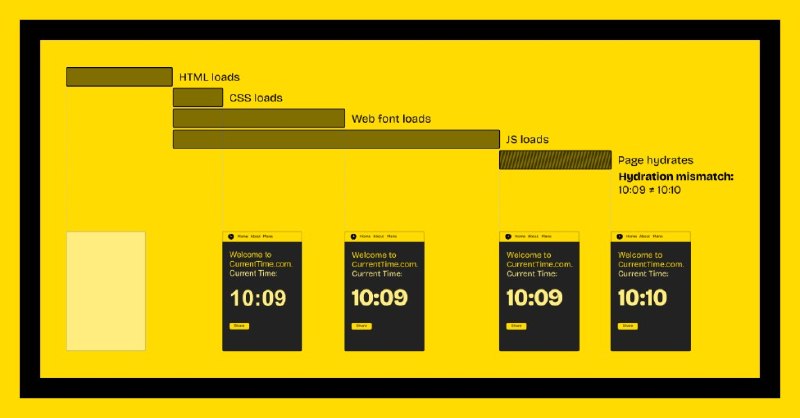
文章揭示了React SSR中一个被严重低估的性能杀手:单个水合不匹配(Hydration Mismatch)就能让LCP从绿色直接跌到红色。核心逻辑由三个事实拼接而成——水合不匹配会触发整个DOM重新挂载;使用
文章要点:
1. 水合不匹配会强制重挂载整个DOM:当服务端和客户端渲染结果不一致时,React不会局部修补,而是找到最近的
2. 字体加载导致文本膨胀是正常现象:使用
3. LCP只关心"新元素":浏览器记录LCP候选者时,仅在新元素加入DOM时重新评估;已有元素单纯尺寸变化不会触发更新,这是设计上的关键细节
4. 三者叠加就是灾难:文本先因字体加载膨胀,再因水合不匹配被删除并重新插入DOM,浏览器将其识别为"更大的新元素",LCP时间瞬间跳到水合完成时刻
5. 修复方案很直接:优先避免水合不匹配;如果实在无法避免,将不匹配元素包裹在
URL:https://3perf.com/blog/hydration-mismatch/
标签:#前端 #React #HydrationMismatch #LCP #CoreWebVitals #SSR
总结:
文章揭示了React SSR中一个被严重低估的性能杀手:单个水合不匹配(Hydration Mismatch)就能让LCP从绿色直接跌到红色。核心逻辑由三个事实拼接而成——水合不匹配会触发整个DOM重新挂载;使用
font-display: swap时,Web字体加载后文本会膨胀;而LCP只测量新加入DOM的元素,忽略已有元素的尺寸变化。三者叠加后,字体加载后的文本膨胀本应不影响LCP,但DOM重挂载让浏览器将其视为"新元素",导致LCP时间被记录到水合完成时(通常5秒以上),严重拖垮核心指标。文章要点:
1. 水合不匹配会强制重挂载整个DOM:当服务端和客户端渲染结果不一致时,React不会局部修补,而是找到最近的
Suspense边界并重新挂载整个子树;没有边界时整页重挂2. 字体加载导致文本膨胀是正常现象:使用
font-display: swap时,系统字体切换到Web字体的过程中,相同字符的物理尺寸往往不同,文本会轻微变大或变小3. LCP只关心"新元素":浏览器记录LCP候选者时,仅在新元素加入DOM时重新评估;已有元素单纯尺寸变化不会触发更新,这是设计上的关键细节
4. 三者叠加就是灾难:文本先因字体加载膨胀,再因水合不匹配被删除并重新插入DOM,浏览器将其识别为"更大的新元素",LCP时间瞬间跳到水合完成时刻
5. 修复方案很直接:优先避免水合不匹配;如果实在无法避免,将不匹配元素包裹在
Suspense边界内,限制重挂载范围,防止LCP候选元素被波及URL:https://3perf.com/blog/hydration-mismatch/
《一次被低估的重构如何让内存暴降90%——TanStack_Table_V9内存优化揭秘》
标签:#前端 #TanStackTable #性能优化 #JavaScript #内存管理
总结:
TanStack_Table_V9通过将行、列、单元格和表头对象的方法从实例属性迁移到共享原型上,实现了大型表格场景下最高达90%的内存节省。这一改动让V9能处理1000-1600万行数据(V8仅约150万行即达4GB内存上限),同时保持了动态特性组合的能力,仅带来解构方法调用这一处Breaking_Change。
文章要点:
1. 数据亮眼:处理100万行×8列时,V9比V8节省超2.4GB内存,最高降幅达90.5%,表格承载能力从约150万行跃升至1000-1600万行
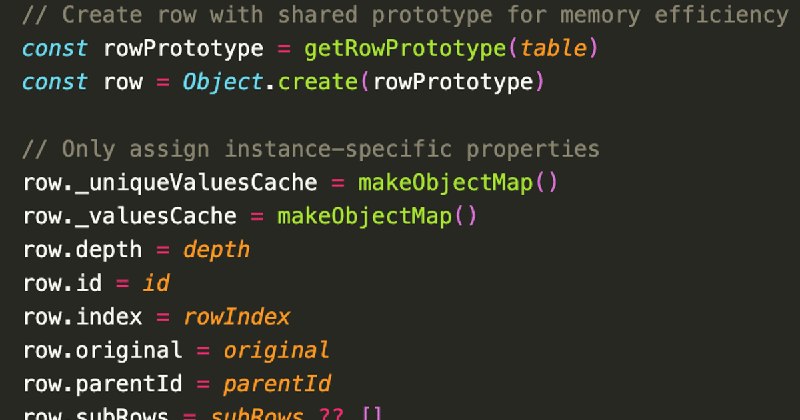
2. 核心手法:用
3. 不用类的智慧:因为TanStack_Table的特性是动态组合的(按需注册排序、筛选、分页等),单继承的Class难以优雅表达"条件式多重继承",手动原型模式更灵活
4. 唯一代价:方法不能再解构调用(如
5. 通用启示:任何需要大规模创建相似对象的库或应用,都可以借鉴这种"共享原型+实例数据分离"的模式来优化内存
URL:https://tanstack.com/blog/tanstack-table-v9-memory-performance
标签:#前端 #TanStackTable #性能优化 #JavaScript #内存管理
总结:
TanStack_Table_V9通过将行、列、单元格和表头对象的方法从实例属性迁移到共享原型上,实现了大型表格场景下最高达90%的内存节省。这一改动让V9能处理1000-1600万行数据(V8仅约150万行即达4GB内存上限),同时保持了动态特性组合的能力,仅带来解构方法调用这一处Breaking_Change。
文章要点:
1. 数据亮眼:处理100万行×8列时,V9比V8节省超2.4GB内存,最高降幅达90.5%,表格承载能力从约150万行跃升至1000-1600万行
2. 核心手法:用
Object.create创建共享原型对象,将方法统一挂载到原型上,实例只保留独有数据,彻底消灭百万级重复函数对象及其闭包作用域3. 不用类的智慧:因为TanStack_Table的特性是动态组合的(按需注册排序、筛选、分页等),单继承的Class难以优雅表达"条件式多重继承",手动原型模式更灵活
4. 唯一代价:方法不能再解构调用(如
const {getValue} = row会丢失this),且Object.keys/{...row}浅拷贝不会包含方法,但直接调用row.getValue()一切正常5. 通用启示:任何需要大规模创建相似对象的库或应用,都可以借鉴这种"共享原型+实例数据分离"的模式来优化内存
URL:https://tanstack.com/blog/tanstack-table-v9-memory-performance
《MDN 推出官方 MCP 服务器,让 AI 助手实时获取权威 Web 文档》
标签:#前端 #AI工具 #MCP #MDN #浏览器兼容性 #VSCode #Claude
总结:
MDN 官方发布了一款实验性 MCP(Model Context Protocol)服务器,旨在让 LLM 和编程助手直接访问 MDN 的搜索、文档及浏览器兼容性数据(BCD),解决 AI 回答中可能出现的过时或错误信息问题。开发者可通过远程服务或本地部署方式接入,支持 VS Code、Claude Code 等 MCP 兼容客户端,实现编码时一键查询 API 用法和兼容性,无需离开编辑器。
文章要点:
1. 官方出品,权威数据源:这是 MDN 官方推出的 MCP 服务器,直接对接 MDN 的搜索 API、文档 JSON API 以及浏览器兼容性数据(BCD),确保 AI 获取的是最新、最准确的 Web 平台技术资料,而不是训练数据中的"旧知识"
2. 六大核心工具,覆盖开发全场景:提供
3. 远程 + 本地双模式部署:既可以一键接入官方远程服务(
4. 无缝集成主流开发工具:完美支持 VS Code、Claude Code、Cursor 等 MCP 兼容客户端,配置简单,安装后直接在 AI 聊天中调用工具,真正实现"边写代码边查文档"的流畅体验
5. 实验性质,持续迭代中:目前处于实验阶段,Mozilla 会收集查询数据以优化服务(可 opt-out),且保留随时调整或下线服务的权利,建议开发者关注官方动态
URL:
https://developer.mozilla.org/en-US/blog/introducing-mdn-mcp-server/
标签:#前端 #AI工具 #MCP #MDN #浏览器兼容性 #VSCode #Claude
总结:
MDN 官方发布了一款实验性 MCP(Model Context Protocol)服务器,旨在让 LLM 和编程助手直接访问 MDN 的搜索、文档及浏览器兼容性数据(BCD),解决 AI 回答中可能出现的过时或错误信息问题。开发者可通过远程服务或本地部署方式接入,支持 VS Code、Claude Code 等 MCP 兼容客户端,实现编码时一键查询 API 用法和兼容性,无需离开编辑器。
文章要点:
1. 官方出品,权威数据源:这是 MDN 官方推出的 MCP 服务器,直接对接 MDN 的搜索 API、文档 JSON API 以及浏览器兼容性数据(BCD),确保 AI 获取的是最新、最准确的 Web 平台技术资料,而不是训练数据中的"旧知识"
2. 六大核心工具,覆盖开发全场景:提供
mdn_search(关键词搜索)、mdn_doc(获取完整文档)、mdn_compat(浏览器兼容性检查)、mdn_list(浏览 BCD 特性)、mdn_css(CSS 属性定义)、mdn_http(HTTP 参考)等工具,从查文档到看兼容性一站搞定3. 远程 + 本地双模式部署:既可以一键接入官方远程服务(
https://mcp.mdn.mozilla.net/),也可以克隆仓库本地运行,满足对数据隐私有顾虑的团队需求;本地模式支持 MCP Inspector 调试,开发体验友好4. 无缝集成主流开发工具:完美支持 VS Code、Claude Code、Cursor 等 MCP 兼容客户端,配置简单,安装后直接在 AI 聊天中调用工具,真正实现"边写代码边查文档"的流畅体验
5. 实验性质,持续迭代中:目前处于实验阶段,Mozilla 会收集查询数据以优化服务(可 opt-out),且保留随时调整或下线服务的权利,建议开发者关注官方动态
URL:
https://developer.mozilla.org/en-US/blog/introducing-mdn-mcp-server/
《TypeScript 每个人都该知道的实用技巧》
标签:#TypeScript #前端开发 #代码质量
总结:
这是一份精心整理的 TypeScript 实战模式合集,涵盖 15 个核心技巧,从基础类型安全到高级类型体操,帮助开发者写出更安全、更可维护、更愉悦的代码。每条建议都配有简洁示例,强调"类型安全不等于运行时安全"这一关键认知,适合各阶段 TS 开发者查漏补缺。
文章要点:
1. 用
2. 让类型推断为你工作:减少不必要的显式注解,避免类型拓宽和维护负担,代码更简洁
3. 用
4. 从值推导类型:用
5. 用可辨识联合建模不可能状态:用
6. 用
7. 配置和常量用
8. 用类型谓语做可复用的收窄:把运行时检查写成
9. 从现有类型构建新类型:掌握
10. 运行时校验外部数据:TypeScript 不验证 API 响应,配合 Zod 等库在边界做运行时校验
11. 多数场景避免
12. 优先使用可推断的泛型:好的 API 设计让用户无需手动传泛型参数,靠上下文自动推断
13. 开启严格编译选项:
14. 学习模板字面量类型:用 ``
15. 类型安全 ≠ 运行时安全:TS 提升正确性,但不替代校验、不保证架构、不消除运行时错误
URL:https://github.com/AllThingsSmitty/typescript-tips-everyone-should-know
标签:#TypeScript #前端开发 #代码质量
总结:
这是一份精心整理的 TypeScript 实战模式合集,涵盖 15 个核心技巧,从基础类型安全到高级类型体操,帮助开发者写出更安全、更可维护、更愉悦的代码。每条建议都配有简洁示例,强调"类型安全不等于运行时安全"这一关键认知,适合各阶段 TS 开发者查漏补缺。
文章要点:
1. 用
unknown 替代 any:强制做类型校验,守住类型安全的第一道防线,防止类型泄漏2. 让类型推断为你工作:减少不必要的显式注解,避免类型拓宽和维护负担,代码更简洁
3. 用
satisfies 代替 as:既验证类型兼容性,又保留具体推断,比强制断言更安全4. 从值推导类型:用
as const + typeof 让运行时和编译时保持同步,告别手动维护两份定义5. 用可辨识联合建模不可能状态:用
status 标签区分状态,比松散的可选属性对象更可靠、更易扩展6. 用
never 做穷尽检查:在 switch 的 default 分支里赋值 never,让未来漏改直接变成编译错误7. 配置和常量用
as const:把对象属性收窄为字面量类型,比如 "dark" 而不是宽泛的 string8. 用类型谓语做可复用的收窄:把运行时检查写成
value is User 形式,让编译器理解你的守卫逻辑9. 从现有类型构建新类型:掌握
Pick、Omit、Partial 等工具类型,用变换思维代替重复定义10. 运行时校验外部数据:TypeScript 不验证 API 响应,配合 Zod 等库在边界做运行时校验
11. 多数场景避免
enum:字面量联合类型通常更易重构、更易序列化、运行时行为更可控12. 优先使用可推断的泛型:好的 API 设计让用户无需手动传泛型参数,靠上下文自动推断
13. 开启严格编译选项:
strict、noUncheckedIndexedAccess 等标志是 TS 真正发挥价值的地方14. 学习模板字面量类型:用 ``
/api/${string} `` 这类模式约束路由、事件名、CSS 工具类等字符串15. 类型安全 ≠ 运行时安全:TS 提升正确性,但不替代校验、不保证架构、不消除运行时错误
URL:https://github.com/AllThingsSmitty/typescript-tips-everyone-should-know
《AI 正在重演前端的"失落十年"吗?》
标签:#前端 #AI编程 #职业发展 #软件工程 # craftsmanship #Bauhaus
总结:
作者将 AI 对编程行业的冲击与前十年 JavaScript 框架对前端的"去技能化"(deskilling)进行类比。框架把浏览器当作编译目标,让通用开发者无需理解 HTML 语义、无障碍、性能等底层知识就能"搞定"前端;AI 编码则进一步将手工写代码的技能消解为"操作半熟练工人使用的技术"。文章认为这降低了从业者议价能力、牺牲了质量,但也承认这是效率提升和抽象层级升高的必然趋势。作者借用 Bauhaus 运动的启示——不是对抗工业化,而是让工匠与工厂协作、以用户为中心重新设计——呼吁在 AI 时代依然需要"懂材料"的人,同时指出商业成功与软件质量本就很少相关,真正的 craft 只会成为更小的切片。
文章要点:
1. "去技能化"正在从特定领域扩散到整个编程行业:框架让前端从专精技能变成通用技能,AI 让编程本身面临同样命运
2. 现代"全栈开发者"往往不是前后端都精通,而是能用框架两边都糊弄的通才,企业因此获得成本节省和人员灵活调配
3. AI 编码是"非确定性抽象"——不像编译器那样稳定,输入或模型的微小变化会导致截然不同的结果,更像是"不会学习的初级工程师"
4. LLM 是 Stack Overflow 复制粘贴的终极进化:让懂行的人更快,让不懂的人也能凑出"能跑"的东西,但抽象泄漏时依然需要有人深入理解并修复
5. 商业成功与软件质量几乎不相关,糟糕的网站对转化率影响有限,且"没人因为选了 React 而被解雇"
6. Bauhaus 运动的启示:不复古也不对抗工业化,而是让设计师回到工坊、与材料共事,最终产出兼顾批量生产和用户体验的设计
7. 前端 craft 不会消失,但会成为更小的切片;就像字体设计不再是全职工作、塑料垃圾泛滥但好工业设计依然存在
8. 快速迭代和 MVP 有其价值,但需要知道自己在验证什么;性能和无障碍等基础如果一开始没做对,后期很难补救
9. AI 只是工具箱里的又一件工具,但 hype 周期内我们会看到丑陋的代码、破碎的沟通和借 AI 之名裁员
10. 作者自己的框架 Mastro 倡导"从简单栈开始、后续再添加功能",反对先上重型框架再试图优化
URL:https://mastrojs.github.io/blog/2026-05-23-is-AI-causing-a-repeat-of-frontends-lost-decade/
《别在 div 和 span 上乱加 aria-label》
标签:#前端 #Web无障碍 #ARIA #屏幕阅读器 #HTML语义化
总结:
本文通过实测数据揭示了在 div、span 等 generic 角色元素上使用 aria-label 的严重兼容性问题。ARIA 规范明确禁止为 generic 角色命名,而各屏幕阅读器的表现更是天差地别——有的只读标签、有的只读内容、有的两者都读、有的干脆忽略。这种不一致会让依赖辅助技术的用户获得错误信息,属于典型的"好心办坏事"。作者指出 section 和 popover 是例外,前者加标签会自动升级为 region 地标,后者角色会变为 group。
文章要点:
1. ARIA 规范 5.2.8.6 明确把 generic 角色列入"禁止命名"清单,div 和 span 默认就是这个角色
2. 实测 8 组屏幕阅读器+浏览器组合,对带 aria-label 的 div announcement 结果五花八门:VoiceOver 读"News, group"、TalkBack 只读"News"、JAWS/NVDA 完全忽略标签只读内容
3. 空 div 的测试结果更混乱,有的读"News, empty group"、有的完全静默,无法预测用户会听到什么
4. 这种不可预测性对屏幕阅读器用户是灾难性的——你以为在帮忙标注,实际上可能覆盖了真正有用的内容
5. 例外情况:section 元素加 aria-label 会自动从 generic 升级为 region 地标,这是规范允许的;带 popover 属性的 div 角色会变为 group,加标签也合法
6. 正确做法:需要可访问名称时,优先使用语义化标签(如 button、nav)或显式设置 role,而不是在裸 div 上硬塞 aria-label
URL:https://www.matuzo.at/blog/2026/aria-label-generic-elements
《CSS 与 JavaScript 动画性能之争》
标签:#前端 #CSS动画 #JavaScript动画 #WebAnimationsAPI #性能优化 #GSAP #Motion
总结:
本文通过交互式演示拆解了 CSS 与 JS 动画的性能差异真相:CSS Keyframes 和 Transitions 运行在独立线程,主线程阻塞时依然流畅;而传统 JS 动画(如 requestAnimationFrame 循环)与主线程争抢资源,容易卡顿。但 Motion 库通过底层调用 Web Animations API(WAAPI)绕过了这一限制,实现了与 CSS 同级别的流畅度。作者建议优先使用原生 CSS,遇到 CSS 无法覆盖的场景时选择 Motion 等 WAAPI 方案,而非直接上 GSAP 这类纯主线程库。
文章要点:
1. CSS 动画的核心优势不是"计算快",而是运行在独立线程,主线程再忙也不影响动画流畅度
2. 传统 JS 动画(requestAnimationFrame)每帧都在主线程计算,React 重渲染或 fetch 解析时容易掉帧
3. Motion 库(原 Framer Motion)底层使用 Web Animations API,能接入与 CSS 相同的底层动画引擎,主线程阻塞时照样丝滑
4. GSAP 功能极其强大,但坚持在主线程运行,是"能力换性能"的取舍,适合复杂序列动画而非简单过渡
5. 现代 CSS 已经很能打,View Transitions、linear()、Animation Timeline 等新 API 大幅减少了必须上 JS 的场景
6. 选型建议:能用 CSS 就不用库 → CSS 搞不定优先选 Motion/WAAPI → 只有复杂时间线控制才考虑 GSAP
URL:https://www.joshwcomeau.com/animation/css-vs-javascript/
《TanStack Router 与 Query 的最佳实践》
标签:#前端 #React #TanStackQuery #TanStackRouter #数据获取 #SSR
总结:
本文详解了 TanStack Router 与 TanStack Query 的集成方案,核心思路是将 Router 的 Loader 视为"预取触发器",让 Query 接管全局缓存。通过关闭 Router 内置缓存、在 Loader 中预取 Query、组件中使用 useSuspenseQuery 或 useQuery 的组合策略,实现数据尽早获取、避免请求瀑布,同时兼容 SSR 流式渲染。作者强调始终使用 Query Hooks 而非 useLoaderData 获取数据,以维持自动重取、缓存失效和垃圾回收的正常运作。
文章要点:
1. Router 自带缓存仅限单路由,Query 缓存全局可跨路由共享,更适合多路由共用数据场景
2. 在 Loader 中预取 Query 能让请求在组件渲染前甚至 JS 加载前就开始,配合 prefetch:'intent' 还能实现悬停预加载
3. 关闭 Router 缓存(defaultPreloadStaleTime: 0)避免与 Query 缓存冲突,让 Query 独掌缓存策略
4. 推荐用 useSuspenseQuery 配合 Router 的默认 Error/Pending 边界,组件只需专注"阳光路径"
5. Loader 中不 await 更灵活:useSuspenseQuery 实现阻塞加载,useQuery 实现延迟加载,由组件自主决定
6. SSR 场景下 useSuspenseQuery 更友好,支持流式渐进渲染;useQuery 需在 Loader 中 await 否则服务端无 markup
7. 切勿用 useLoaderData 替代 Query Hooks,否则会导致自动重取、失效刷新和垃圾回收全部失效
8. 将 Loader 视为"事件处理器"——只负责触发预取、不返回数据,是渐进优化性能的好心智模型
URL:https://tkdodo.eu/blog/tan-stack-router-and-query
《Chrome DevTools MCP v1 发布:为 AI 编码代理赋予浏览器调试超能力》
标签:#前端 #AI_Tools #Chrome_DevTools #MCP #Browser_Automation #Performance_Debugging
总结:
Chrome 团队正式发布 DevTools MCP v1,通过 Model Context Protocol 将 Chrome DevTools 的完整调试能力开放给 AI 编码代理。它让 Claude、Cursor、Copilot 等 AI 助手能够实时控制浏览器、抓取性能 trace、分析网络请求、检查控制台日志,甚至处理 1500 万行级别的性能数据,从而把"盲写代码"的 AI 变成能看、能测、能调优的闭环调试器。
文章要点:
1. 告别盲写时代:以前 AI 编码代理只能凭空推理代码,无法看到实际渲染效果。DevTools MCP 直接给 AI 装上"眼睛",让它能截图、查 DOM、读控制台、抓网络请求,基于真实浏览器状态做判断。
2. 40+ 工具全覆盖:从点击、填表、导航等自动化操作,到性能 trace 录制、Lighthouse 审计、内存堆快照、网络请求分析,几乎把 DevTools 面板的能力完整暴露给了 AI。
3. 性能分析是杀手锏:Paul Irish 演示了如何处理 1500 万行 JSON 的复杂性能 trace,MCP 服务器会解析并提炼出关键洞察,让 AI 帮你做原本需要资深性能专家才能完成的初步诊断。
4. 接入零门槛:支持 Claude Code、Cursor、Copilot、Gemini CLI、VS Code 等主流工具,一条 npx 命令即可启动,还能自动连接本地已运行的 Chrome 实例,无需额外配置。
5. 架构扎实可靠:底层基于 Chrome DevTools Protocol 和 Puppeteer,自动化操作自带智能等待,避免 flaky;同时支持 headless 和有头模式,适应不同场景需求。
URL:https://developer.chrome.com/blog/devtools-for-agents-v1
《Storybook 10.4 发布》
标签:#前端 #DevTools #Storybook #React #TanStackReact #ReactNative #AIAgent #MCP
总结:
Storybook 10.4 聚焦 AI 辅助开发与团队协作提效。AI Agent 现在能自动完成复杂项目的初始化、Mock 配置、Stories 编写与测试验证;侧边栏新增变更检测过滤器,帮你秒速锁定受代码改动影响的组件;一键分享让非技术成员无需等待 PR 或 CI 就能即时查看工作进度。此外还带来 TanStack React 官方支持、React Native 隔离优化,以及实验性的 React Component Meta 分析器,组件识别率达 100%,热更新速度最高提升 81 倍。
文章要点:
1. AI 全自动配置:只需一句 Prompt,AI Agent 就能分析项目结构、生成 Storybook 配置、编写 MSW Mock 和交互测试,并自动验证渲染效果。已在 Excalidraw、Bluesky 等复杂项目验证可行。
2. 侧边栏变更检测:新增 New、Modified、Related 三种过滤器,帮你秒速锁定代码变更波及的所有 Stories,特别适合 AI 生成代码后的快速审阅。
3. 一键云端分享:点击 Share 按钮即可将当前 Storybook 发布到 Chromatic,设计师和产品经理不用等 PR 或 CI,点开链接就能直接看效果、提反馈。
4. TanStack React 官方支持:全新 @storybook/tanstack-react 包,零配置接入类型安全路由与 Server Functions,由 Storybook 与 TanStack 核心团队联合打造。
5. React Native 隔离升级:新增独立应用入口,通过环境变量自动切换,Storybook 代码与业务代码完全隔离,零配置起步且向后兼容。
6. React Component Meta 实验特性:基于 Volar 和 TS Language Server 的新一代 Docgen,组件检出率 100%,开发模式热更新比旧方案快 43 到 81 倍,为 AI 提供更精准的组件元数据。
URL:https://storybook.js.org/blog/storybook-10-4/
《TanStack中的React服务端组件》
标签:#前端 #React_Server_Components #TanStack_Start #NextJs #Bundle_Optimization
总结:
TanStack Start实现了与Next.js截然不同的React服务端组件方案,通过显式API将组件渲染保留在服务端,避免将繁重代码发送至客户端。文章以应用外壳为例,展示RSC如何将客户端Bundle从308KB缩减至203KB,并说明其适合大型非交互式组件树的场景,同时澄清RSC并非数据加载或SSR的替代品,而是针对性的性能优化工具。
文章要点:
1. RSC是只在服务端运行的React组件,可以直接在组件里写await查数据,而且组件代码不会发送到浏览器,不用担心数据库密码暴露给前端
2. TanStack实现RSC的方式特别直白,通过renderServerComponent这类API就能显式声明,作者认为比Next.js的实现更好懂
3. 别误会,RSC不是用来替代数据加载或SSR的,TanStack的loader和原有的服务端渲染已经做得很好了,RSC真正的价值是帮浏览器"减肥"
4. 文章举了个生动的例子:故意引入整个图标库来模拟大型组件树,结果RSC把客户端JS从308KB砍到了203KB,省了不少流量
5. 更妙的是RSC还能接收客户端组件当"插槽"传进来,配合Suspense实现流式渲染,让页面边加载边呈现,体验很丝滑
6. 不过作者也提醒,RSC不是银弹,如果你的组件树不大、依赖不多,用它带来的收益可能微乎其微,得看场景取舍
URL:https://frontendmasters.com/blog/react-server-components-in-tanstack/