

Now vibe coding, so learning hammer FE ?
《设计系统应该默认就是快的》
标签:
#前端开发 #设计系统性能优化 #性能测试 #性能预算 #WebComponents #组件渲染优化
总结:
这篇文章通过实测十大主流开源设计系统(Mantine、Ant Design、Material UI、React Spectrum、Carbon、Fluent、Web Awesome、UI5、Spectrum Web Components、Ionic),论证了性能应当与设计系统团队所重视的可达性(accessibility)平起平坐:底层组件的每一个性能修复,都会同时惠及所有基于该设计系统构建的应用。测试发现性能优劣并不取决于框架本身,而在于具体实现细节,作者还深入剖析了 Ionic、Ant Design、UI5、React Spectrum 等慢速组件的根因,并给出了可行的修复建议,最后提供了基于 Playwright 的自动化性能测试方案与「Fast by Default(默认即快)」的理念。
文章要点:
1. 浏览器的 JavaScript 主线程是所有层共用的,设计系统组件越慢,留给应用代码的余地就越小——修复一个设计系统组件的性能,等于同时提升所有依赖它的应用。
2. 作者选取了十个基于不同框架(React、Lit、FAST、Stencil、SAP 自研框架)的设计系统,在 4 倍 CPU 降速、Chrome 155 环境下实测了两大典型场景:打开含 249 个国家的下拉选择器、一次性全选 100 个复选框。
3. 实测结果差异巨大:国家选择器从最快 Fluent 的 61ms 到最慢 Ionic 的 1,266ms(比第二名慢 5 倍以上);复选框从 Fluent 的 29ms 到 Ant Design 的 421ms——同一框架(如 React 或 Lit)内部差距同样悬殊,性能问题出在实现而非框架。
4. 十个设计系统中只有 Spectrum Web Components 在每个 PR 上自动跑组件级性能基准,多数团队只检查包体积——但包体积与组件在页面上的响应速度并无直接关系。
5. 作者逐一剖析了慢速根因:Ionic 因 Stencil 在无 shadow DOM 的场景下用
6. 性能瓶颈各有解法:长列表用虚拟滚动(Ant Design 的做法值得借鉴,还为屏幕阅读器保留了高亮项的隐藏副本);动画改由合成器线程运行的 opacity 渐变替代主线程上的颜色渐变;Stencil 可直接修复插槽回退内容的第三次检查,作者实测去掉后加 2000 个元素快约 7 倍。
7. 作者分享了用 Playwright + Chrome DevTools 协议(CPU 降速 4 倍 + Long Animation Frames 长帧 API)编写组件性能测试的完整代码,包含「总耗时预算 300ms」和「最长无响应帧不超过 100ms」两条性能预算(performance budget),以及一条「选项翻倍时耗时增长不超过 2.5 倍」的防 O(n²) 回归测试。
8. 落地的最佳实践是「默认就提供快的行为」:超过性能预算的列表自动切换虚拟化、复选框仅在被直接点击时才播放动画,并在文档中写明每个组件的测试数据规模上限,发布说明中给出修复前后的量化数据(如「500 个选项下打开从 300ms 降到 150ms」)。
9. 以上测试代码已开源在 GitHub 仓库 design-system-performance-tests 中,可直接复制改造用于自己的设计系统,并附带 GitHub Actions 工作流实现每个 PR 自动跑性能测试。
10. 文章结尾宣传了作者的新书《Fast by Default: Practical Performance Engineering》(Manning 早期访问版),把这套思路延伸到后端与移动端。
URL:https://denodell.com/blog/design-systems-should-be-fast-by-default
标签:
#前端开发 #设计系统性能优化 #性能测试 #性能预算 #WebComponents #组件渲染优化
总结:
这篇文章通过实测十大主流开源设计系统(Mantine、Ant Design、Material UI、React Spectrum、Carbon、Fluent、Web Awesome、UI5、Spectrum Web Components、Ionic),论证了性能应当与设计系统团队所重视的可达性(accessibility)平起平坐:底层组件的每一个性能修复,都会同时惠及所有基于该设计系统构建的应用。测试发现性能优劣并不取决于框架本身,而在于具体实现细节,作者还深入剖析了 Ionic、Ant Design、UI5、React Spectrum 等慢速组件的根因,并给出了可行的修复建议,最后提供了基于 Playwright 的自动化性能测试方案与「Fast by Default(默认即快)」的理念。
文章要点:
1. 浏览器的 JavaScript 主线程是所有层共用的,设计系统组件越慢,留给应用代码的余地就越小——修复一个设计系统组件的性能,等于同时提升所有依赖它的应用。
2. 作者选取了十个基于不同框架(React、Lit、FAST、Stencil、SAP 自研框架)的设计系统,在 4 倍 CPU 降速、Chrome 155 环境下实测了两大典型场景:打开含 249 个国家的下拉选择器、一次性全选 100 个复选框。
3. 实测结果差异巨大:国家选择器从最快 Fluent 的 61ms 到最慢 Ionic 的 1,266ms(比第二名慢 5 倍以上);复选框从 Fluent 的 29ms 到 Ant Design 的 421ms——同一框架(如 React 或 Lit)内部差距同样悬殊,性能问题出在实现而非框架。
4. 十个设计系统中只有 Spectrum Web Components 在每个 PR 上自动跑组件级性能基准,多数团队只检查包体积——但包体积与组件在页面上的响应速度并无直接关系。
5. 作者逐一剖析了慢速根因:Ionic 因 Stencil 在无 shadow DOM 的场景下用
appendChildSlotFix 模拟插槽、每次新增选项都要遍历全部既有子节点三次(O(n²));React Spectrum 因 React Aria 逐个清空高度再读取尺寸造成「布局抖动」;UI5 因隐藏弹层中预置全部 249 个选项,打开瞬间浏览器要一次性完成约 1500 个元素的样式计算;Ant Design 的慢则主要来自 100 个复选框同时触发的颜色渐变动画。6. 性能瓶颈各有解法:长列表用虚拟滚动(Ant Design 的做法值得借鉴,还为屏幕阅读器保留了高亮项的隐藏副本);动画改由合成器线程运行的 opacity 渐变替代主线程上的颜色渐变;Stencil 可直接修复插槽回退内容的第三次检查,作者实测去掉后加 2000 个元素快约 7 倍。
7. 作者分享了用 Playwright + Chrome DevTools 协议(CPU 降速 4 倍 + Long Animation Frames 长帧 API)编写组件性能测试的完整代码,包含「总耗时预算 300ms」和「最长无响应帧不超过 100ms」两条性能预算(performance budget),以及一条「选项翻倍时耗时增长不超过 2.5 倍」的防 O(n²) 回归测试。
8. 落地的最佳实践是「默认就提供快的行为」:超过性能预算的列表自动切换虚拟化、复选框仅在被直接点击时才播放动画,并在文档中写明每个组件的测试数据规模上限,发布说明中给出修复前后的量化数据(如「500 个选项下打开从 300ms 降到 150ms」)。
9. 以上测试代码已开源在 GitHub 仓库 design-system-performance-tests 中,可直接复制改造用于自己的设计系统,并附带 GitHub Actions 工作流实现每个 PR 自动跑性能测试。
10. 文章结尾宣传了作者的新书《Fast by Default: Practical Performance Engineering》(Manning 早期访问版),把这套思路延伸到后端与移动端。
URL:https://denodell.com/blog/design-systems-should-be-fast-by-default
《React 编译器到底做了什么》
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
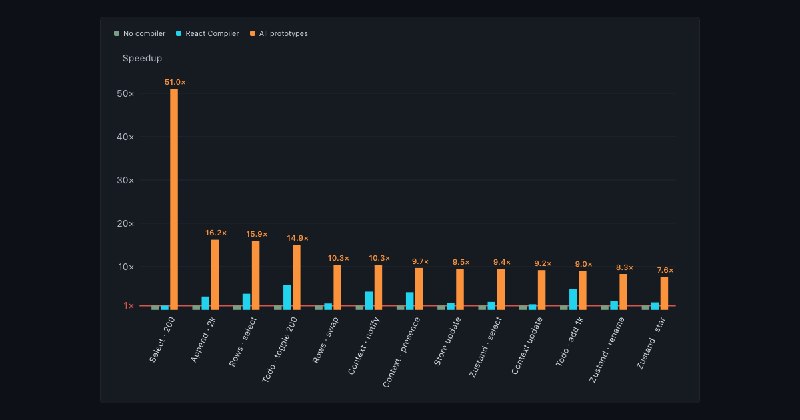
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
_c() 缓存槽位中,首次渲染写入缓存,后续渲染直接复用,本质上相当于给所有内容自动套上了 memo。2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
props.method() 拆成属性加载 + 普通调用),有的推断信息,有的做变换优化。4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
=== 判断挪进 selector 内部这一小改动就能带来数倍提升,编译器完全可以自动完成这类分析(200 次选择从 311.5 ms 降到 48.9 ms)。8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
《在 GitHub Copilot 应用中流畅渲染超大 Pull Request》
标签:
#软件工程 #前端性能优化 #PullRequest #虚拟化渲染 #React #测量调度 #滚动锚定 #性能监控
总结:
文章介绍了 GitHub Copilot 应用如何重构 Pull Request 视图,使其能够流畅处理包含 2,200 个文件、超过 100 万行代码变更和 400 多条内联评论的超大型 PR。核心挑战在于评论高度的动态性——与代码行不同,评论高度取决于 Markdown 换行、可展开区块、回复框和图片加载等渲染时才能确定的因素。团队通过分离确定性与动态几何、实现智能测量调度器、采用滚动锚定技术,并建立自动化测量循环来解决这一问题,最终实现了百万行 diff 的流畅浏览体验。
文章要点:
1. 代码与评论的几何分离:代码行高度固定且可预先计算,而评论高度动态变化。团队将文档高度分为确定性代码高度(精确前缀和)和动态块高度(估算后测量),两者独立管理,避免评论调整时重建整个代码几何。
2. 智能测量调度器:放弃每块一个 ResizeObserver 的方案(会触发反馈循环),改为单一的空闲和滚动门控测量通道。仅在视口附近约 2400px 范围内进行测量,屏幕上的块优先批量读取,离屏块最多做一次有限渲染,超过视口高度的块跳过测量。
3. 滚动锚定技术:当测量高度与估算不符时,通过身份而非像素来校正——记录用户锚定的行或块,应用高度增量后,将同一锚点解析到新像素位置并滚动,确保用户视线不跳动。区分用户滚动与程序滚动,避免侧边栏切换等操作误触发保护机制。
4. 数据管道优化:流式传输结构优先于内容,文件树和元数据在文档加载时即可渲染;语法高亮在主线程外运行,行先以纯文本显示;释放文档时保留最近几个 diff 的缓存,平衡内存与返回时的加载速度。
5. 自动化测量循环:建立"变更→测量→改进"的无人值守循环,包括无头探针车道(声明式流程 + 生产环境插桩)和自动驾驶仪(驱动真实桌面应用),通过健康信号(如无未填充间隙、评论块非空)自动检测问题,实现机械式调试而非人工复现。
URL:
https://github.blog/engineering/user-experience/rendering-huge-pull-requests-in-the-github-copilot-app/
《Vitest 5.0 正式发布》
标签:
#前端 #JavaScript #Vitest #测试框架 #单元测试 #性能优化 #BrowserMode #MockAPI #基准测试 #断言改进 #代码覆盖率
总结:
Vitest 5.0 于 2026 年 9 月 3 日正式发布,本次大版本以性能优化为核心,同时带来 Trace View 追踪视图、嵌套项目配置、
文章要点:
1. 性能大幅提升:通过共享 Vite 服务器、稳定的文件系统模块缓存、减少主进程与 worker 往返、加速 vm 池与浏览器模式等优化,整体测试速度提升 8%–53%,大型项目(1,280 模块)运行时间从 7.24s 降至 5.83s。
2. **新增
Browser Mode 内置 Trace Viewew**:开启
嵌套项目与配置继承继承**:内联项目默认继承根配置(无需
5. **新 API
8. **Mock
9. **更严格的断言行为**:未 await 的异步断言(
10. **
11. **报告器统一输出目录**:所有报告器输出集中到
12. **其他实用改进**:新增
13. **破坏性变更**:要求 Vite >= 6.4.0 和 Node.js >= 22.12.0,升级前建议查阅迁移指南。
URL:
https://vitest.dev/blog/vitest-5
标签:
#前端 #JavaScript #Vitest #测试框架 #单元测试 #性能优化 #BrowserMode #MockAPI #基准测试 #断言改进 #代码覆盖率
总结:
Vitest 5.0 于 2026 年 9 月 3 日正式发布,本次大版本以性能优化为核心,同时带来 Trace View 追踪视图、嵌套项目配置、
vi.when 条件 Mock、基准测试重写等多项重要更新,并默认启用更严格的断言与 clearMocks 行为,要求 Vite >= 6.4.0 和 Node.js >= 22.12.0。文章要点:
1. 性能大幅提升:通过共享 Vite 服务器、稳定的文件系统模块缓存、减少主进程与 worker 往返、加速 vm 池与浏览器模式等优化,整体测试速度提升 8%–53%,大型项目(1,280 模块)运行时间从 7.24s 降至 5.83s。
2. **新增
vitest doctor 诊断工具**:自动运行替代配置并推荐更快的选项,同时默认输出性能提示,帮助用户发现配置瓶颈。Browser Mode 内置 Trace Viewew**:开启
browser.traceView 后,可记录交互、断言和 DOM 快照,支持逐步回放测试过程,便于调试 CI 失败。嵌套项目与配置继承继承**:内联项目默认继承根配置(无需
extends: true),被引用的配置文件可声明自己的 projects,支持多级嵌套结构。5. **新 API
vi.when**:支持按参数定义不同的 Mock 返回值,支持深度相等和 expect.any() 等非对称匹配器,并可限制调用基准测试 API 重写API 重写**:bench 变为测试上下文 fixture,可在常规 test() 中使用,支持 fixtures、生命周期钩子、重试和断言,结果可存储并与基线定位器错误显示 ARIA 树ARIA 树**:浏览器模式下定位失败时,同时打印 ARIA 快照和 HTML,帮助快速理解 getByRole 等查询的匹配逻辑;定位器默认启用严格模式。8. **Mock
Temporal API**:假计时器现在同时模拟 Temporal 和 Date,适用于 vi.useFakeTimers() 和 vi.setSystemTime()。9. **更严格的断言行为**:未 await 的异步断言(
resolves、rejects 等)现在会导致测试失败;expect.poll 超时后拒绝并支持 AbortSignal 取消。10. **
clearMocks 默认启用**:每个测试前自动清除 Mock 调用历史,避免测试间报告器统一输出目录。11. **报告器统一输出目录**:所有报告器输出集中到
.vitest 目录,减少 .gitignore 配置;HTML 报告器支持 singleFile 选项生成单文件报告。12. **其他实用改进**:新增
--repeats 选项重复运行测试以排查 flaky 测试;injectCjsGlobals 可禁用 CJS 全局注入;覆盖率工具切换到维护中的 @vitest/istanbuljs 包。13. **破坏性变更**:要求 Vite >= 6.4.0 和 Node.js >= 22.12.0,升级前建议查阅迁移指南。
URL:
https://vitest.dev/blog/vitest-5
《Oxlint 原生集成 React Compiler:Lint 速度提升 3 倍,Rust 工具链再进一步》
标签:
#前端开发 #React #Rust #Oxlint #性能优化 #编译器
总结:
Oxlint 在 v1.79.0 中正式原生集成了 React Compiler 的 22 条 lint 规则,无需 Babel 管道即可在 Rust 层直接运行。这意味着开发者可以在 lint 阶段就捕获 React Compiler 的 bailout(回退)情况,而 lint 任务耗时从约 29.2 秒骤降至 9.1 秒(3.2 倍加速),若去掉其他 JS 插件甚至可达 11 倍。作者强调:使用 React Compiler 时,启用全部 lint 规则是"不可争议的前提条件",因为一次 bailout 就可能导致性能严重退化(如作者主页动画卡顿)。同时,oxc 的 Rust 版 React Compiler 构建时转换也已接近可用,比原版快约 2 倍。
文章要点:
1. React Compiler 的 Rust 重写已成官方版本 — React 团队近期发布了 Rust 重写的 React Compiler,作为新的 canonical 版本。作者已在 AI 建站工具 Outlyne 中使用近一年,彻底告别手动
2. 作者已全面迁移到 oxc 生态 — Rollup → Rolldown、ESLint → Oxlint、Prettier → oxfmt、Jest → Vitest,整体工具链已 Rust 化,但 React Compiler 的 lint 插件一直是瓶颈。
3. 旧方案的痛点:Babel 管道拖慢 lint 3 倍 — 此前通过 Oxlint 的 JS 插件支持运行 React Compiler linter,需要先跑 Babel 再跑 Compiler 核心构建 AST,导致 lint 任务耗时从 9 秒暴涨到 29 秒。
4. Oxlint v1.70.0 起引入原生支持 — 新增 nursery 规则
5. 推荐配置:correctness + 枚举剩余规则 — 启用
6. 速度实测:3.2 倍到 11 倍提升 — 原生规则下 lint 从 29.2s → 9.1s;若同时去掉无原生替代的 JS 插件(如 perfectionist),可进一步降至 2.6s,实现 11 倍加速。
7. 构建时转换也在推进中 — oxc 已合并原生构建时 transform,但 Rolldown/Vite 曾因二进制体积增加 17% 而暂时回退。oxc-transform-react v0.0.1 已发布,比原版 Rust Compiler 快约 2 倍,source map 已修复,支持 fast refresh,作者已在生产环境测试。
8. 迁移门槛极低 — 只需 lint 层面改动,不影响构建步骤。可用
9. 一个常见陷阱:props 重新赋值 —
10. 作者的底线原则 — "React Compiler without linting all bailouts considered unsafe"(不 lint 所有 bailout 的 React Compiler 视为不安全)。一次 bailout 曾导致其首页动画 placeholder 卡顿、视觉破碎。
URL:
https://blog.master.dev/react-compiler-linting-just-got-a-rust-native-speedup-in-oxlint/
标签:
#前端开发 #React #Rust #Oxlint #性能优化 #编译器
总结:
Oxlint 在 v1.79.0 中正式原生集成了 React Compiler 的 22 条 lint 规则,无需 Babel 管道即可在 Rust 层直接运行。这意味着开发者可以在 lint 阶段就捕获 React Compiler 的 bailout(回退)情况,而 lint 任务耗时从约 29.2 秒骤降至 9.1 秒(3.2 倍加速),若去掉其他 JS 插件甚至可达 11 倍。作者强调:使用 React Compiler 时,启用全部 lint 规则是"不可争议的前提条件",因为一次 bailout 就可能导致性能严重退化(如作者主页动画卡顿)。同时,oxc 的 Rust 版 React Compiler 构建时转换也已接近可用,比原版快约 2 倍。
文章要点:
1. React Compiler 的 Rust 重写已成官方版本 — React 团队近期发布了 Rust 重写的 React Compiler,作为新的 canonical 版本。作者已在 AI 建站工具 Outlyne 中使用近一年,彻底告别手动
useCallback/useMemo。2. 作者已全面迁移到 oxc 生态 — Rollup → Rolldown、ESLint → Oxlint、Prettier → oxfmt、Jest → Vitest,整体工具链已 Rust 化,但 React Compiler 的 lint 插件一直是瓶颈。
3. 旧方案的痛点:Babel 管道拖慢 lint 3 倍 — 此前通过 Oxlint 的 JS 插件支持运行 React Compiler linter,需要先跑 Babel 再跑 Compiler 核心构建 AST,导致 lint 任务耗时从 9 秒暴涨到 29 秒。
4. Oxlint v1.70.0 起引入原生支持 — 新增 nursery 规则
react/react-compiler,直接在 Rust 中运行 React Compiler,无需 Babel。v1.79.0 正式发布 22 条 Compiler 驱动的规则,覆盖 React 规则的验证。5. 推荐配置:correctness + 枚举剩余规则 — 启用
correctness 类别可覆盖 12 条规则,再手动列出其余 10 条。若启用 restriction 类别则自动再纳入 5 条,suspicious 纳入 4 条,perf 纳入 1 条。6. 速度实测:3.2 倍到 11 倍提升 — 原生规则下 lint 从 29.2s → 9.1s;若同时去掉无原生替代的 JS 插件(如 perfectionist),可进一步降至 2.6s,实现 11 倍加速。
7. 构建时转换也在推进中 — oxc 已合并原生构建时 transform,但 Rolldown/Vite 曾因二进制体积增加 17% 而暂时回退。oxc-transform-react v0.0.1 已发布,比原版 Rust Compiler 快约 2 倍,source map 已修复,支持 fast refresh,作者已在生产环境测试。
8. 迁移门槛极低 — 只需 lint 层面改动,不影响构建步骤。可用
npx @oxlint/migrate 自动迁移 ESLint flat config,或让 LLM 帮忙。甚至可以先并行跑 Oxlint 和 ESLint,只替换 React Compiler 插件就能提速。9. 一个常见陷阱:props 重新赋值 —
function MyComponent({ value }) { value = value ?? fallback; } 这种写法会让整个组件被 Compiler 跳过(bailout),导致性能退化。建议用解构重命名解决,同时开启 eslint/no-param-reassign 规则。10. 作者的底线原则 — "React Compiler without linting all bailouts considered unsafe"(不 lint 所有 bailout 的 React Compiler 视为不安全)。一次 bailout 曾导致其首页动画 placeholder 卡顿、视觉破碎。
URL:
https://blog.master.dev/react-compiler-linting-just-got-a-rust-native-speedup-in-oxlint/

《smol-toml:小而快的 TOML 解析与序列化库》
标签:
#开发工具 #JavaScript #TOML #NPM #性能优化 #配置解析 #BigInt #TemporalAPI
总结:
smol-toml 是一款轻量、高速且遵循 TOML 1.1.0 规范的 JavaScript 解析与序列化库,目前已是 npm 上下载量最高的 TOML 解析器,被众多框架和工具在生产环境中广泛使用。
文章要点:
1. 小而快的 TOML 解析器:smol-toml 主打"小体积、高性能、正确性",在保持与 TOML v1.1.0 规范高度兼容的同时,解析和序列化速度均领先同类库,是 npm 上最受欢迎的 TOML 解析器。
2. API 简洁易用:提供
3. 整数与 BigInt 支持:默认情况下整数和浮点数都解析为 JavaScript Number(即浮点数),丢失类型信息且不支持超过 53 位的整数;可通过
4. 日期时间处理灵活:使用扩展的
5. 性能表现亮眼:在基准测试中,smol-toml 的解析速度仅次于走捷径牺牲正确性的 fast-toml,序列化速度则全面领先;处理 5MB 大文件时,解析和序列化性能均大幅优于 @iarna/toml、@ltd/j-toml 等主流库。
6. 已知局限透明公开:由于 JavaScript 语言限制,不会拒绝无效 UTF-8 字符串和某些无效日期(如 2 月 30 日会被解析为 3 月 2 日);具体跳过的测试项和原因在
URL:
https://github.com/squirrelchat/smol-toml
标签:
#开发工具 #JavaScript #TOML #NPM #性能优化 #配置解析 #BigInt #TemporalAPI
总结:
smol-toml 是一款轻量、高速且遵循 TOML 1.1.0 规范的 JavaScript 解析与序列化库,目前已是 npm 上下载量最高的 TOML 解析器,被众多框架和工具在生产环境中广泛使用。
文章要点:
1. 小而快的 TOML 解析器:smol-toml 主打"小体积、高性能、正确性",在保持与 TOML v1.1.0 规范高度兼容的同时,解析和序列化速度均领先同类库,是 npm 上最受欢迎的 TOML 解析器。
2. API 简洁易用:提供
parse() 和 stringify() 两个核心方法,用法类似 JSON 全局对象;stringify 会自动忽略对象中的 undefined 和 null 值,但数组中的这些值会被拒绝。3. 整数与 BigInt 支持:默认情况下整数和浮点数都解析为 JavaScript Number(即浮点数),丢失类型信息且不支持超过 53 位的整数;可通过
integersAsBigInt: true 选项启用 BigInt 支持,实现端到端类型保留。4. 日期时间处理灵活:使用扩展的
Date 对象(TomlDate)表示 TOML 的所有日期类型,支持 Offset Date Time、Local Date Time、Local Date 和 Local Time;序列化时支持 Temporal API,但时区信息会转换为偏移量。5. 性能表现亮眼:在基准测试中,smol-toml 的解析速度仅次于走捷径牺牲正确性的 fast-toml,序列化速度则全面领先;处理 5MB 大文件时,解析和序列化性能均大幅优于 @iarna/toml、@ltd/j-toml 等主流库。
6. 已知局限透明公开:由于 JavaScript 语言限制,不会拒绝无效 UTF-8 字符串和某些无效日期(如 2 月 30 日会被解析为 3 月 2 日);具体跳过的测试项和原因在
run-toml-test.bash 中有详细说明。URL:
https://github.com/squirrelchat/smol-toml
《TanStack_Markdown与TanStack_Highlight发布:让技术文档渲染回归轻量》
标签:#前端 #TanStack #Markdown渲染 #语法高亮 #性能优化 #React #TypeScript
总结:
TanStack发布两个新库:Markdown解析器与Highlight语法高亮,专为技术博客、文档和AI流式输出设计。通过将Markdown解析与语法高亮解耦,采用轻量级AST和语义化CSS类,将文档页脚本体积从1.1MiB大幅缩减至约27KiB,彻底摆脱了对React_Server_Components的依赖,实现了"让内容回归内容"的极简渲染理念。
文章要点:
1. 痛点很真实:原来tanstack.com的文档页光是语法高亮就占了358KiB,加上Shiki、WASM、主题等,读个页面像下载小型出版系统,不得不靠RSC把负担藏到服务器端
2. 两个库分工明确:Markdown负责把内容解析成可序列化的普通数据树,Highlight负责把已知语言转成带语义CSS类的HTML,互不依赖,按需组合
3. 体积真的小:Markdown解析器仅4.9KB(gzipped),HTML渲染器约6.7KB,Highlight核心才1.7KB,25种语言全包也才8KB,零运行时依赖
4. 暗色模式超优雅:Highlight输出一套带th-语义类的HTML,主题通过CSS变量切换,不用重新高亮,明暗切换只是一次CSS操作
5. AI流式输出有新招:不用维护复杂的增量解析状态,每次收到新文本就同步重新解析,已完成块保持稳定,未完成的标题列表不会留空占位
6. 已经扛住实战考验:这两个库已全面替换tanstack.com的文档和博客渲染,测试覆盖333个真实文档fixtures,不是玩具是生产力工具
URL:https://tanstack.com/blog/introducing-tanstack-markdown-and-highlight
《Node.js流内存泄漏生产级排查手册:五大隐蔽陷阱与五则铁律》
标签:#NodeJS #后端 #流处理 #内存优化 #性能调优
总结:
文章要点:
1. 五大隐蔽泄漏模式:①客户端断开但服务端未感知(legacy pipe() 不处理 premature close)②手动事件解绑是噩梦(async iterator 的 break 自动触发 destroy)③超时只杀响应不杀上游(AbortSignal.timeout 才能全链路终止)④数据库生命周期绑定网络速度(应解耦上游资源与下游传输)⑤pipeline() 异步 destroy 的竞态窗口(catch 里手动补刀 source.destroy)
2. 五则生产铁律:Rule 1 永远用 pipeline() 替代 .pipe(),自动处理错误/完成/背压传播;Rule 2 尊重 .write() 的布尔返回值,并掌握防"Drain Hang"的 AbortController 竞速清理写法;Rule 3 谁创建谁销毁,try/finally + AbortSignal 是标配;Rule 4 用 --max-old-space-size=128 做本地压测,看 writableLength 是否脱离 highWaterMark 失控飙升;Rule 5 写单元测试验证背压,用低 highWaterMark 的慢消费者 mock 检测队列是否暴涨
3. 未来方向:Node.js 正推动"stream-less future",用纯 async generator + pipeline() 替代 legacy Stream API,从 push 模式转为 pull 模式,背压协作变成结构性而非手动检查;Node.js 22 的 stream.compose() 可将多个 generator/流封装为可复用的 Duplex 单元
4. 核心洞察:Node.js 流基于信任系统,破坏信任时不会大声报错,而是静默累积直到崩溃。四行修复代码(检查 write 返回值 + await drain)只是起点,真正的挑战在于理解生产环境中连接断开、超时、慢网络等边界情况
URL:https://frontendmasters.com/blog/the-production-playbook-for-node-js-stream-leaks/
《Python 3.15的JIT编译器重回正轨》
标签:#Python #JIT #CPython #性能优化 #Faster_CPython #编译器 #开源社区
总结:
Python 3.15的JIT编译器开发取得突破性进展,在失去主要赞助商后通过社区协作成功实现性能目标。目前macOS AArch64平台比解释器快11-12%,Linux x86_64快5-6%,提前完成预定目标。文章强调了团队建设、任务分解和幸运的技术决策(如追踪记录解释器和引用计数消除)对项目成功的关键作用。
文章要点:
- **性能目标提前达成**:Python 3.15的JIT在macOS AArch64上比尾调用解释器快11-12%,在Linux x86_64上比标准解释器快5-6%,提前一年多完成目标
- **从困境中重生**:Faster CPython团队2025年失去主要赞助商后,通过社区托管模式维持开发,作者曾怀疑JIT项目能否成功
- **降低"巴士因子"风险**:团队计划在JIT的前端(区域选择器)、中端(优化器)、后端(代码生成器)各配备2名活跃维护者,目前中端已有4名贡献者
- **任务分解吸引新人**:将复杂优化问题拆分为简单任务(如"优化单条指令"),提供详细可操作的指导,让无JIT经验的C程序员也能参与,共11人参与核心重构
- **关键技术决策**:Brandt建议改用追踪式前端,Mark建议双分派表机制,意外地将追踪解释器性能从慢6%提升到快1.x%,并将JIT代码覆盖率提升50%
- **引用计数消除优化**:消除每条Python指令的分支操作,这一优化易于并行化且适合教学,是3.15版本的主要优化方向
- **基础设施支撑**:Savannah Ostrowski一人搭建了等效于整个基础设施团队的CI系统,每日性能测试帮助快速发现回归问题
文章URL:
https://fidget-spinner.github.io/posts/jit-on-track.html
《关于协作编辑的谎言(第二部分):为什么我们不用Yjs》
标签:#前端 #ProseMirror #CRDT #协作编辑 #性能优化 #Yjs #实时协作
总结:
本文是Moment.dev团队关于协作编辑算法分析的第二部分,作者详细阐述了为何在生产环境中放弃Yjs而选择基于ProseMirror-collab的简单方案。文章指出Yjs存在严重的性能问题(每次协作编辑会销毁重建整个文档)、与文档Schema冲突、权限控制困难、调试困难以及墓碑数据占用内存等问题。作者认为,除非真正需要无主节点的P2P架构,否则40行代码的"简单方案"在性能、可维护性和开发体验上都优于复杂的CRDT实现。
文章要点:
- Yjs存在严重性能缺陷:每次协作编辑会销毁并重建整个文档,导致60fps目标难以达成,影响NodeView、插件状态、撤销功能和光标位置管理
- 简单方案仅需40行代码:使用prosemirror-collab库,通过单一权威节点管理文档版本和事务,支持乐观更新、离线编辑和网络中断恢复
- Yjs与文档Schema冲突:在无主节点架构下难以验证事务有效性,可能导致数据永久丢失,升级时尤其危险
- 权限控制复杂化:需要将Yjs的XML更新预测转换为ProseMirror事务来判断权限,实现难度大
- 墓碑数据问题:Yjs需保留删除标记,导致内存持续增长或数据丢失风险,而简单方案通过数据库存储步骤即可解决
- 调试困难:CRDT仅保证最终一致性,难以区分暂时分歧与真正错误,调试工具受限
- 核心观点:技术选型应从最终用户体验出发,而非算法本身;如无P2P刚需,简单方案在各方面均优于CRDT
文章URL:https://www.moment.dev/blog/lies-i-was-told-pt-2
《前端内存泄漏:500仓库静态分析与五场景基准测试实证研究》
标签:#前端 #内存泄漏 #性能优化 #React #Vue #Angular #useEffect #静态分析 #基准测试
总结(一段话概括)
该研究对500个开源前端仓库(React/Vue/Angular)进行AST静态分析,发现86%的代码库存在至少一处缺失清理的内存泄漏模式,共识别55,864个潜在泄漏点,其中定时器清理缺失占比最高(43.9%)。通过五个控制变量的基准测试(各50轮×100次挂载循环)证实:每处未清理模式每次挂载/卸载循环平均泄漏约8KB内存,呈线性累积趋势;而正确清理的版本内存增长接近零(约2KB总计)。研究揭示了内存泄漏在前端生产代码中的普遍性及其对长会话应用(如仪表板、视频会议)的性能威胁,并提供了针对性的修复方案。
文章要点:
- 高普遍性:扫描714,217个文件发现55,864处潜在泄漏,430/500个仓库(86%)存在至少一处缺失清理模式,涵盖Kibana、Next.js等知名项目
- 主要泄漏源:定时器未清理(43.9%,22,384处)居首,其次是事件监听器(19.0%)、订阅未取消(13.9%)、useEffect无清理函数(9.3%)
- 统一泄漏成本:五个跨框架场景(React useEffect、Vue onMounted、Angular subscribe、Vue watch、RAF)均显示每循环约8KB线性内存增长,标准差极小(±0.6–37KB),而正确清理版本仅2-3KB噪声基线
- 统计显著性:效应量Cohen's d > 200(BAD与GOOD分布零重叠),p < 0.001,统计功效超99.99%,证实清理缺失是内存占用的主导变量
- 框架差异:React占发现总量62.3%(样本加权),Vue的
- 高危上下文:组件生命周期代码(32.9%)和事件绑定(24.5%)是高发区,因路由切换、标签页切换会频繁触发挂载/卸载
- 实际影响:单泄漏模式200次导航累积1.6MB,多模式叠加可达8MB/会话,足以触发移动端浏览器(iOS Safari 80-120MB阈值)杀标签页
- 修复成本低:92.3%的修复仅需单行代码(返回清理函数、存储stop handle、takeUntil模式),ROI极高
- 工具链缺口:现有ESLint规则(如react-hooks/exhaustive-deps)无法检测清理函数缺失,需借助AST级静态分析或生产环境堆内存监控
文章URL
https://stackinsight.dev/blog/memory-leak-empirical-study/
标签:#前端 #内存泄漏 #性能优化 #React #Vue #Angular #useEffect #静态分析 #基准测试
总结(一段话概括)
该研究对500个开源前端仓库(React/Vue/Angular)进行AST静态分析,发现86%的代码库存在至少一处缺失清理的内存泄漏模式,共识别55,864个潜在泄漏点,其中定时器清理缺失占比最高(43.9%)。通过五个控制变量的基准测试(各50轮×100次挂载循环)证实:每处未清理模式每次挂载/卸载循环平均泄漏约8KB内存,呈线性累积趋势;而正确清理的版本内存增长接近零(约2KB总计)。研究揭示了内存泄漏在前端生产代码中的普遍性及其对长会话应用(如仪表板、视频会议)的性能威胁,并提供了针对性的修复方案。
文章要点:
- 高普遍性:扫描714,217个文件发现55,864处潜在泄漏,430/500个仓库(86%)存在至少一处缺失清理模式,涵盖Kibana、Next.js等知名项目
- 主要泄漏源:定时器未清理(43.9%,22,384处)居首,其次是事件监听器(19.0%)、订阅未取消(13.9%)、useEffect无清理函数(9.3%)
- 统一泄漏成本:五个跨框架场景(React useEffect、Vue onMounted、Angular subscribe、Vue watch、RAF)均显示每循环约8KB线性内存增长,标准差极小(±0.6–37KB),而正确清理版本仅2-3KB噪声基线
- 统计显著性:效应量Cohen's d > 200(BAD与GOOD分布零重叠),p < 0.001,统计功效超99.99%,证实清理缺失是内存占用的主导变量
- 框架差异:React占发现总量62.3%(样本加权),Vue的
watch未存储stop handle(3,989处)和Angular的.subscribe()未取消(5,327处)均为高危模式- 高危上下文:组件生命周期代码(32.9%)和事件绑定(24.5%)是高发区,因路由切换、标签页切换会频繁触发挂载/卸载
- 实际影响:单泄漏模式200次导航累积1.6MB,多模式叠加可达8MB/会话,足以触发移动端浏览器(iOS Safari 80-120MB阈值)杀标签页
- 修复成本低:92.3%的修复仅需单行代码(返回清理函数、存储stop handle、takeUntil模式),ROI极高
- 工具链缺口:现有ESLint规则(如react-hooks/exhaustive-deps)无法检测清理函数缺失,需借助AST级静态分析或生产环境堆内存监控
文章URL
https://stackinsight.dev/blog/memory-leak-empirical-study/
《我们将 Node.js 内存占用减少了一半》
标签:#后端 #Node.js #V8 #性能优化 #内存管理 #Docker
本文介绍了通过启用 V8 引擎的指针压缩(Pointer Compression)技术,在不修改代码的情况下将 Node.js 应用内存占用减少约 50%,且仅带来 2-4% 的平均延迟开销,同时显著降低 P99 延迟。Cloudflare 与 Igalia 合作解决了历史性的"4GB 内存笼"限制,使每个 Worker 线程拥有独立的 4GB 压缩内存空间。
文章要点:
- 技术原理:指针压缩将 64 位指针转为 32 位偏移量,使每个指针从 8 字节减至 4 字节,内存占用减半,代价是每次堆访问需额外的加减法运算
- 历史障碍:此前 Node.js 未默认启用是因所有 Worker 线程共享单一 4GB 内存空间,2024 年 Cloudflare 与 Igalia 合作推出 IsolateGroups 功能,使每个 V8 实例拥有独立的 4GB 压缩内存笼
- 实验结果:在 Next.js 电商应用基准测试中,指针压缩实现内存减半(2GB→1GB),平均延迟仅增加 2.5-4.2%,但 P99 延迟降低 7-43%,最大延迟降低 6-38%,因更小的堆减少了 GC 暂停时间
- 业务价值:可显著降低 Kubernetes 集群成本、提升多租户 SaaS 密度、支持边缘计算部署、增加 WebSocket 并发连接数
- 兼容性限制:每个 V8 实例仍受 4GB 堆内存限制;使用旧版 NAN 的原生插件不兼容,但 Node-API 插件不受影响
- 使用方式:通过
链接:https://blog.platformatic.dev/we-cut-nodejs-memory-in-half
标签:#后端 #Node.js #V8 #性能优化 #内存管理 #Docker
本文介绍了通过启用 V8 引擎的指针压缩(Pointer Compression)技术,在不修改代码的情况下将 Node.js 应用内存占用减少约 50%,且仅带来 2-4% 的平均延迟开销,同时显著降低 P99 延迟。Cloudflare 与 Igalia 合作解决了历史性的"4GB 内存笼"限制,使每个 Worker 线程拥有独立的 4GB 压缩内存空间。
文章要点:
- 技术原理:指针压缩将 64 位指针转为 32 位偏移量,使每个指针从 8 字节减至 4 字节,内存占用减半,代价是每次堆访问需额外的加减法运算
- 历史障碍:此前 Node.js 未默认启用是因所有 Worker 线程共享单一 4GB 内存空间,2024 年 Cloudflare 与 Igalia 合作推出 IsolateGroups 功能,使每个 V8 实例拥有独立的 4GB 压缩内存笼
- 实验结果:在 Next.js 电商应用基准测试中,指针压缩实现内存减半(2GB→1GB),平均延迟仅增加 2.5-4.2%,但 P99 延迟降低 7-43%,最大延迟降低 6-38%,因更小的堆减少了 GC 暂停时间
- 业务价值:可显著降低 Kubernetes 集群成本、提升多租户 SaaS 密度、支持边缘计算部署、增加 WebSocket 并发连接数
- 兼容性限制:每个 V8 实例仍受 4GB 堆内存限制;使用旧版 NAN 的原生插件不兼容,但 Node-API 插件不受影响
- 使用方式:通过
platformatic/node-caged Docker 镜像一键替换官方 Node.js 镜像即可启用链接:https://blog.platformatic.dev/we-cut-nodejs-memory-in-half
