

Now vibe coding, so learning hammer FE ?
《React 编译器到底做了什么》
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
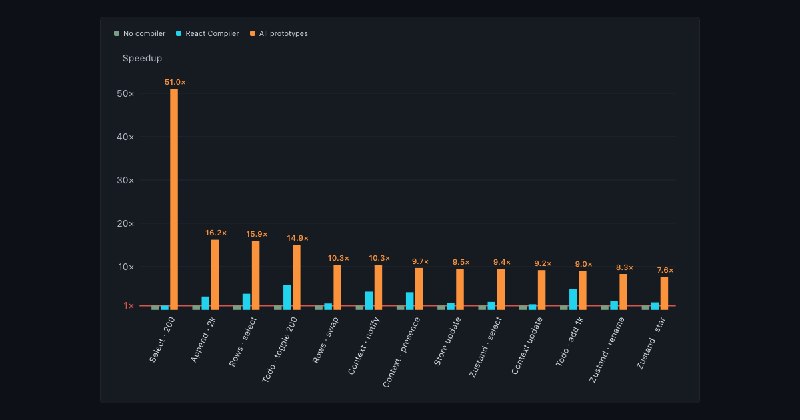
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
标签:
#前端工程 #编译器优化 #ReactCompiler #组件内联 #细粒度更新 #状态选择器 #性能基准测试
总结:
作者 Jimmy Miller 通过"边做边讲"的方式拆解 React Compiler 的工作原理:它把组件代码转成基于 memo cache 槽位的低级形式,绕开 Hooks 规则限制自动做记忆化。在此之上,他手工原型化了一系列激进优化(组件内联、Block DOM、列表缓存、Context 选择器、外部 store 选择器等),在 13 项微基准测试中最高取得 51 倍加速,但强调这些都只是探索性原型,不代表 React 官方应该采纳。
文章要点:
1. React Compiler 的输出特征是把 JSX 构造包进
_c() 缓存槽位中,首次渲染写入缓存,后续渲染直接复用,本质上相当于给所有内容自动套上了 memo。2. 编译产物用的是比 Hooks 更底层的 API,可以在条件返回之后做缓存,绕开"useMemo 不能写在条件分支后"这类 Hooks 规则的限制,作者认为这个啰嗦的形式正是理想的编译目标。
3. 编译器内部先把代码转成 SSA(静态单赋值)形式,再跑大量 pass:有的简化代码(如把
props.method() 拆成属性加载 + 普通调用),有的推断信息,有的做变换优化。4. 作者尝试组件内联,结果反而更慢(1038 ms 对比编译器的 444 ms),因为内联破坏了 Row 组件自带的缓存边界;说明内联本身只是为后续优化铺路的前置步骤。
5. 借鉴 Million.js 的思路实现 Block DOM(静态/动态分离、按状态 diff 而非树 diff)后,追加 2000 行从 1038 ms 降到 164 ms,内联反而开始带来收益,因为静态边界变得更大了。
6. 列表选择优化借鉴 Solid 的 createSelector:记录选中值变化只影响"旧选中行"和"新选中行",200 次选择从 250 ms 降到 5.4 ms;Context 细分选择器把 typing 更新场景从 80 ms 降到 11.7 ms。
7. 对 Zustand 这类外部 store,把
=== 判断挪进 selector 内部这一小改动就能带来数倍提升,编译器完全可以自动完成这类分析(200 次选择从 311.5 ms 降到 48.9 ms)。8. 作者反复强调:微基准测试的胜利不等于生产环境该采纳,真正的难点不在原型而在验证——理解真实负载、权衡内存代价、与生态和未来规划对齐;此外 SSR、hydration 等方向尚未触及。
URL:https://jimmyhmiller.com/what-does-the-react-compiler-even-do
《在 GitHub Copilot 应用中流畅渲染超大 Pull Request》
标签:
#软件工程 #前端性能优化 #PullRequest #虚拟化渲染 #React #测量调度 #滚动锚定 #性能监控
总结:
文章介绍了 GitHub Copilot 应用如何重构 Pull Request 视图,使其能够流畅处理包含 2,200 个文件、超过 100 万行代码变更和 400 多条内联评论的超大型 PR。核心挑战在于评论高度的动态性——与代码行不同,评论高度取决于 Markdown 换行、可展开区块、回复框和图片加载等渲染时才能确定的因素。团队通过分离确定性与动态几何、实现智能测量调度器、采用滚动锚定技术,并建立自动化测量循环来解决这一问题,最终实现了百万行 diff 的流畅浏览体验。
文章要点:
1. 代码与评论的几何分离:代码行高度固定且可预先计算,而评论高度动态变化。团队将文档高度分为确定性代码高度(精确前缀和)和动态块高度(估算后测量),两者独立管理,避免评论调整时重建整个代码几何。
2. 智能测量调度器:放弃每块一个 ResizeObserver 的方案(会触发反馈循环),改为单一的空闲和滚动门控测量通道。仅在视口附近约 2400px 范围内进行测量,屏幕上的块优先批量读取,离屏块最多做一次有限渲染,超过视口高度的块跳过测量。
3. 滚动锚定技术:当测量高度与估算不符时,通过身份而非像素来校正——记录用户锚定的行或块,应用高度增量后,将同一锚点解析到新像素位置并滚动,确保用户视线不跳动。区分用户滚动与程序滚动,避免侧边栏切换等操作误触发保护机制。
4. 数据管道优化:流式传输结构优先于内容,文件树和元数据在文档加载时即可渲染;语法高亮在主线程外运行,行先以纯文本显示;释放文档时保留最近几个 diff 的缓存,平衡内存与返回时的加载速度。
5. 自动化测量循环:建立"变更→测量→改进"的无人值守循环,包括无头探针车道(声明式流程 + 生产环境插桩)和自动驾驶仪(驱动真实桌面应用),通过健康信号(如无未填充间隙、评论块非空)自动检测问题,实现机械式调试而非人工复现。
URL:
https://github.blog/engineering/user-experience/rendering-huge-pull-requests-in-the-github-copilot-app/
《框架还重要吗?》
标签:
#编程 #Web开发 #AI编程 #前端框架 #React #软件工程 #技术趋势 #VibeCoding
总结:
这是一篇探讨在 AI 编程时代 Web 框架是否仍然重要的深度分析文章。作者 Brooks Lybrand 作为拥有三年开源框架开发经验的前端工程师,针对"模型已经足够好,框架选择不再重要"的流行观点进行了系统性反驳,论证了框架在提供抽象、结构和约束方面的核心价值,并呼吁行业继续创新和构建新框架。
文章要点:
1. **对"React 已赢"论的质疑**:作者指出当前流行观点认为由于 LLM 训练数据中 React 代码最多,模型最熟悉 React,因此无需尝试其他框架。但他认为这种逻辑存在矛盾——如果框架真的不重要,那连 React 都不需要,直接用 Web Components 或让 AI 生成原生代码即可。
2. **框架的本质价值**:作者将框架的价值精炼为三点:**提供抽象(Abstractions)、结构(Structure)和约束(Constraints)**。这些价值不仅适用于人类开发者,对 AI 编程同样关键——良好的抽象能避免 AI 重复造轮子或创建混乱的临时方案;清晰的结构帮助 AI 生成可维护的代码;明确的约束(如类型检查、测试)能防止 AI 在迭代中破坏系统。
3. **AI 时代框架的隐性存在**:引用 React 核心团队成员 Ricky Hanlon 的观点"你要么使用框架,要么构建框架",作者强调即使不显式选择框架,AI 在生成代码时也会隐式地创建框架。与其让 AI 生成一个缺乏维护、充满临时补丁的"隐性框架",不如使用经过实战检验、文档完善的开源框架。
4. **开发者体验(DX)的重构**:通过分析 HMR(热模块替换)、TypeScript 和
5. **框架战争的终结与新机遇**:作者认为 2013-2024 年的"框架战争"已经结束,人们不再渴望为框架争论,但这不意味着框架不再重要。他指出当前框架领域仍存在明显不足,特别是缺乏真正全栈、基于 Web 标准、易于 AI 协作且代码可理解的 JavaScript 框架。
6. **对未来的呼吁**:尽管承认 AI 正在重塑软件开发,且没人知道其长期影响,作者仍坚持认为认为"所有问题都已解决"是一种颓废的态度。他呼吁继续构建新框架,探索更好的抽象和模式,而不是停留在"现有框架足够好"的舒适区。
URL:
https://brookslybrand.com/posts/do-frameworks-matter-anymore/
> 个人觉得有点片面化,remix 脱离 react 转而用 preact 自创轮子
标签:
#编程 #Web开发 #AI编程 #前端框架 #React #软件工程 #技术趋势 #VibeCoding
总结:
这是一篇探讨在 AI 编程时代 Web 框架是否仍然重要的深度分析文章。作者 Brooks Lybrand 作为拥有三年开源框架开发经验的前端工程师,针对"模型已经足够好,框架选择不再重要"的流行观点进行了系统性反驳,论证了框架在提供抽象、结构和约束方面的核心价值,并呼吁行业继续创新和构建新框架。
文章要点:
1. **对"React 已赢"论的质疑**:作者指出当前流行观点认为由于 LLM 训练数据中 React 代码最多,模型最熟悉 React,因此无需尝试其他框架。但他认为这种逻辑存在矛盾——如果框架真的不重要,那连 React 都不需要,直接用 Web Components 或让 AI 生成原生代码即可。
2. **框架的本质价值**:作者将框架的价值精炼为三点:**提供抽象(Abstractions)、结构(Structure)和约束(Constraints)**。这些价值不仅适用于人类开发者,对 AI 编程同样关键——良好的抽象能避免 AI 重复造轮子或创建混乱的临时方案;清晰的结构帮助 AI 生成可维护的代码;明确的约束(如类型检查、测试)能防止 AI 在迭代中破坏系统。
3. **AI 时代框架的隐性存在**:引用 React 核心团队成员 Ricky Hanlon 的观点"你要么使用框架,要么构建框架",作者强调即使不显式选择框架,AI 在生成代码时也会隐式地创建框架。与其让 AI 生成一个缺乏维护、充满临时补丁的"隐性框架",不如使用经过实战检验、文档完善的开源框架。
4. **开发者体验(DX)的重构**:通过分析 HMR(热模块替换)、TypeScript 和
useEffect 等具体技术,作者说明某些传统 DX 功能对人类开发者的价值正在转变,但对 AI 编程仍至关重要。例如 TypeScript 的类型约束能有效防止 AI 在复杂应用中引入错误,而 useEffect 这类强大但易误用的抽象则应该避免让 AI 随意使用。5. **框架战争的终结与新机遇**:作者认为 2013-2024 年的"框架战争"已经结束,人们不再渴望为框架争论,但这不意味着框架不再重要。他指出当前框架领域仍存在明显不足,特别是缺乏真正全栈、基于 Web 标准、易于 AI 协作且代码可理解的 JavaScript 框架。
6. **对未来的呼吁**:尽管承认 AI 正在重塑软件开发,且没人知道其长期影响,作者仍坚持认为认为"所有问题都已解决"是一种颓废的态度。他呼吁继续构建新框架,探索更好的抽象和模式,而不是停留在"现有框架足够好"的舒适区。
URL:
https://brookslybrand.com/posts/do-frameworks-matter-anymore/
> 个人觉得有点片面化,remix 脱离 react 转而用 preact 自创轮子
《十个防止 AI 代码泛滥的前端项目护栏》
标签:
#前端 #TypeScript #React #AI编程 #代码质量 #ESLint #测试策略 #CI_CD #代码审查 #工程实践
总结:
本文针对 AI 生成代码速度远超人类审查能力的前端项目,提供了一套实用的十项防护清单。核心思路是通过自动化工具链(类型系统、Linter、变异测试、CI 门禁)在代码合并前拦截机械性错误,而非依赖人工逐行审查。
文章要点:
1. 用 OpenAPI 契约替代手写类型:通过 Hey API 等工具从 OpenAPI 规范直接生成 TypeScript 类型、客户端和 Zod 校验,避免 AI 臆造不存在的 API 字段(如
2. 开启严格 TypeScript 配置:启用
3. 把 Linter 当作行为过滤器:使用 SonarJS、react-you-might-not-need-an-effect、vitest/playwright 插件、jsx-a11y 等 ESLint 插件,自动拦截认知复杂度过高、不必要的 Effect、可访问性违规等问题。
4. 设定架构层边界:使用 eslint-plugin-boundaries 或 dependency-cruiser 强制实施分层架构(如 UI 层不得直接访问 API 层),防止 AI 生成的代码逐渐退化为"GitHub 平均水平"的混乱结构。
5. 将重复出现的错误转化为自定义 Linter 规则:当同一种 bug 第二次出现时,立即编写自定义 ESLint 规则禁止该模式。例如禁止在服务层函数中使用
6. 把规则直接喂给 AI 模型:通过项目规则文件(如
7. 用变异测试验证测试有效性:使用 Stryker 故意破坏代码(翻转运算符、反转条件、交换返回值),检查现有测试是否能捕获这些变异。存活的变异体通常暴露"只测形状不测内容"的无效测试。一个项目约 4,700 个变异体在 6 分钟内完成扫描。
8. 用 Knip 清理死代码:Knip 可以检测未使用的文件、导出和依赖,配合自定义可达性脚本填补其盲区,防止 AI 生成大量"以防万一"却无人调用的冗余代码。
9. 用 jscpd 检测重复代码:AI 倾向于在不同地方生成几乎相同的逻辑,jscpd 能发现这些重复,提示抽象机会或错误的复制粘贴。
10. 将所有检查强制设为 CI 门禁:上述所有工具(类型检查、Lint、测试、变异测试、重复检测)必须作为 CI 的强制通过项,而非可选建议,确保 AI 生成的代码无法绕过质量关卡。
11. 成本与局限:这些护栏会产生噪音(误报)、规则过时和新人上手摩擦等成本,建议按"类型 → Lint → 测试 → CI"的顺序渐进式推行。同时需注意,这些检查只能捕获机械性错误,无法识别糟糕的品味或错误的抽象。
URL:
https://evilmartians.com/chronicles/ten-anti-ai-slop-moves-for-frontend-projects-going-faster-than-humans-can-review
标签:
#前端 #TypeScript #React #AI编程 #代码质量 #ESLint #测试策略 #CI_CD #代码审查 #工程实践
总结:
本文针对 AI 生成代码速度远超人类审查能力的前端项目,提供了一套实用的十项防护清单。核心思路是通过自动化工具链(类型系统、Linter、变异测试、CI 门禁)在代码合并前拦截机械性错误,而非依赖人工逐行审查。
文章要点:
1. 用 OpenAPI 契约替代手写类型:通过 Hey API 等工具从 OpenAPI 规范直接生成 TypeScript 类型、客户端和 Zod 校验,避免 AI 臆造不存在的 API 字段(如
user.fullName),让编译器在构建期就报错。2. 开启严格 TypeScript 配置:启用
noUncheckedIndexedAccess 等严格标志,让数组索引访问返回 T | undefined,迫使代码显式处理边界情况,减少 AI 常见的"想当然"代码。3. 把 Linter 当作行为过滤器:使用 SonarJS、react-you-might-not-need-an-effect、vitest/playwright 插件、jsx-a11y 等 ESLint 插件,自动拦截认知复杂度过高、不必要的 Effect、可访问性违规等问题。
4. 设定架构层边界:使用 eslint-plugin-boundaries 或 dependency-cruiser 强制实施分层架构(如 UI 层不得直接访问 API 层),防止 AI 生成的代码逐渐退化为"GitHub 平均水平"的混乱结构。
5. 将重复出现的错误转化为自定义 Linter 规则:当同一种 bug 第二次出现时,立即编写自定义 ESLint 规则禁止该模式。例如禁止在服务层函数中使用
Math.round 和 toFixed,避免双重取整导致的薪资计算错误。6. 把规则直接喂给 AI 模型:通过项目规则文件(如
.cursor/rules、CLAUDE.md)或技能文件(如 react-doctor),将项目约定、架构决策和禁止模式直接提供给 AI,让模型在生成代码时就遵循规范。7. 用变异测试验证测试有效性:使用 Stryker 故意破坏代码(翻转运算符、反转条件、交换返回值),检查现有测试是否能捕获这些变异。存活的变异体通常暴露"只测形状不测内容"的无效测试。一个项目约 4,700 个变异体在 6 分钟内完成扫描。
8. 用 Knip 清理死代码:Knip 可以检测未使用的文件、导出和依赖,配合自定义可达性脚本填补其盲区,防止 AI 生成大量"以防万一"却无人调用的冗余代码。
9. 用 jscpd 检测重复代码:AI 倾向于在不同地方生成几乎相同的逻辑,jscpd 能发现这些重复,提示抽象机会或错误的复制粘贴。
10. 将所有检查强制设为 CI 门禁:上述所有工具(类型检查、Lint、测试、变异测试、重复检测)必须作为 CI 的强制通过项,而非可选建议,确保 AI 生成的代码无法绕过质量关卡。
11. 成本与局限:这些护栏会产生噪音(误报)、规则过时和新人上手摩擦等成本,建议按"类型 → Lint → 测试 → CI"的顺序渐进式推行。同时需注意,这些检查只能捕获机械性错误,无法识别糟糕的品味或错误的抽象。
URL:
https://evilmartians.com/chronicles/ten-anti-ai-slop-moves-for-frontend-projects-going-faster-than-humans-can-review
《Vitest 5.0 正式发布》
标签:
#前端 #JavaScript #Vitest #测试框架 #单元测试 #性能优化 #BrowserMode #MockAPI #基准测试 #断言改进 #代码覆盖率
总结:
Vitest 5.0 于 2026 年 9 月 3 日正式发布,本次大版本以性能优化为核心,同时带来 Trace View 追踪视图、嵌套项目配置、
文章要点:
1. 性能大幅提升:通过共享 Vite 服务器、稳定的文件系统模块缓存、减少主进程与 worker 往返、加速 vm 池与浏览器模式等优化,整体测试速度提升 8%–53%,大型项目(1,280 模块)运行时间从 7.24s 降至 5.83s。
2. **新增
Browser Mode 内置 Trace Viewew**:开启
嵌套项目与配置继承继承**:内联项目默认继承根配置(无需
5. **新 API
8. **Mock
9. **更严格的断言行为**:未 await 的异步断言(
10. **
11. **报告器统一输出目录**:所有报告器输出集中到
12. **其他实用改进**:新增
13. **破坏性变更**:要求 Vite >= 6.4.0 和 Node.js >= 22.12.0,升级前建议查阅迁移指南。
URL:
https://vitest.dev/blog/vitest-5
标签:
#前端 #JavaScript #Vitest #测试框架 #单元测试 #性能优化 #BrowserMode #MockAPI #基准测试 #断言改进 #代码覆盖率
总结:
Vitest 5.0 于 2026 年 9 月 3 日正式发布,本次大版本以性能优化为核心,同时带来 Trace View 追踪视图、嵌套项目配置、
vi.when 条件 Mock、基准测试重写等多项重要更新,并默认启用更严格的断言与 clearMocks 行为,要求 Vite >= 6.4.0 和 Node.js >= 22.12.0。文章要点:
1. 性能大幅提升:通过共享 Vite 服务器、稳定的文件系统模块缓存、减少主进程与 worker 往返、加速 vm 池与浏览器模式等优化,整体测试速度提升 8%–53%,大型项目(1,280 模块)运行时间从 7.24s 降至 5.83s。
2. **新增
vitest doctor 诊断工具**:自动运行替代配置并推荐更快的选项,同时默认输出性能提示,帮助用户发现配置瓶颈。Browser Mode 内置 Trace Viewew**:开启
browser.traceView 后,可记录交互、断言和 DOM 快照,支持逐步回放测试过程,便于调试 CI 失败。嵌套项目与配置继承继承**:内联项目默认继承根配置(无需
extends: true),被引用的配置文件可声明自己的 projects,支持多级嵌套结构。5. **新 API
vi.when**:支持按参数定义不同的 Mock 返回值,支持深度相等和 expect.any() 等非对称匹配器,并可限制调用基准测试 API 重写API 重写**:bench 变为测试上下文 fixture,可在常规 test() 中使用,支持 fixtures、生命周期钩子、重试和断言,结果可存储并与基线定位器错误显示 ARIA 树ARIA 树**:浏览器模式下定位失败时,同时打印 ARIA 快照和 HTML,帮助快速理解 getByRole 等查询的匹配逻辑;定位器默认启用严格模式。8. **Mock
Temporal API**:假计时器现在同时模拟 Temporal 和 Date,适用于 vi.useFakeTimers() 和 vi.setSystemTime()。9. **更严格的断言行为**:未 await 的异步断言(
resolves、rejects 等)现在会导致测试失败;expect.poll 超时后拒绝并支持 AbortSignal 取消。10. **
clearMocks 默认启用**:每个测试前自动清除 Mock 调用历史,避免测试间报告器统一输出目录。11. **报告器统一输出目录**:所有报告器输出集中到
.vitest 目录,减少 .gitignore 配置;HTML 报告器支持 singleFile 选项生成单文件报告。12. **其他实用改进**:新增
--repeats 选项重复运行测试以排查 flaky 测试;injectCjsGlobals 可禁用 CJS 全局注入;覆盖率工具切换到维护中的 @vitest/istanbuljs 包。13. **破坏性变更**:要求 Vite >= 6.4.0 和 Node.js >= 22.12.0,升级前建议查阅迁移指南。
URL:
https://vitest.dev/blog/vitest-5
《视觉回归测试:你可能还没跑起来的最重要测试》
标签:
#前端测试 #视觉回归测试 #自动化测试 #质量保证 #Web开发
总结:
文章系统介绍了视觉回归测试(Visual Regression Testing)的概念、重要性、工作原理、主流工具及实践建议。核心观点是:即使功能测试覆盖率100%,应用仍可能在视觉上"看起来完全损坏"。视觉回归测试通过截图对比基线,捕捉传统测试无法发现的视觉缺陷,在AI生成代码时代尤为重要。
文章要点:
1. 为什么视觉测试不可或缺:单元测试、集成测试和E2E测试只验证功能逻辑,不检查实际视觉呈现。CSS类名测试是代码异味,因为即使类名正确,实际渲染仍可能因样式冲突、加载失败等出问题。
2. 工作原理超直观:在真实浏览器中渲染页面/组件并截图,与基线快照对比。匹配则通过,不匹配则在CI/CD中标记失败,需人工审核确认是否为预期变更。
3. 能抓住哪些"隐形"Bug:组件一处修改意外影响其他使用位置、CSS变更导致的布局错位、响应式问题、跨浏览器渲染差异、字体/图片加载失败等。作者曾靠它避免了一个SVG图标在20处地方颜色错误的生产事故。
4. 三大主流工具怎么选:Percy(适合全页截图,与Playwright/Cypress/Puppeteer兼容,UI体验好但用量大时贵);Chromatic(Storybook生态,组件级截图,免费 tier 友好);Vitest Browser Mode(内置截图测试,但缺少审核UI,适合组件级)。
5. 接入CI/CD很轻松:通常在现有E2E测试中插入一行代码即可,如Playwright中调用
6. 避免" flaky 测试"的实用技巧:确保页面完全加载后再截图;用CSS隐藏动画区域;对动态数据(如日期、"5天前")设置忽略区域;避免对内容过多的整页盲目截图,要有选择性地测试。
7. AI时代的刚需:随着AI生成代码的普及,视觉回归测试将变得更加关键,能帮助团队快速发现AI改动带来的意外视觉副作用。
URL:
https://howtotestfrontend.com/resources/visual-regression-testing-introduction-guide
标签:
#前端测试 #视觉回归测试 #自动化测试 #质量保证 #Web开发
总结:
文章系统介绍了视觉回归测试(Visual Regression Testing)的概念、重要性、工作原理、主流工具及实践建议。核心观点是:即使功能测试覆盖率100%,应用仍可能在视觉上"看起来完全损坏"。视觉回归测试通过截图对比基线,捕捉传统测试无法发现的视觉缺陷,在AI生成代码时代尤为重要。
文章要点:
1. 为什么视觉测试不可或缺:单元测试、集成测试和E2E测试只验证功能逻辑,不检查实际视觉呈现。CSS类名测试是代码异味,因为即使类名正确,实际渲染仍可能因样式冲突、加载失败等出问题。
2. 工作原理超直观:在真实浏览器中渲染页面/组件并截图,与基线快照对比。匹配则通过,不匹配则在CI/CD中标记失败,需人工审核确认是否为预期变更。
3. 能抓住哪些"隐形"Bug:组件一处修改意外影响其他使用位置、CSS变更导致的布局错位、响应式问题、跨浏览器渲染差异、字体/图片加载失败等。作者曾靠它避免了一个SVG图标在20处地方颜色错误的生产事故。
4. 三大主流工具怎么选:Percy(适合全页截图,与Playwright/Cypress/Puppeteer兼容,UI体验好但用量大时贵);Chromatic(Storybook生态,组件级截图,免费 tier 友好);Vitest Browser Mode(内置截图测试,但缺少审核UI,适合组件级)。
5. 接入CI/CD很轻松:通常在现有E2E测试中插入一行代码即可,如Playwright中调用
percySnapshot()或Chromatic的takeSnapshot(),无需重构测试架构。6. 避免" flaky 测试"的实用技巧:确保页面完全加载后再截图;用CSS隐藏动画区域;对动态数据(如日期、"5天前")设置忽略区域;避免对内容过多的整页盲目截图,要有选择性地测试。
7. AI时代的刚需:随着AI生成代码的普及,视觉回归测试将变得更加关键,能帮助团队快速发现AI改动带来的意外视觉副作用。
URL:
https://howtotestfrontend.com/resources/visual-regression-testing-introduction-guide
《你的模块在骗你:ESM 与 CommonJS 的本质差异与陷阱全解析》
标签:
#JavaScript #NodeJS #ESM #CommonJS #模块系统 #前端工程化
总结:
本文深入剖析了 ESM 和 CommonJS 两种模块系统在底层机制上的根本差异——ESM 通过"活绑定"(live bindings)在模块间共享变量引用,而 CommonJS 通过
文章要点:
1. 活绑定 vs 值复制:最经典的陷阱 — ESM 的
2. ESM 的导入会被提升,CommonJS 按执行顺序 — ESM 静态导入在模块体执行前就已经解析、链接并评估依赖,所以
3. 两种系统有独立的缓存 — ESM 和 CommonJS 各自维护自己的模块缓存,URL 查询参数(如
4. 循环依赖的处理方式天差地别 — CommonJS 允许在模块未完全初始化时就返回
5. 跨系统互操作的隐藏复杂性 — ESM 导入 CJS 时,
6. 双包实例风险(Dual-Package Hazard) — 当
7. 发布库的最佳实践 — 用
8. 调试模块问题的检查清单 — 从导入文件的格式、解析到的入口点、返回值形状、本地变量持有的是绑定还是副本、评估是否完成、是否存在循环依赖、模块身份是否一致、是否经过构建工具转换、是否通过打包后的 tarball 测试等 9 个维度系统排查。
9. 九条实践规则 — 新项目优先用 ESM;库优先用命名导出;可变导出视为共享进程状态;CJS 属性会变时保留对象而非解构;移除循环依赖而非绕开;条件/延迟加载用动态
URL:
https://blog.gaborkoos.com/posts/2026-08-14-Your-Modules-Are-Lying-to-You/
标签:
#JavaScript #NodeJS #ESM #CommonJS #模块系统 #前端工程化
总结:
本文深入剖析了 ESM 和 CommonJS 两种模块系统在底层机制上的根本差异——ESM 通过"活绑定"(live bindings)在模块间共享变量引用,而 CommonJS 通过
module.exports 返回一个普通值(通常是对象)。这一差异导致了同名导入在两种系统下行为截然不同:ESM 的命名导入能观察到导出模块的变量重新赋值,CommonJS 的解构赋值则只复制了属性的当前值。文章进一步系统讲解了评估顺序、缓存机制、循环依赖处理、跨系统互操作、双包实例风险等关键话题,并提供了 9 条实践规则和调试清单。文章要点:
1. 活绑定 vs 值复制:最经典的陷阱 — ESM 的
import { status } 是活绑定,导出模块重新赋值后导入方自动看到新值;CommonJS 的 const { status } = require() 是解构赋值,只复制了对象属性的当前值,后续变化不可见。只有保留整个对象 const state = require() 才能观察到属性变更。2. ESM 的导入会被提升,CommonJS 按执行顺序 — ESM 静态导入在模块体执行前就已经解析、链接并评估依赖,所以
import 写在代码中间也不影响执行顺序;CommonJS 的 require() 是普通函数调用,走到哪行才执行哪行。3. 两种系统有独立的缓存 — ESM 和 CommonJS 各自维护自己的模块缓存,URL 查询参数(如
?mode=one)会让同一文件被当作不同模块实例加载两次。条件导出("import" / "require")指向不同文件时,也会产生两个独立的模块实例。4. 循环依赖的处理方式天差地别 — CommonJS 允许在模块未完全初始化时就返回
exports 对象,因此循环依赖中的模块能看到对方"半成品"状态;ESM 则先创建绑定再执行模块体,如果在初始化前读取对方绑定会抛出 ReferenceError: Cannot access before initialization。5. 跨系统互操作的隐藏复杂性 — ESM 导入 CJS 时,
module.exports 作为 default 导出最可靠,命名导出是 Node 静态分析的"快照",不会跟踪后续属性变更;CJS 通过 require() 加载 ESM 时返回的是命名空间对象,需通过 .default 访问默认导出。__esModule 只是工具链约定,不是语言特性。6. 双包实例风险(Dual-Package Hazard) — 当
"import" 和 "require" 指向不同构建文件时,同一个类会被实例化为两个不同的构造函数,instanceof 会返回 false,共享状态(如计数器、注册表)也会分裂成两份。7. 发布库的最佳实践 — 用
.mjs/.cjs 明确文件格式;package.json 中 "type" 字段决定 .js 的解析方式;相对 ESM 导入必须带文件扩展名;用 "exports" 条件导出为不同系统提供入口,但要警惕实例分裂。8. 调试模块问题的检查清单 — 从导入文件的格式、解析到的入口点、返回值形状、本地变量持有的是绑定还是副本、评估是否完成、是否存在循环依赖、模块身份是否一致、是否经过构建工具转换、是否通过打包后的 tarball 测试等 9 个维度系统排查。
9. 九条实践规则 — 新项目优先用 ESM;库优先用命名导出;可变导出视为共享进程状态;CJS 属性会变时保留对象而非解构;移除循环依赖而非绕开;条件/延迟加载用动态
import();包边界显式声明文件格式;假设不同导出目标是不同实例;通过包名而非源码路径测试。URL:
https://blog.gaborkoos.com/posts/2026-08-14-Your-Modules-Are-Lying-to-You/
《Oxlint 原生集成 React Compiler:Lint 速度提升 3 倍,Rust 工具链再进一步》
标签:
#前端开发 #React #Rust #Oxlint #性能优化 #编译器
总结:
Oxlint 在 v1.79.0 中正式原生集成了 React Compiler 的 22 条 lint 规则,无需 Babel 管道即可在 Rust 层直接运行。这意味着开发者可以在 lint 阶段就捕获 React Compiler 的 bailout(回退)情况,而 lint 任务耗时从约 29.2 秒骤降至 9.1 秒(3.2 倍加速),若去掉其他 JS 插件甚至可达 11 倍。作者强调:使用 React Compiler 时,启用全部 lint 规则是"不可争议的前提条件",因为一次 bailout 就可能导致性能严重退化(如作者主页动画卡顿)。同时,oxc 的 Rust 版 React Compiler 构建时转换也已接近可用,比原版快约 2 倍。
文章要点:
1. React Compiler 的 Rust 重写已成官方版本 — React 团队近期发布了 Rust 重写的 React Compiler,作为新的 canonical 版本。作者已在 AI 建站工具 Outlyne 中使用近一年,彻底告别手动
2. 作者已全面迁移到 oxc 生态 — Rollup → Rolldown、ESLint → Oxlint、Prettier → oxfmt、Jest → Vitest,整体工具链已 Rust 化,但 React Compiler 的 lint 插件一直是瓶颈。
3. 旧方案的痛点:Babel 管道拖慢 lint 3 倍 — 此前通过 Oxlint 的 JS 插件支持运行 React Compiler linter,需要先跑 Babel 再跑 Compiler 核心构建 AST,导致 lint 任务耗时从 9 秒暴涨到 29 秒。
4. Oxlint v1.70.0 起引入原生支持 — 新增 nursery 规则
5. 推荐配置:correctness + 枚举剩余规则 — 启用
6. 速度实测:3.2 倍到 11 倍提升 — 原生规则下 lint 从 29.2s → 9.1s;若同时去掉无原生替代的 JS 插件(如 perfectionist),可进一步降至 2.6s,实现 11 倍加速。
7. 构建时转换也在推进中 — oxc 已合并原生构建时 transform,但 Rolldown/Vite 曾因二进制体积增加 17% 而暂时回退。oxc-transform-react v0.0.1 已发布,比原版 Rust Compiler 快约 2 倍,source map 已修复,支持 fast refresh,作者已在生产环境测试。
8. 迁移门槛极低 — 只需 lint 层面改动,不影响构建步骤。可用
9. 一个常见陷阱:props 重新赋值 —
10. 作者的底线原则 — "React Compiler without linting all bailouts considered unsafe"(不 lint 所有 bailout 的 React Compiler 视为不安全)。一次 bailout 曾导致其首页动画 placeholder 卡顿、视觉破碎。
URL:
https://blog.master.dev/react-compiler-linting-just-got-a-rust-native-speedup-in-oxlint/
标签:
#前端开发 #React #Rust #Oxlint #性能优化 #编译器
总结:
Oxlint 在 v1.79.0 中正式原生集成了 React Compiler 的 22 条 lint 规则,无需 Babel 管道即可在 Rust 层直接运行。这意味着开发者可以在 lint 阶段就捕获 React Compiler 的 bailout(回退)情况,而 lint 任务耗时从约 29.2 秒骤降至 9.1 秒(3.2 倍加速),若去掉其他 JS 插件甚至可达 11 倍。作者强调:使用 React Compiler 时,启用全部 lint 规则是"不可争议的前提条件",因为一次 bailout 就可能导致性能严重退化(如作者主页动画卡顿)。同时,oxc 的 Rust 版 React Compiler 构建时转换也已接近可用,比原版快约 2 倍。
文章要点:
1. React Compiler 的 Rust 重写已成官方版本 — React 团队近期发布了 Rust 重写的 React Compiler,作为新的 canonical 版本。作者已在 AI 建站工具 Outlyne 中使用近一年,彻底告别手动
useCallback/useMemo。2. 作者已全面迁移到 oxc 生态 — Rollup → Rolldown、ESLint → Oxlint、Prettier → oxfmt、Jest → Vitest,整体工具链已 Rust 化,但 React Compiler 的 lint 插件一直是瓶颈。
3. 旧方案的痛点:Babel 管道拖慢 lint 3 倍 — 此前通过 Oxlint 的 JS 插件支持运行 React Compiler linter,需要先跑 Babel 再跑 Compiler 核心构建 AST,导致 lint 任务耗时从 9 秒暴涨到 29 秒。
4. Oxlint v1.70.0 起引入原生支持 — 新增 nursery 规则
react/react-compiler,直接在 Rust 中运行 React Compiler,无需 Babel。v1.79.0 正式发布 22 条 Compiler 驱动的规则,覆盖 React 规则的验证。5. 推荐配置:correctness + 枚举剩余规则 — 启用
correctness 类别可覆盖 12 条规则,再手动列出其余 10 条。若启用 restriction 类别则自动再纳入 5 条,suspicious 纳入 4 条,perf 纳入 1 条。6. 速度实测:3.2 倍到 11 倍提升 — 原生规则下 lint 从 29.2s → 9.1s;若同时去掉无原生替代的 JS 插件(如 perfectionist),可进一步降至 2.6s,实现 11 倍加速。
7. 构建时转换也在推进中 — oxc 已合并原生构建时 transform,但 Rolldown/Vite 曾因二进制体积增加 17% 而暂时回退。oxc-transform-react v0.0.1 已发布,比原版 Rust Compiler 快约 2 倍,source map 已修复,支持 fast refresh,作者已在生产环境测试。
8. 迁移门槛极低 — 只需 lint 层面改动,不影响构建步骤。可用
npx @oxlint/migrate 自动迁移 ESLint flat config,或让 LLM 帮忙。甚至可以先并行跑 Oxlint 和 ESLint,只替换 React Compiler 插件就能提速。9. 一个常见陷阱:props 重新赋值 —
function MyComponent({ value }) { value = value ?? fallback; } 这种写法会让整个组件被 Compiler 跳过(bailout),导致性能退化。建议用解构重命名解决,同时开启 eslint/no-param-reassign 规则。10. 作者的底线原则 — "React Compiler without linting all bailouts considered unsafe"(不 lint 所有 bailout 的 React Compiler 视为不安全)。一次 bailout 曾导致其首页动画 placeholder 卡顿、视觉破碎。
URL:
https://blog.master.dev/react-compiler-linting-just-got-a-rust-native-speedup-in-oxlint/
《TanStack AI 进入 RC 阶段:从 humble chat() 到完整 AI 生态》
标签:
#前端开发 #AI框架 #TanStack #TypeScript #开源
总结:
TanStack AI 正式从早期原型迈入 RC(Release Candidate)阶段,标志着其从一个简单的 LLM 聊天方法,成长为覆盖聊天、媒体生成、MCP、沙箱、Agent 编排等全场景的 AI 开发框架。核心设计哲学是"不锁定用户"——在传输层、提供商、前后端技术栈上都保持中立,同时通过极致的类型安全和统一的 API 模式降低学习成本。项目由三人业余时间维护,完全开源,无商业路线图。
文章要点:
1. 从小 chat() 到大生态 — 最初只有 4 个提供商和一个自定义协议,如今已支持 24+ 提供商,采用 AG-UI 官方协议(被 20+ Agent 框架跨语言支持),并扩展到媒体生成、MCP、沙箱、Agent Harness 等领域。
2. 中间件是架构的核心超能力 — 几乎所有高级功能(持久化、沙箱 Agent、内存、遥测)都以中间件形式接入 chat() 方法,Durability 则通过适配器插入流式响应。Lazy Tool Calling 用一个布尔标志就能降低 Token 成本。
3. 传输层零锁定 — 提供 SSE、WebSocket、HTTP Stream、Cap'n Web 等原生传输原语,客户端通过自定义连接适配器消费流,让你对传输层有端到端的完全控制权。
4. 一套 API 模式打遍所有模态 — 无论是文本生成、图像生成、视频生成、音频生成、转录还是实时音频,API 结构几乎完全相同。学一次模式,换适配器即可,不用学 20 套不同 API。
5. 类型安全是 DNA 级别 — 不支持的模型选项、缺少必填属性、把某提供商专属工具传给不支持的模型……统统在编译期报错。目标是让你在再复杂的应用里也能自信上线。
6. chat() 方法是全能核心 — 支持直接对话 LLM 和沙箱 Agent Harness;内置持久化与 Durability(刷新页面、切换对话后能从断点实时续流);支持 Codex 等 Agent 在远程/本地沙箱中运行;还有 Code Mode(Agent 在 isolate 中写代码并执行,优化性能和成本)。
7. 媒体生成是一等公民 — 实时音频、TTS、图像/视频/音频/音乐生成、转录等全部稳定可用,覆盖 100+ 模型。支持流式直传客户端或一次性生成,两者切换无缝。
8. RAG 与记忆 — 通过 Cohere、OpenRouter 等提供商支持嵌入和重排序;支持所有主流厂商的 Agent 记忆,让 Agent 跨对话记住用户偏好和关键事实。
9. 沙箱与 Agent Harness 不挑提供商 — 不强制你用 Daytona、E2B 或 Vercel Sandboxes,基础设施随你选。支持 Codex、Claude Code、Grok、OpenCode 等 20+ ACP 兼容 Agent,甚至能自建本地编码 Agent。
10. MCP 支持带类型生成 — 不仅能连接外部 MCP 服务器,还能通过 CLI 为远程 MCP 暴露的工具生成类型,保持端到端类型安全。支持连接池和生命周期管理。
11. 持久化与 Durability 是亮点 — 提供存储原语,你只需实现 Store 并通过一致性测试套件验证,接入持久化中间件后,用户一个月后回来也能从断点续聊。Durability 适配器可将流块持久化到内存、Durable Streams 等,用户重连后不会漏掉任何内容——全部配置约 20 行代码。
12. 未来路线图 — 核心架构已锁定,接下来重点在 Agent 工作流与编排(并行运行、定时任务、复杂工作流协调),以及继续补齐提供商生态。完全开源,无商业 upsell,欢迎社区贡献。
URL:
https://tanstack.com/blog/tanstack-ai-rc
《TanStack_Markdown与TanStack_Highlight发布:让技术文档渲染回归轻量》
标签:#前端 #TanStack #Markdown渲染 #语法高亮 #性能优化 #React #TypeScript
总结:
TanStack发布两个新库:Markdown解析器与Highlight语法高亮,专为技术博客、文档和AI流式输出设计。通过将Markdown解析与语法高亮解耦,采用轻量级AST和语义化CSS类,将文档页脚本体积从1.1MiB大幅缩减至约27KiB,彻底摆脱了对React_Server_Components的依赖,实现了"让内容回归内容"的极简渲染理念。
文章要点:
1. 痛点很真实:原来tanstack.com的文档页光是语法高亮就占了358KiB,加上Shiki、WASM、主题等,读个页面像下载小型出版系统,不得不靠RSC把负担藏到服务器端
2. 两个库分工明确:Markdown负责把内容解析成可序列化的普通数据树,Highlight负责把已知语言转成带语义CSS类的HTML,互不依赖,按需组合
3. 体积真的小:Markdown解析器仅4.9KB(gzipped),HTML渲染器约6.7KB,Highlight核心才1.7KB,25种语言全包也才8KB,零运行时依赖
4. 暗色模式超优雅:Highlight输出一套带th-语义类的HTML,主题通过CSS变量切换,不用重新高亮,明暗切换只是一次CSS操作
5. AI流式输出有新招:不用维护复杂的增量解析状态,每次收到新文本就同步重新解析,已完成块保持稳定,未完成的标题列表不会留空占位
6. 已经扛住实战考验:这两个库已全面替换tanstack.com的文档和博客渲染,测试覆盖333个真实文档fixtures,不是玩具是生产力工具
URL:https://tanstack.com/blog/introducing-tanstack-markdown-and-highlight
《Color.js:认真对待颜色这件事》
标签:#前端 #Web开发 #ColorJS #CSS_Color_Level_4 #颜色空间转换 #色域映射 #DeltaE #TreeShakeable #NPM库 #开源项目 #Lea_Verou #颜色插值
总结:
由CSS颜色规范编辑者Lea_Verou和Chris_Lilley打造的专业颜色处理库,支持Lab/LCh、OKLab/OKLCh、Display_P3等海量颜色空间,完整兼容CSS_Color_Level_4。提供真正的色域映射、多种DeltaE色差算法和色度适应方法,API清晰易用且支持链式操作。模块化设计可tree-shake,零依赖,已被Sass、Open_Props、axe等知名项目采用,NPM累计下载超2.46亿次。
文章要点:
1. 出身"正规军"——两位作者正是CSS颜色规范的编辑者,对颜色科学的理解刻在DNA里,不是随便写写的玩具库
2. 颜色空间全家桶——Lab/LCh、OKLab/OKLCh、sRGB家族、Display_P3、Jzazbz、REC.2100等统统支持,转换随心所欲
3. 科学严谨不糊弄——真正的色域映射而非粗暴裁剪,多种DeltaE色差计算和色度适应算法,专业度拉满
4. API好用又灵活——面向对象+静态函数双模式,链式操作丝滑流畅,还能按需引入模块做tree-shake,包体积可控
5. 业界认可度超高——浏览器用它测试CSS_Color_4/5实现,Sass、Open_Props、axe都在用,NPM下载量突破2.46亿
6. 生态还在扩张中——除了核心库,还在孵化Color_Elements网页组件、Color_Apps工具集和Color_Palettes配色研究项目
URL:https://colorjs.io
《前端框架基准测试平台》
标签:#前端 #Web开发 #FrameworkBenchmarks #PerformanceTesting #JavaScriptFrameworks #React #Vue #Svelte #SolidJS #Preact #Qwik #Lit #Angular #BundleSize #BuildTime #LighthouseScores #HMR #NPMStats #StackMatch
总结:
这是一个全自动化的前端框架基准测试平台,由开发者Alicia Sykes维护。项目用同一个天气应用在React、Vue、Svelte等12+个主流框架中实现,每晚自动跑分对比包体积、Lighthouse评分、加载速度、CPU内存占用、构建时间及HMR热更新速度。还整合了GitHub和NPM社区数据,并自带Stack Match智能推荐工具。所有原始数据开源可下载,帮你告别选型纠结!
文章要点:
1. 同一个天气应用,12+种框架实现——React、Vue、Svelte、Solid.js、Qwik、Lit等主流选手全部到场,公平对决
2. 每晚自动跑分,数据新鲜出炉——包体积、Lighthouse性能分、FCP/LCP/TTI加载指标、CPU内存占用、构建时间、HMR速度全覆盖
3. 社区数据一目了然——GitHub Stars、NPM月下载量、依赖数量、维护者人数、TS支持情况、许可证信息全整理好了
4. 自带Stack Match智能推荐工具——填填项目偏好,就能get最适合你的框架,选型不再拍脑袋
5. 完全开源透明——所有原始数据以JSON格式开放下载,测试用Playwright统一验证,结果可信可复现
URL:[https://framework-benchmarks.as93.net/](https://framework-benchmarks.as93.net/)
《React Suspense 边界触发机制与实战用法》
标签:#前端 #React #Suspense #LazyLoading #StreamingRendering #ViewTransition
总结:
React Suspense 边界在组件树中充当"加载守门员",当子组件通过
文章要点:
1. Suspense 不是万能检测器,它只捕获渲染阶段的挂起行为——Effect 或事件里的数据请求不会触发边界,得用
2. 七大触发场景一览:懒加载组件代码、Promise 数据读取、带 precedence 的样式表、流式 SSR 的大块 HTML、ViewTransition 期间的字体与图片加载、以及实验性的
3. 嵌套边界能打造"加载阶梯":外层骨架屏先撑住,内层内容逐层揭晓,避免整页白屏,还能让设计师的 loading 状态稿直接落地
4.
5. 配合
6. 服务端容错兜底:流式 SSR 里组件抛错不会崩掉整个渲染,React 会找到最近的 Suspense 边界,把 fallback 塞进 HTML,客户端再尝试 hydrate
7. 资源协调全家桶:ViewTransition 动画期间,Suspense 能同时等待数据、样式、字体、图片全部就位,让过渡动画开场就是完整画面,告别"先丑后美"的闪烁
URL:https://react.dev/reference/react/Suspense#what-activates-a-suspense-boundary
标签:#前端 #React #Suspense #LazyLoading #StreamingRendering #ViewTransition
总结:
React Suspense 边界在组件树中充当"加载守门员",当子组件通过
lazy 懒加载、用 use 读取 Promise、或加载带 precedence 的样式表时,边界会优雅地切换到 fallback UI。它与流式服务端渲染、ViewTransition 动画深度整合,还能配合 startTransition 避免已显示内容被强制替换,让加载体验从"闪屏"变成"渐进式揭晓"。文章要点:
1. Suspense 不是万能检测器,它只捕获渲染阶段的挂起行为——Effect 或事件里的数据请求不会触发边界,得用
use 读取 Promise 或框架封装才行2. 七大触发场景一览:懒加载组件代码、Promise 数据读取、带 precedence 的样式表、流式 SSR 的大块 HTML、ViewTransition 期间的字体与图片加载、以及实验性的
defer CPU 密集型渲染3. 嵌套边界能打造"加载阶梯":外层骨架屏先撑住,内层内容逐层揭晓,避免整页白屏,还能让设计师的 loading 状态稿直接落地
4.
startTransition 是保屏神器:导航更新时标记为非紧急,React 会"忍一忍"新内容的挂起,不让已显示的 Layout 被 fallback 粗暴顶掉5. 配合
key 重置边界:切到不同用户资料时,给边界加 key 能让 React 识别为新内容,自动清掉旧状态,避免"张冠李戴"的残留显示6. 服务端容错兜底:流式 SSR 里组件抛错不会崩掉整个渲染,React 会找到最近的 Suspense 边界,把 fallback 塞进 HTML,客户端再尝试 hydrate
7. 资源协调全家桶:ViewTransition 动画期间,Suspense 能同时等待数据、样式、字体、图片全部就位,让过渡动画开场就是完整画面,告别"先丑后美"的闪烁
URL:https://react.dev/reference/react/Suspense#what-activates-a-suspense-boundary
《让React Compiler接管Memoization后,我踩了哪些坑》
标签:#前端 #React #ReactCompiler #Memoization #NextJS #ReactHookForm
总结:
作者在生产级Next.js项目中启用React Compiler v1.0的真实踩坑记录。编译器确实能自动处理大部分memoization,但"大部分"这个词背后藏着不少陷阱:React Hook Form的
文章要点:
1. React Compiler的本质是Babel插件:它通过为每个组件预分配扁平缓存数组(内部hook
2. React Hook Form的
3. 有些
4. DevTools的Memo徽章会误导你:徽章只表示编译器"处理过"该组件,不代表优化成功。即使组件违反React规则(如直接修改props),徽章依然可能出现,真正没徽章的只有显式加了
5. 迁移有明确的正确顺序:先升级eslint-plugin-react-hooks到v7+并修复lint错误,再在feature分支启用编译器,最后用Profiler和E2E测试验证,不要依赖Memo徽章作为正确性信号
URL:https://blog.logrocket.com/react-compiler-memoization-what-actually-broke/
标签:#前端 #React #ReactCompiler #Memoization #NextJS #ReactHookForm
总结:
作者在生产级Next.js项目中启用React Compiler v1.0的真实踩坑记录。编译器确实能自动处理大部分memoization,但"大部分"这个词背后藏着不少陷阱:React Hook Form的
watch()因内部可变状态导致实时预览冻结;Chart.js的点击处理器在移除useCallback后出现数据过时问题;DevTools的Memo徽章仅表示组件被"处理"而非"成功优化"。核心结论是:迁移不是一键操作,需要先升级eslint-plugin-react-hooks、在feature分支启用、用E2E测试覆盖,并保留那些跨越React边界的显式hook。文章要点:
1. React Compiler的本质是Babel插件:它通过为每个组件预分配扁平缓存数组(内部hook
_c)来实现比手写useMemo更细粒度的自动memoization,让你可以删掉大部分显式hook2. React Hook Form的
watch()直接翻车:启用编译器后,表单的实时预览完全冻结,原因是RHF依赖内部可变状态,编译器无法安全memoize。解决方案是用"use no memo"指令包裹useForm的调用3. 有些
useCallback真的删不得:Chart.js的点击处理器在移除useCallback后,高并发下偶尔引用旧数据。这不是编译器bug,而是编译器的memoization节奏与外部库(按引用注册回调)的预期不一致,最终选择保留useCallback并加注释说明4. DevTools的Memo徽章会误导你:徽章只表示编译器"处理过"该组件,不代表优化成功。即使组件违反React规则(如直接修改props),徽章依然可能出现,真正没徽章的只有显式加了
"use no memo"的组件5. 迁移有明确的正确顺序:先升级eslint-plugin-react-hooks到v7+并修复lint错误,再在feature分支启用编译器,最后用Profiler和E2E测试验证,不要依赖Memo徽章作为正确性信号
URL:https://blog.logrocket.com/react-compiler-memoization-what-actually-broke/
《关于SourceMap你需要知道的一切》
标签:#前端 #SourceMap #Vite #NextJS #Webpack #安全 #CI_CD
总结:SourceMap是前端开发中用于将压缩后的代码映射回原始代码的JSON文件,能极大提升调试体验。但文章重点警示了其安全隐患——默认配置下SourceMap会内联完整源代码,若不慎部署到生产环境,任何人都能通过浏览器或curl获取你的原始代码、目录结构甚至敏感信息。文章以Apple和Anthropic的泄露事件为例,详细说明了如何正确配置构建工具、设置服务器规则以及在CI/CD中自动化检测,防止源代码泄露。
文章要点:
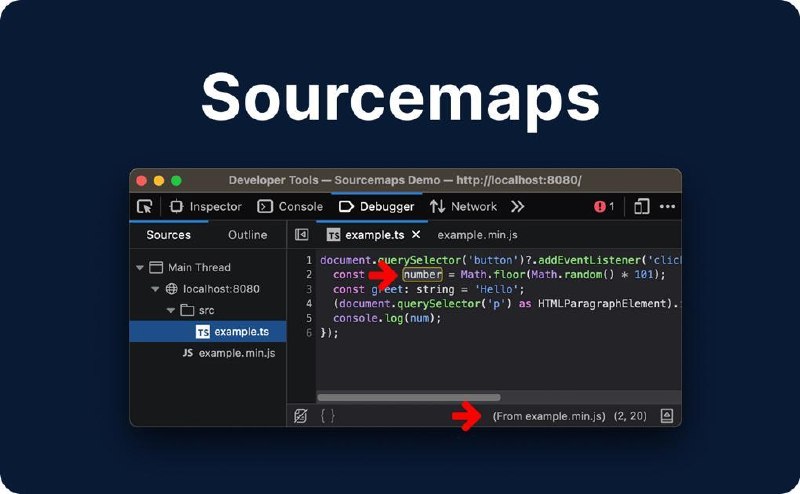
1. SourceMap本质上是一个JSON文件,包含sources(原始文件路径)、names(原始变量名)、mappings(位置映射)和sourcesContent(完整源代码)四个关键字段,能将压缩后的代码精准还原
2. 构建流程通常是TypeScript编译→JS代码→压缩混淆,而SourceMap则反向执行这个流程,让浏览器DevTools能显示原始代码和变量名
3. 最大的安全风险在于sourcesContent默认会内联完整源代码,泄露后不仅暴露目录结构和模块名,还可能泄露API密钥、端点信息和未发布的功能开关
4. Apple在2025年11月因部署SourceMap到生产环境导致App Store前端源码泄露;Anthropic在2026年3月因npm包包含59.8MB的SourceMap文件,导致Claude Code核心代码被永久镜像传播
5. 防护措施包括:构建工具关闭生产环境SourceMap(Vite设sourcemap:false,NextJS设productionBrowserSourceMaps:false)、使用hidden模式仅上传错误追踪平台、服务器对.map请求返回404
6. 建议在CI/CD中添加自动化检查脚本,扫描输出目录中的.map文件,若包含sourcesContent则中断构建,从源头杜绝人为疏忽导致的泄露
URL:https://neciudan.dev/everything-you-need-to-know-about-sourcemaps
《用 Web Components 构建框架无关的设计系统(实践指南)》
标签:#前端 #WebComponents #设计系统 #Elena #VitePress #CSS #无障碍
总结:
本文是一份超详细的实战教程,手把手教你用 Web Components(通过 Elena 库)和 VitePress 搭建一个框架无关、可发布的设计系统。核心思路是"最低可行层级"——用 web 标准直接写原子组件,避免框架锁定;组件保持"最笨"状态,把复杂业务逻辑留给应用层。文章涵盖 monorepo 结构搭建、Elena 组件脚手架、条件渲染、@scope 样式隔离、CSS 自定义属性主题化,以及通过 JSDoc + Custom Elements Manifest 自动生成 Props 表格的文档工作流。最终产出的是一个可独立发布的组件包 + 可部署的静态文档站。
文章要点:
1. 设计系统从第一天就绑定特定框架(如 React)是"令人费解的"——web 标准组件才是可移植、可组合、经得起时间考验的选择
2. Elena 是"刚好够用的抽象":处理跨框架的 prop/attribute 同步、事件委托等脏活,但不掩盖 web 标准本质
3. 组件应保持"最笨"——被告知显式状态和内容的声明式组件,比内置复杂状态管理的"聪明"组件更健康
4. 设计决策应该在代码中而非 Figma 中完成:现代色彩空间、相对单位、对数排版比例等,设计工具只能模拟浏览器的很小一部分能力
5. 用 @scope 实现样式隔离 + 组件级 CSS 自定义属性作为"最终层 token",既保证封装又有主题化回退
6. JSDoc 注释即文档:Elena 自动生成 custom-elements.json,VitePress 通过 data loader 直接渲染 PropsTable 和 ComponentHeader
7. 文档即测试场:在 VitePress 中实时预览组件,确保跨框架可移植性;开发时 concurrent 运行 watch + docs:dev 实现热更新
8. 条件渲染示例:同一个组件通过 href prop 自动切换 button/a 标签,CTA 链接按钮的常见需求也能语义化实现
URL:https://piccalil.li/blog/framework-agnostic-design-systems-part-1/
《别在 div 和 span 上乱加 aria-label》
标签:#前端 #Web无障碍 #ARIA #屏幕阅读器 #HTML语义化
总结:
本文通过实测数据揭示了在 div、span 等 generic 角色元素上使用 aria-label 的严重兼容性问题。ARIA 规范明确禁止为 generic 角色命名,而各屏幕阅读器的表现更是天差地别——有的只读标签、有的只读内容、有的两者都读、有的干脆忽略。这种不一致会让依赖辅助技术的用户获得错误信息,属于典型的"好心办坏事"。作者指出 section 和 popover 是例外,前者加标签会自动升级为 region 地标,后者角色会变为 group。
文章要点:
1. ARIA 规范 5.2.8.6 明确把 generic 角色列入"禁止命名"清单,div 和 span 默认就是这个角色
2. 实测 8 组屏幕阅读器+浏览器组合,对带 aria-label 的 div announcement 结果五花八门:VoiceOver 读"News, group"、TalkBack 只读"News"、JAWS/NVDA 完全忽略标签只读内容
3. 空 div 的测试结果更混乱,有的读"News, empty group"、有的完全静默,无法预测用户会听到什么
4. 这种不可预测性对屏幕阅读器用户是灾难性的——你以为在帮忙标注,实际上可能覆盖了真正有用的内容
5. 例外情况:section 元素加 aria-label 会自动从 generic 升级为 region 地标,这是规范允许的;带 popover 属性的 div 角色会变为 group,加标签也合法
6. 正确做法:需要可访问名称时,优先使用语义化标签(如 button、nav)或显式设置 role,而不是在裸 div 上硬塞 aria-label
URL:https://www.matuzo.at/blog/2026/aria-label-generic-elements
《Chrome DevTools MCP v1 发布:为 AI 编码代理赋予浏览器调试超能力》
标签:#前端 #AI_Tools #Chrome_DevTools #MCP #Browser_Automation #Performance_Debugging
总结:
Chrome 团队正式发布 DevTools MCP v1,通过 Model Context Protocol 将 Chrome DevTools 的完整调试能力开放给 AI 编码代理。它让 Claude、Cursor、Copilot 等 AI 助手能够实时控制浏览器、抓取性能 trace、分析网络请求、检查控制台日志,甚至处理 1500 万行级别的性能数据,从而把"盲写代码"的 AI 变成能看、能测、能调优的闭环调试器。
文章要点:
1. 告别盲写时代:以前 AI 编码代理只能凭空推理代码,无法看到实际渲染效果。DevTools MCP 直接给 AI 装上"眼睛",让它能截图、查 DOM、读控制台、抓网络请求,基于真实浏览器状态做判断。
2. 40+ 工具全覆盖:从点击、填表、导航等自动化操作,到性能 trace 录制、Lighthouse 审计、内存堆快照、网络请求分析,几乎把 DevTools 面板的能力完整暴露给了 AI。
3. 性能分析是杀手锏:Paul Irish 演示了如何处理 1500 万行 JSON 的复杂性能 trace,MCP 服务器会解析并提炼出关键洞察,让 AI 帮你做原本需要资深性能专家才能完成的初步诊断。
4. 接入零门槛:支持 Claude Code、Cursor、Copilot、Gemini CLI、VS Code 等主流工具,一条 npx 命令即可启动,还能自动连接本地已运行的 Chrome 实例,无需额外配置。
5. 架构扎实可靠:底层基于 Chrome DevTools Protocol 和 Puppeteer,自动化操作自带智能等待,避免 flaky;同时支持 headless 和有头模式,适应不同场景需求。
URL:https://developer.chrome.com/blog/devtools-for-agents-v1
《Storybook 10.4 发布》
标签:#前端 #DevTools #Storybook #React #TanStackReact #ReactNative #AIAgent #MCP
总结:
Storybook 10.4 聚焦 AI 辅助开发与团队协作提效。AI Agent 现在能自动完成复杂项目的初始化、Mock 配置、Stories 编写与测试验证;侧边栏新增变更检测过滤器,帮你秒速锁定受代码改动影响的组件;一键分享让非技术成员无需等待 PR 或 CI 就能即时查看工作进度。此外还带来 TanStack React 官方支持、React Native 隔离优化,以及实验性的 React Component Meta 分析器,组件识别率达 100%,热更新速度最高提升 81 倍。
文章要点:
1. AI 全自动配置:只需一句 Prompt,AI Agent 就能分析项目结构、生成 Storybook 配置、编写 MSW Mock 和交互测试,并自动验证渲染效果。已在 Excalidraw、Bluesky 等复杂项目验证可行。
2. 侧边栏变更检测:新增 New、Modified、Related 三种过滤器,帮你秒速锁定代码变更波及的所有 Stories,特别适合 AI 生成代码后的快速审阅。
3. 一键云端分享:点击 Share 按钮即可将当前 Storybook 发布到 Chromatic,设计师和产品经理不用等 PR 或 CI,点开链接就能直接看效果、提反馈。
4. TanStack React 官方支持:全新 @storybook/tanstack-react 包,零配置接入类型安全路由与 Server Functions,由 Storybook 与 TanStack 核心团队联合打造。
5. React Native 隔离升级:新增独立应用入口,通过环境变量自动切换,Storybook 代码与业务代码完全隔离,零配置起步且向后兼容。
6. React Component Meta 实验特性:基于 Volar 和 TS Language Server 的新一代 Docgen,组件检出率 100%,开发模式热更新比旧方案快 43 到 81 倍,为 AI 提供更精准的组件元数据。
URL:https://storybook.js.org/blog/storybook-10-4/
《Orval:从OpenAPI规范自动生成类型安全客户端代码》
标签:#前端 #全栈 #OpenAPI #TypeScript #CodeGeneration #ReactQuery #Swagger #APIClient
总结:
Orval 是一个代码生成工具,能读取 OpenAPI v3 或 Swagger v2 规范(支持 yaml 和 json 格式),自动生成带完整 TypeScript 类型签名的客户端代码。它支持 React Query、SWR、Vue Query、Svelte Query、Solid Query、Angular、Hono、Zod、原生 fetch 和 MCP 等多种框架与库,同时还能生成模型、请求函数、Hooks 和 Mock 数据。项目提供在线 Playground 快速体验,开发时使用 Bun 构建,社区活跃且有赞助支持。
文章要点:
1. Orval 的核心能力是从 OpenAPI / Swagger 文档一键生成类型安全的 TS 客户端,告别手写接口代码的繁琐工作
2. 生态支持非常全面,覆盖了 React、Vue、Svelte、Solid、Angular 等主流前端框架,还有 React Query、SWR 等数据获取方案
3. 不只是生成请求函数,还能顺带产出数据模型(Models)、React Hooks、以及用于测试的 Mock 数据,一条龙服务
4. 项目内置了在线 Playground,不用安装就能上手体验,对新手和想快速验证的同学很友好
5. 开发侧使用 Bun 作为包管理工具,测试流程完善,包含单元测试、快照测试和 CLI 验证
URL:https://github.com/orval-labs/orval
